
一项看似基础的数学计算问题,可能影响大规模模型训练的稳定性。Google DeepMind 研究人员发现,长期广泛使用的 Softmax 和交叉熵实现,在特定浮点精度条件下会产生错误梯度。更值得关注的是,Gemini 不仅参与了问题发现,还承担了实验验证和论文撰写等工作。
2026年10月下旬,Google DeepMind 研究人员 Jonathan T. Barron、Dan Gnanapragasam 和 Michael Tschannen 在 arXiv 发布论文《Fixing Softmax and Cross‑Entropy》。论文指出,深度学习中两个几乎无处不在的基础运算——Softmax 和交叉熵(Cross‑Entropy)——在常见实现方式中存在两个隐蔽的数值精度问题。
这些问题并不是传统意义上的数学公式错误,而是数学上等价的计算表达式,在计算机有限精度的浮点运算中产生了不同结果。它们在普通训练过程中可能很难察觉,但当模型预测变得极度自信,或者学生模型已经非常接近教师模型时,细微的舍入误差就可能改变梯度,进而影响优化过程。
一、两个基础函数为什么会出现数值漏洞?
要理解这项研究,首先需要了解 Softmax 和交叉熵在神经网络训练中的作用。
Softmax 将模型输出的 Logits 转换为概率分布,交叉熵则衡量模型预测与目标分布之间的差异。两者结合,构成了分类模型和大语言模型训练中最常见的损失计算路径之一。
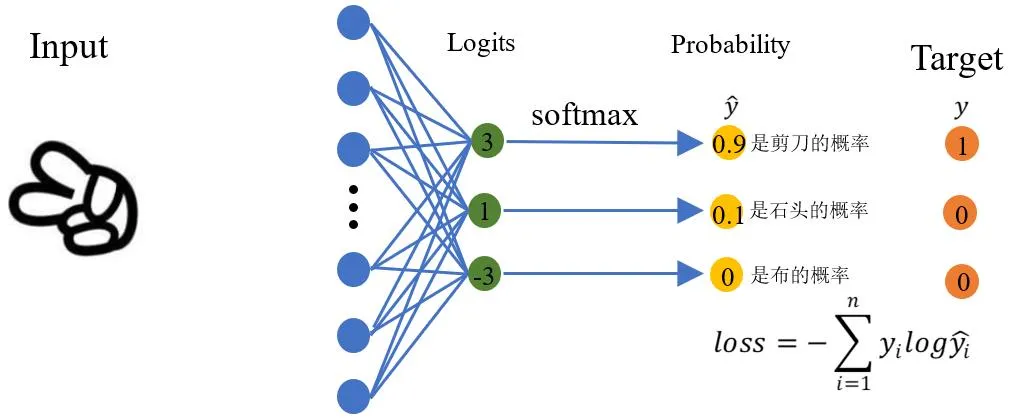
理论上,Softmax 的计算形式为:
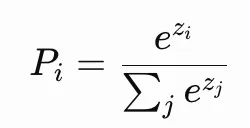
其中,Zi是模型输出的 Logit,Pi 是对应类别的预测概率。为了避免指数运算溢出,工程实现通常会先减去最大 Logit,再进行指数运算。
这是一种数学上等价、数值上通常更稳定的做法。然而,研究人员发现,即使采用这种常见技巧,在浮点数精度有限的情况下,仍然可能出现两个问题。
1. Softmax Collapse:正确类别的梯度意外归零
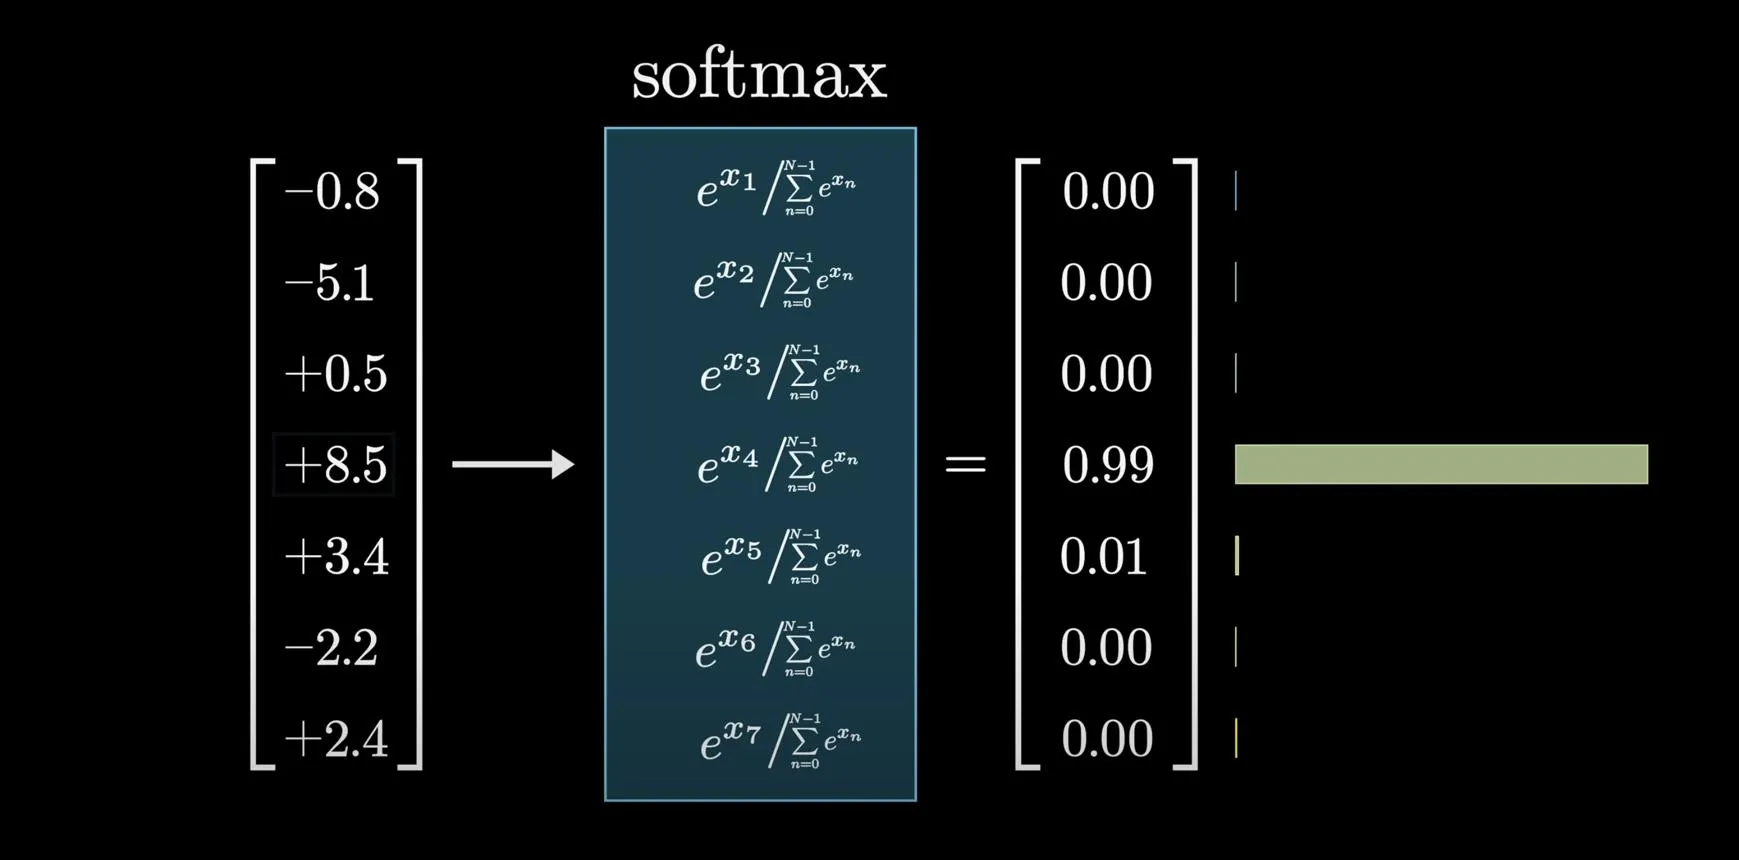
当模型训练到一定阶段,对正确类别的预测可能变得极度自信,概率接近 1,而其他类别的概率接近 0。
问题在于,浮点数并不能无限精确地表示接近 1 的数值。当计算结果与 1 之间的差异小于当前数据类型能够表示的精度时,这个差异就可能被直接舍入掉。
例如,在论文讨论的特定计算条件下,bfloat16 和 float32 都可能在 Logit 差值达到一定程度后出现这种现象。
结果是,正确类别对应的梯度可能被计算为 0,而错误类别对应的梯度却仍然存在。这破坏了 Softmax 梯度应当满足的数学性质,也可能让优化器收到不一致的更新信号。
这种异常还可能与训练过程中观察到的损失突然波动、优化不稳定等现象有关。研究特别讨论了所谓的 Slingshot Effect(弹弓效应)。
需要强调的是,这并不意味着所有使用 bfloat16 或 float32 的模型都会发生这种问题。它取决于具体的 Logit 分布、计算路径和数值精度。
2. Softmax Cancellation:模型已经接近正确答案,却仍然产生错误梯度
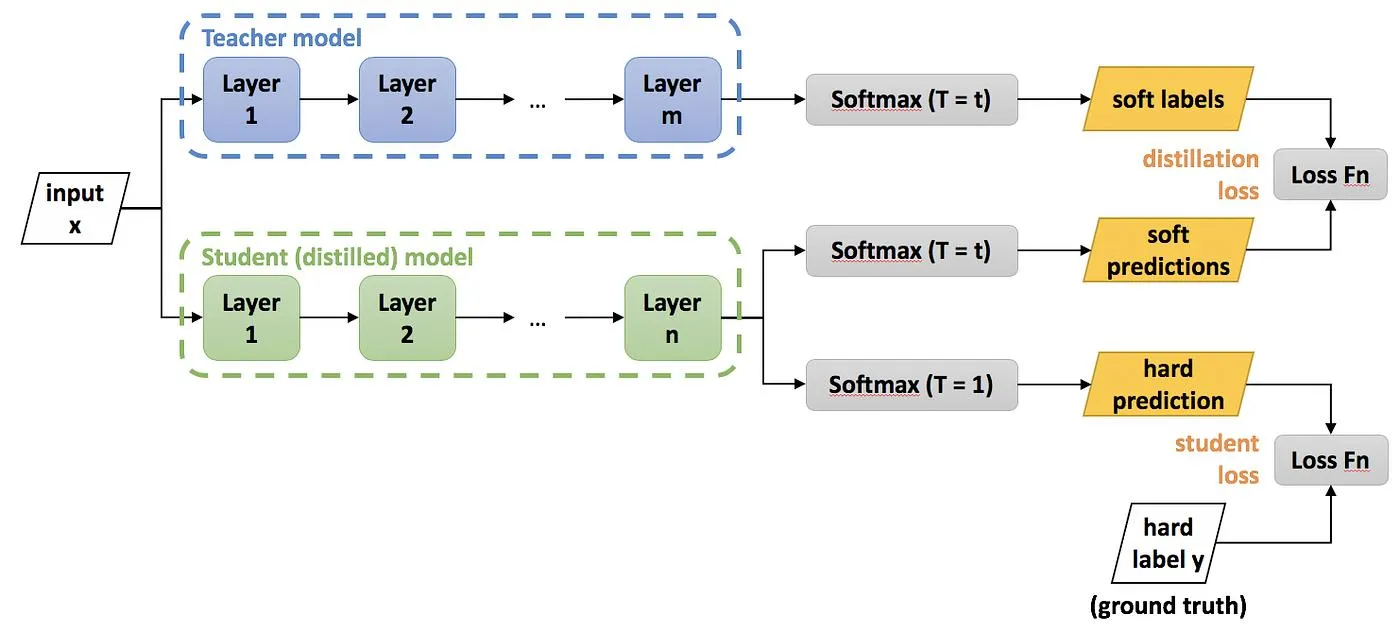
第二个问题主要出现在知识蒸馏(Knowledge Distillation)中。
知识蒸馏的基本思路是让一个较小的学生模型学习教师模型输出的概率分布,而不仅仅是学习最终的正确标签。
理想情况下,当学生模型的输出已经与教师模型完全一致时,损失应当达到最小值,梯度也应当为零。
但研究人员发现,标准计算方式在某些情况下会因为浮点数舍入误差,产生本不应该存在的非零梯度。
这意味着学生模型明明已经接近教师模型,优化器却仍然收到一个错误的更新方向,使学生模型反而偏离教师模型。
对于依赖知识蒸馏进行模型压缩、能力迁移和后训练的系统而言,这种误差尤其值得关注。
二、问题根源:数学等价不代表计算机中的结果等价
这项研究最有价值的地方,在于它揭示了一个经常被工程实践忽略的事实:数学公式正确,并不意味着它在有限精度的计算机环境中一定能够得到正确的数值结果。
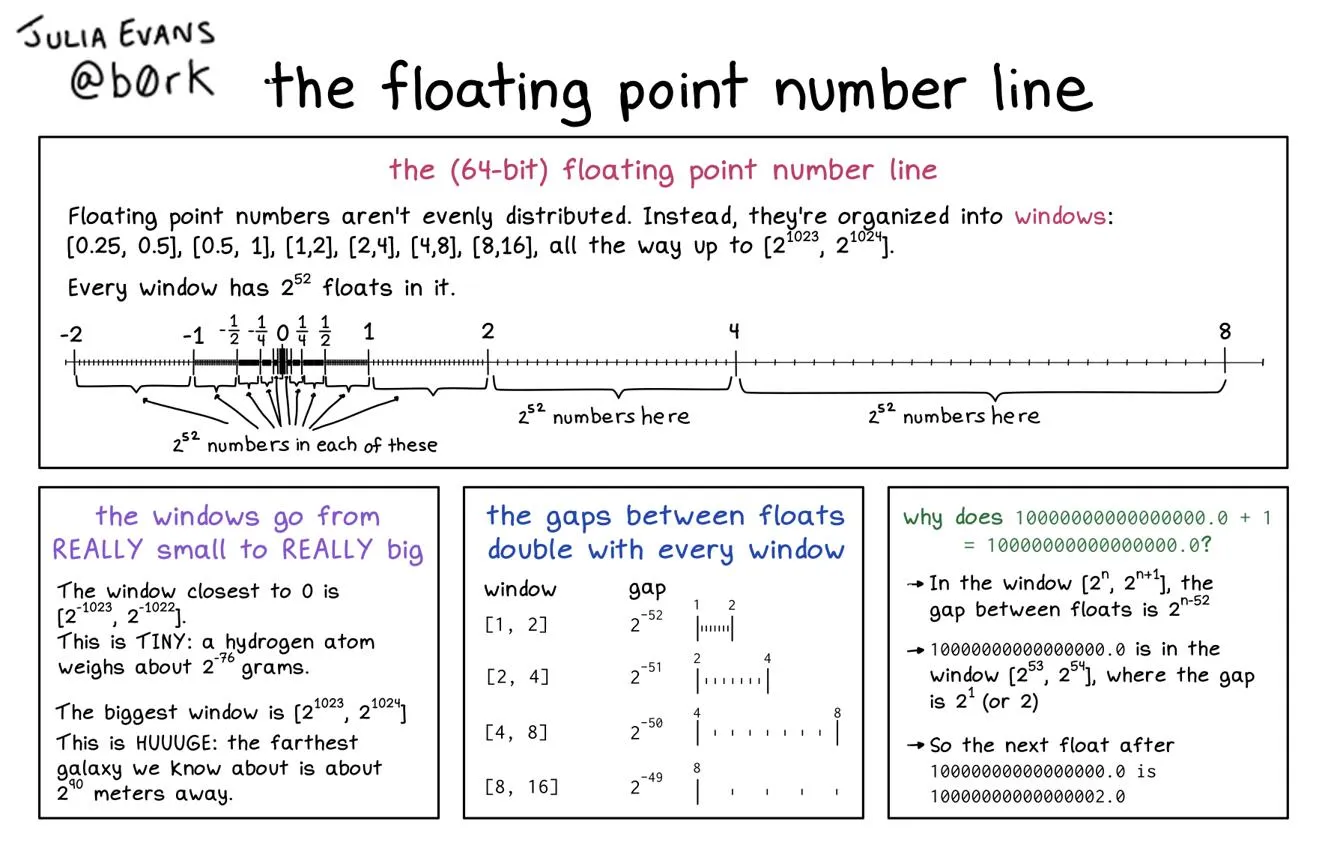
浮点数使用有限的位数表示实数,因此无法精确表示所有数值。尤其是在接近 1.0 的区域,两个数学上不同的数值可能在低精度格式中被舍入为相同的结果。
这会带来两个后果:
第一,原本非常小但真实存在的梯度可能被舍入为零。
第二,两个本应相互抵消的数值在计算过程中可能因为舍入顺序不同而留下误差。
这也解释了为什么相同的数学公式,在不同的数据类型、计算顺序和硬件环境下,可能产生不同的训练结果。
随着大语言模型越来越多地使用 bfloat16、FP16,以及部分场景中的 FP8 等低精度计算格式,这类问题的重要性也在上升。
三、Gemini 不只是辅助写代码,而是参与了问题发现
这项研究另一个引人关注的地方,是 Gemini 在研究过程中的角色。
根据论文作者 Jonathan T. Barron 的公开说明:
- 问题发现: Softmax Cancellation 最初由 Gemini Flash 3.7 发现,并提出了修复方案。
- 实验验证: 论文中的大部分实验由 Gemini Flash 3.8 完成。
- 论文撰写: Gemini 4 Argon 参与撰写了论文初稿和制作图表。
- 研究把关: Barron 则主要负责审查、质疑和验证研究结论,确保论文内容经得起严格检验。
如果这些分工按照作者的公开说明得到准确记录,那么这就是一个很有代表性的案例:AI 不仅在帮助人类使用机器学习技术,也开始参与检查和改进机器学习本身的底层计算方法。
这里值得注意的是,Gemini 并没有取代研究人员的数学判断和实验验证。真正有意义的是,人类研究者与 AI 模型形成了一个新的研究协作流程:由模型提出问题、探索解决方案并执行大量实验,再由研究人员审查和确认结果。
四、修复方案:不需要更高精度,关键是改变计算方式
研究团队没有选择简单地提高浮点计算精度,也没有重新设计 Softmax 或交叉熵的数学定义,而是通过调整计算表达式和运算顺序,减少数值误差。
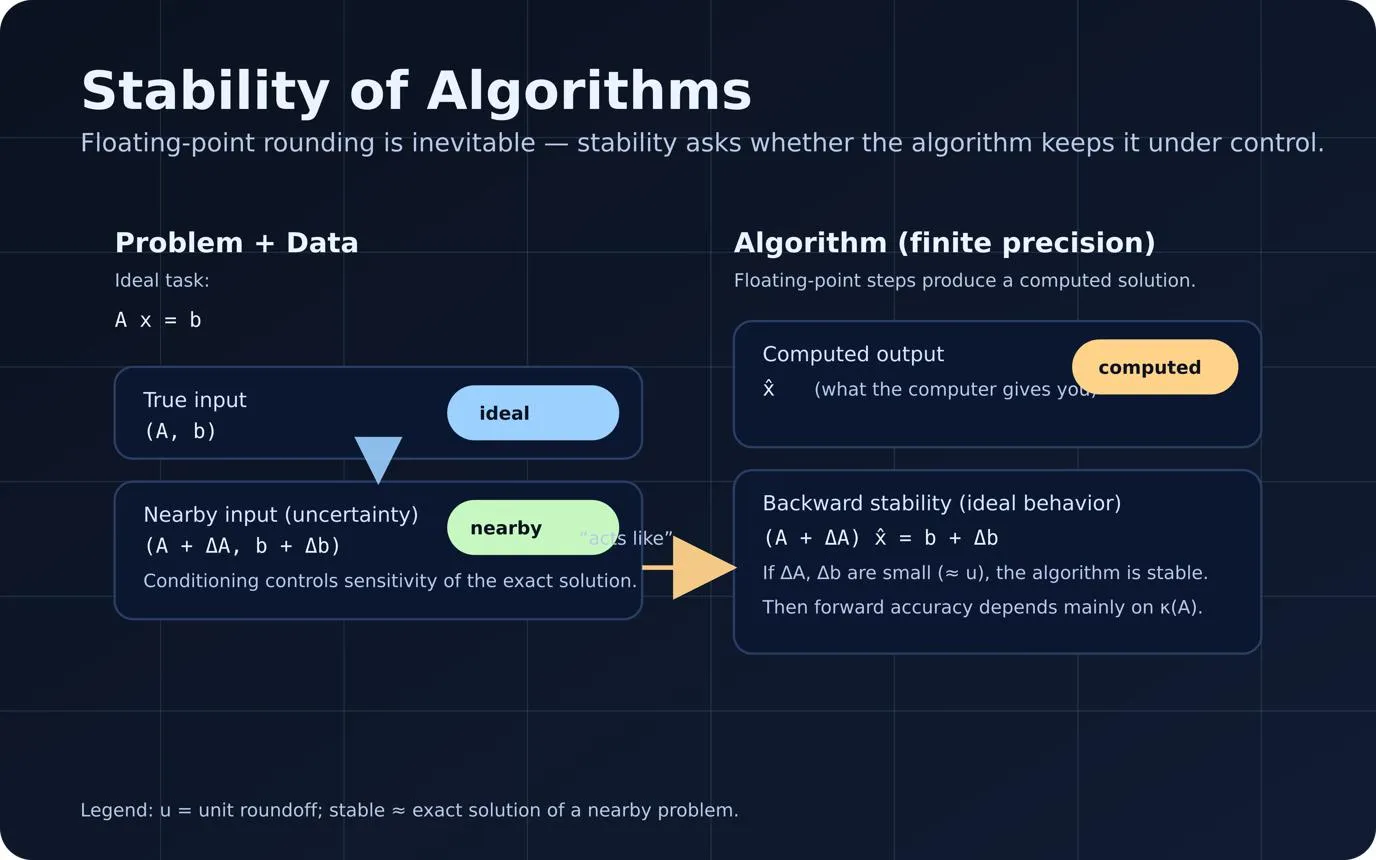
论文采用了包括 softplus、expm1 和 log1p 在内的数值稳定函数。
这些函数的共同特点,是针对特定数值范围优化计算方式,避免直接进行容易造成精度损失的运算。
例如:
expm1(x)计算 ,在 很小时比直接计算指数再减 1 更准确。log1p(x)计算 ,在 很小时可以减少有效数字损失。softplus(x)则提供了更稳定的 Softmax 相关计算表达方式。
研究团队在模加法(Modular Addition)等 Grokking 测试任务中验证了修复效果。根据论文给出的实验结果,在相关 bfloat16 测试条件下,标准实现的准确率约为 93.3%,而修复后的实现达到 100%,训练过程也更加稳定。
在知识蒸馏实验中,修复后的计算方式能够避免学生模型与教师模型完全一致时出现不应有的残余梯度。
此外,独立工程师也在 PyTorch 环境中复现了相关问题,并验证了修复方案的有效性。
五、这项研究对大语言模型意味着什么?
Softmax 和交叉熵并不是某个特定模型的专属组件,而是现代深度学习系统中的基础计算原语。尤其是在大语言模型训练中,Softmax 不仅出现在分类任务中,也直接参与模型输出概率分布的计算。
因此,这项研究的意义并不局限于修复两个函数,而是提醒整个 AI 工程领域:模型能力的提升,不仅取决于网络结构、训练数据和参数规模,也取决于底层数值计算是否足够可靠。
不过,对影响范围也需要保持客观判断。日常模型推理通常不会因为这两个问题直接受到明显影响;真正值得关注的是大规模预训练、低精度训练、知识蒸馏和特定后训练任务。至于主流框架是否会将论文中的修复方式作为默认实现,还需要观察 PyTorch、JAX、TensorFlow 等项目后续的代码更新。
六、比修复两个 Bug 更重要的变化:AI 开始反过来改进 AI
这项研究让我认为,真正值得关注的并不只是 Softmax 和交叉熵存在数值漏洞,而是 AI 研发模式可能正在发生变化。
过去,深度学习系统的开发主要依赖人类研究人员提出理论、编写代码、设计实验,再通过大量计算资源验证假设。AI 模型更多是研究对象和工具。
现在,前沿模型已经能够参与数学问题探索、代码分析、实验设计、结果比较,甚至发现研究人员长期没有注意到的底层问题。
这形成了一种新的闭环:
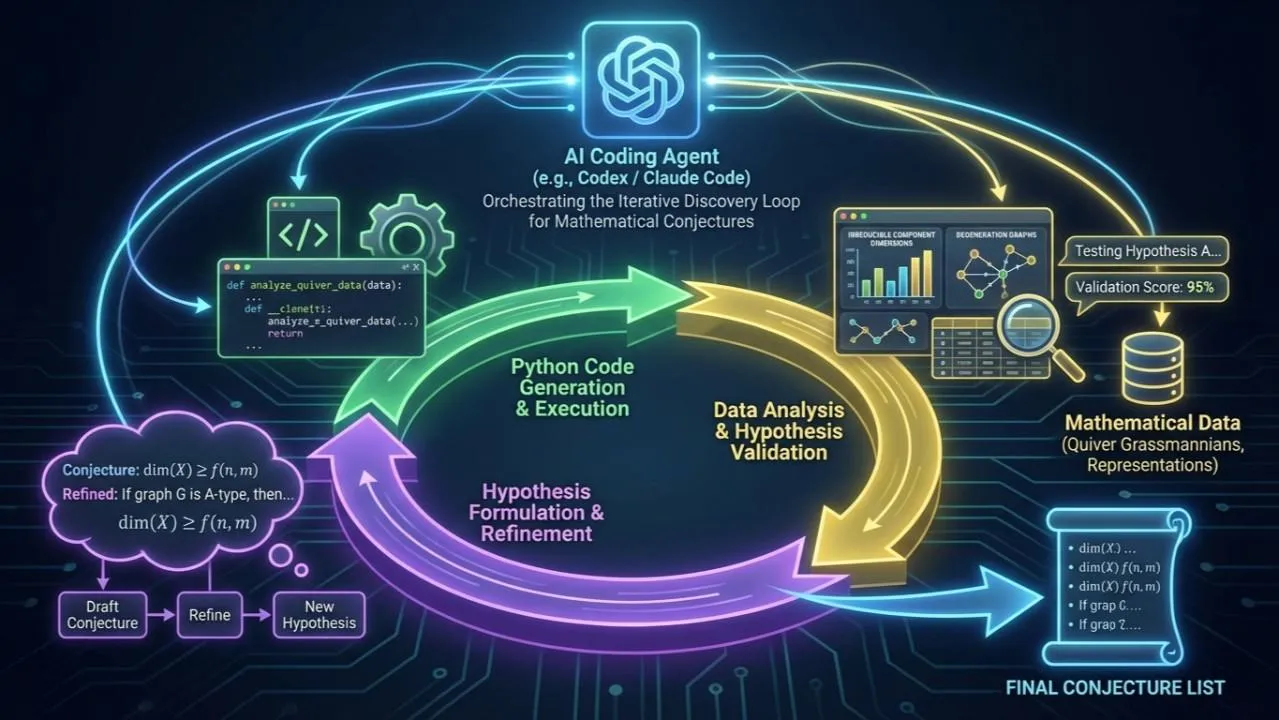
AI 模型参与发现问题 → AI 辅助提出修复方案 → 自动化实验验证 → 人类研究人员审查 → 改进 AI 训练基础设施 → 进一步提升 AI 能力。
这并不意味着 AI 已经能够独立完成可靠的科学研究,但它表明 AI 正在从单纯的应用工具,逐渐转变为科研和工程系统中的主动参与者和重要帮手。
如果未来 AI 不仅能够优化模型架构和训练参数,还能够持续发现底层算法、数值计算和硬件利用方面的问题,那么它对自身发展速度的推动,可能远远超过单纯增加模型参数或训练数据所带来的收益。
从这个角度看,Gemini 参与修复 Softmax 和交叉熵,不只是一次数值计算问题的修复,更是 AI 开始参与改进自身技术基础设施的一个值得关注的信号。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com