
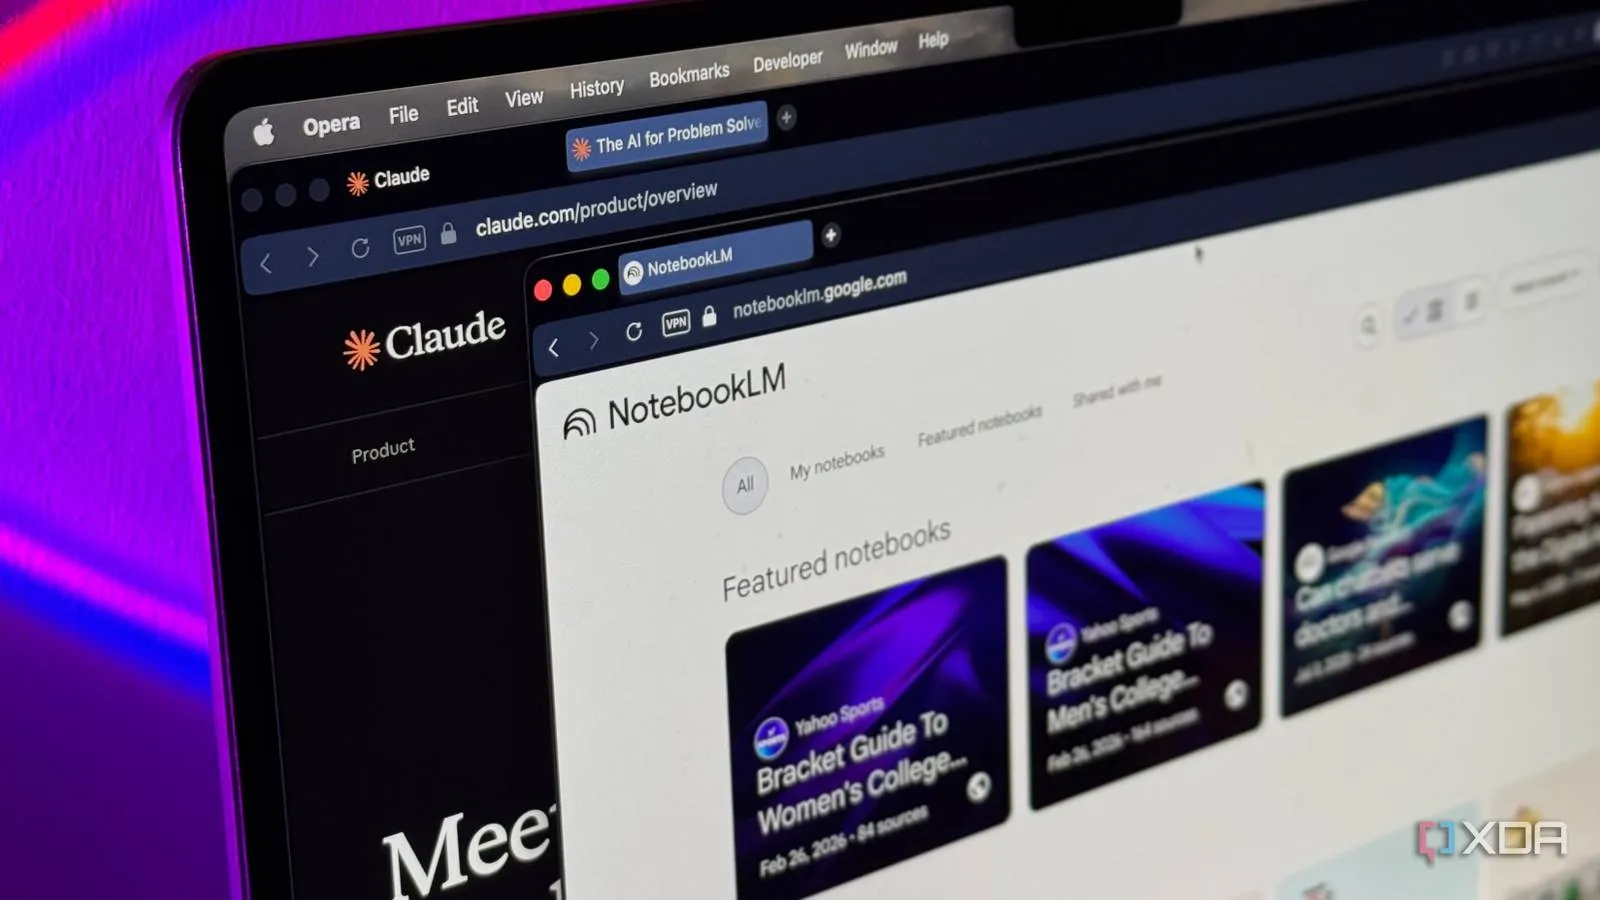
2026年4月6日,XDA 发布的一篇体验报道把注意力放在两个此前常被轻视的工具上:Anthropic 的对话式模型 Claude Code与 Google 的 NotebookLM。作者并未停留在产品功能介绍层面,而是把两者放进一个真实的研究流程中:先把数篇 PDF、会议记录和网页资料导入 NotebookLM,再把整理出的要点和疑问交给 Claude 去深挖与交叉核对。
在 NotebookLM 的操作细节中,作者描述了上传过程的即时反馈:系统会自动识别章节标题、图表和参考文献,并把这些结构化信息呈现在左侧侧边栏,允许作者在短时间内生成“阅读清单”和“关键实验摘要”。文章举例称,面对一篇 20 页的会议论文,只需数分钟便能得到逐章要点和关键数值的汇总,节省了大量翻阅时间。
随后,作者把这些由 NotebookLM 提取的要点逐条交给 Claude。Claude 在对话中先做横向比较:把不同论文对同一指标的测量方法并排列出,指出实验设置上的微小差异如何可能导致结果波动;在引用方面,它能快速把文献中的引用序号还原成具体来源,帮助作者追溯原始数据。文章示例中,Claude 在三轮对话后把一个模糊结论拆解为可复现的实验步骤,并建议补充对照试验以验证结论稳健性。
作者直言:"Can't believe the tools I rolled my eyes at are now the ones I can't work without." 这句感慨贯穿全文。具体到工作流,NotebookLM 的强项是批量化整理与结构化笔记,而 Claude 则擅长将零散信息合成为线索,给出可操作的研究问题和复核清单。文章列出的一个使用技巧是:先在 NotebookLM 里做粗筛,再用 Claude 做深度提问;二者交替能把“噪声”逐步剔除。
尽管报道对两款工具效果表示肯定,但也没有回避风险与局限。作者指出,Claude 有时会给出过于自信的结论或“乐观的推断”,引发对事实核查的额外需求;NotebookLM 在处理复杂表格或 OCR 质量差的扫描件时,结构化识别会出现断层。文章还提醒读者在引用生成的参考文献时务必回到原文核对细节,尤其是数值和实验参数。
在实用建议部分,作者分享了多条具体操作要点:对上传的每个文档先做一次人工目录检查、在 NotebookLM 里为重要段落打标签以便随后在 Claude 中引用、把 Claude 的回答分成“事实段”“推断段”“建议段”三类并分别标注可信度。作者称,这些细节使得原本看似“炫技”的 AI 功能变成可重复的研究步骤。
文章最后强调的是心态的转变:从一开始的怀疑到现在把它们纳入日常工具箱,关键在于把 AI 当作增效工具而非替代者。作者在结论中写到,AI 帮助压缩了文献梳理的时间窗,提高了发现潜在问题的概率,但真正能把结论落地、写出可发表论文的,仍然是研究者对方法与数据的严谨把控。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com