
2026年10月24日前后,杰克·多西(Jack Dorsey)旗下的Block公司正式公布了全新语音模型Dessa。该模型由Block内部一个小型AI研究实验室开发,核心主张颇为鲜明:完全基于人类语音对话数据从零训练,不依赖任何文本语料,也不使用预训练的大语言模型作为底座;支持全双工(full‑duplex)实时对话,可在消费级设备上本地运行,并展现出笑声、停顿、哭泣、叹息等丰富的情感与自然韵律。
目前,Dessa以研究预览(research preview)形式发布,优先向AI安全研究人员开放早期访问,并设有公开候补名单。官方尚未公布模型权重、API接口或商业定价。
技术定位:语音到语音,跳过文本中转
与当前主流语音助手不同,Dessa采用真正的speech‑to‑speech架构——音频输入,音频输出,中间没有“语音转文字→大模型生成→文字转语音”的传统流水线。Block强调,这种设计能更好地保留语音中的情感、讽刺、停顿与副语言信息,而这些信息在经过文本中转时往往大量丢失,导致现有语音AI听起来生硬、延迟感明显。
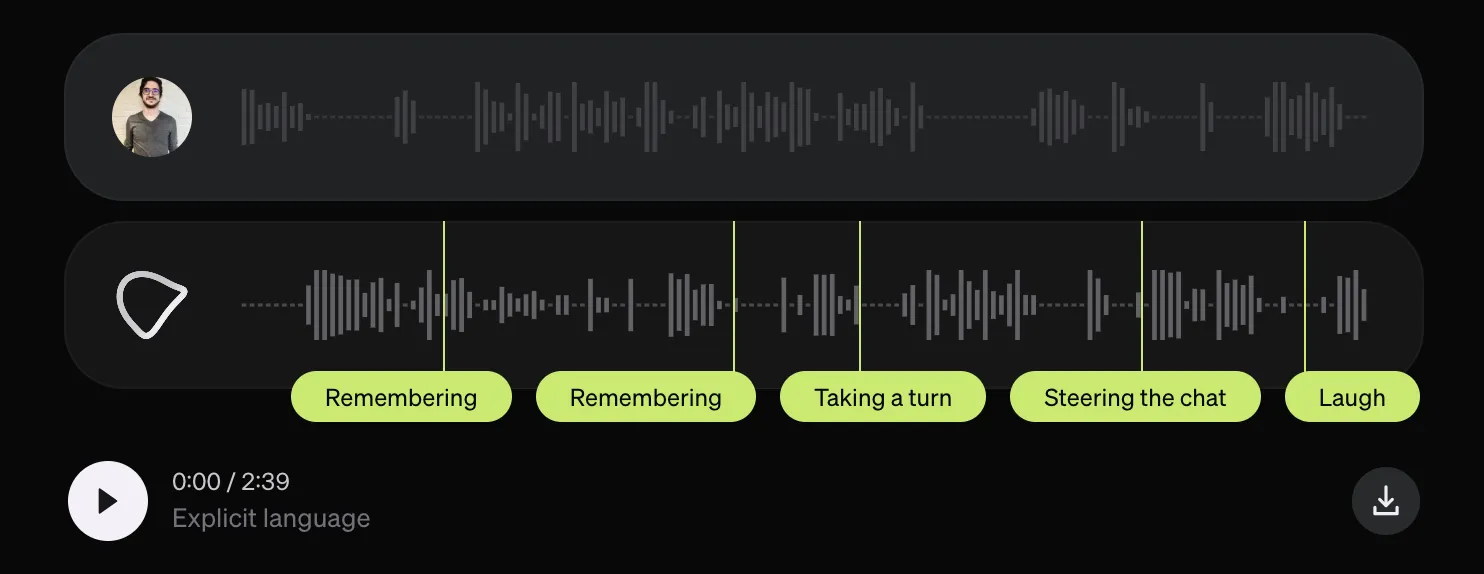
模型支持全双工通信,即在说话的同时持续聆听,能够自然插话、发出“yeah”“got it”等反馈信号,模拟真实人类对话中的互动节奏。官方演示音频中,Dessa展现出笑声、哽咽、语气变化等表现,部分对话甚至被描述为“略显尴尬却更像真人”的风格。
训练方面,Block称Dessa完全在人类对话录音上从零训练,使用“比大语言模型少数百倍的词量”,并在单台NVIDIA GB200 NVL72机架(约72颗Blackwell GPU)上完成。推理可在MacBook Pro M4 Max或更高配置上本地运行,且声称速度快于实时。
团队背景与发布方式
Dessa来自Block内部一个极小规模的研究实验室,由前Dessa(多伦多深度学习初创公司,2020年被Square/Block收购)成员组建。实验室负责人Ragavan Thurairatnam表示,团队自2012年起从事深度学习,专注生成式语音模型已超过八年,直接向多西汇报。多西本人也在X平台上转发并称其为“有史以来最真实的全双工语音模型”,同时强调其体积之小——可在MacBook上运行。
发布形式上,Block并未同步放出技术报告、参数规模、训练数据量或公开基准测试,而是以官方网站演示录音和候补名单为主。早期访问优先面向安全研究人员,意在先发现潜在风险(例如声音欺骗、情感操控等)。
客观评估与潜在意义
Dessa的核心卖点在于“纯语音训练”与“本地可运行”。如果其宣称成立,这代表一种与主流“文本大模型+TTS”路径截然不同的技术路线:直接从语音中学习语言与交互模式,可能在情感表达与自然度上更具优势,同时降低对云端大模型的依赖。
对用户与开发者而言,本地部署意味着更低延迟、更高隐私性与离线可用性,这在支付、客服、个人助手等场景中具有实际价值。Block作为Square与Cash App的母公司,未来或有可能将此类能力融入其金融与社交产品。
然而,客观来看,目前仍存在明显信息缺口:
- 缺乏独立基准测试与第三方验证,真实对话质量、鲁棒性与多语言能力尚待检验;
- 未公开参数量、训练数据规模与具体架构,难以评估其与现有语音模型的相对水平;
- 目前仅限研究预览,距离大规模可用仍有距离;
- 纯语音训练虽可能保留更多情感线索,但在知识广度、逻辑推理与事实准确性上,可能不如依托大规模文本预训练的模型。
此外,高度逼真的情感语音也带来新的安全与伦理问题——例如声音克隆、情感操纵或欺诈风险。Block主动邀请安全研究人员介入,本身即承认了这一潜在隐患。
行业背景与展望
当前语音AI正从“能听能说”向“更自然、更情感化、更实时”演进。OpenAI的GPT‑Live等全双工模型已推动实时交互体验,而Dessa选择从“完全跳过文本”的路径切入,试图从根本上解决情感丢失与延迟问题。其小团队、相对有限的算力投入却宣称达到可用对话水平,也引发了关于语音模型是否需要巨量文本数据的讨论。
总体而言,Dessa是一次有明确技术主张的发布:用纯人类语音数据训练、追求本地运行与情感真实感。它能否真正改变语音交互范式,仍取决于后续公开的技术细节、独立评测结果,以及从研究预览走向实际产品的落地进度。在AI语音赛道日益拥挤的当下,Block选择以“更小、更本地、更像人”的差异化路径参与竞争,本身已构成值得持续关注的信号。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com