
2025 年 9 月 30 日,在 中国著名的AI公司Deepseek 发布DeepSeek‑V3.2‑Exp版本的一天后,在代码生成领域全球领先的人工智能公司 Anthropic 正式发布其最新模型 Claude Sonnet 4.5,主打“长期自主执行 + 强化编码 + 更强推理”为核心竞争力。相比其前代版本,4.5 在编码耐久性、工具协作、推理能力与系统生态整合方面有多重突破,被定位为其“最对齐”、最强大的边界模型。
新突破与亮点
1. 长周期自主运行能力大幅提升
Anthropic 在发布中指出:在内部测试中,一个客户曾让模型在无人干预的情况下持续编码 30 小时以上,构建一个完整的 Web 应用程序。这个成绩远超其之前版本(Opus 4 在某些实例中曾维持约 7 小时)。这种长时运行能力增强了 Claude 的长期任务执行潜力。
这种能力意味着模型在面对跨小时、跨日的复杂任务(如连续的数据处理、自动化脚本执行、机器人控制等)时具备更强耐力,不容易因上下文断裂、内部状态衰减而失去连贯性。
2. 编码能力与工具协作再进化
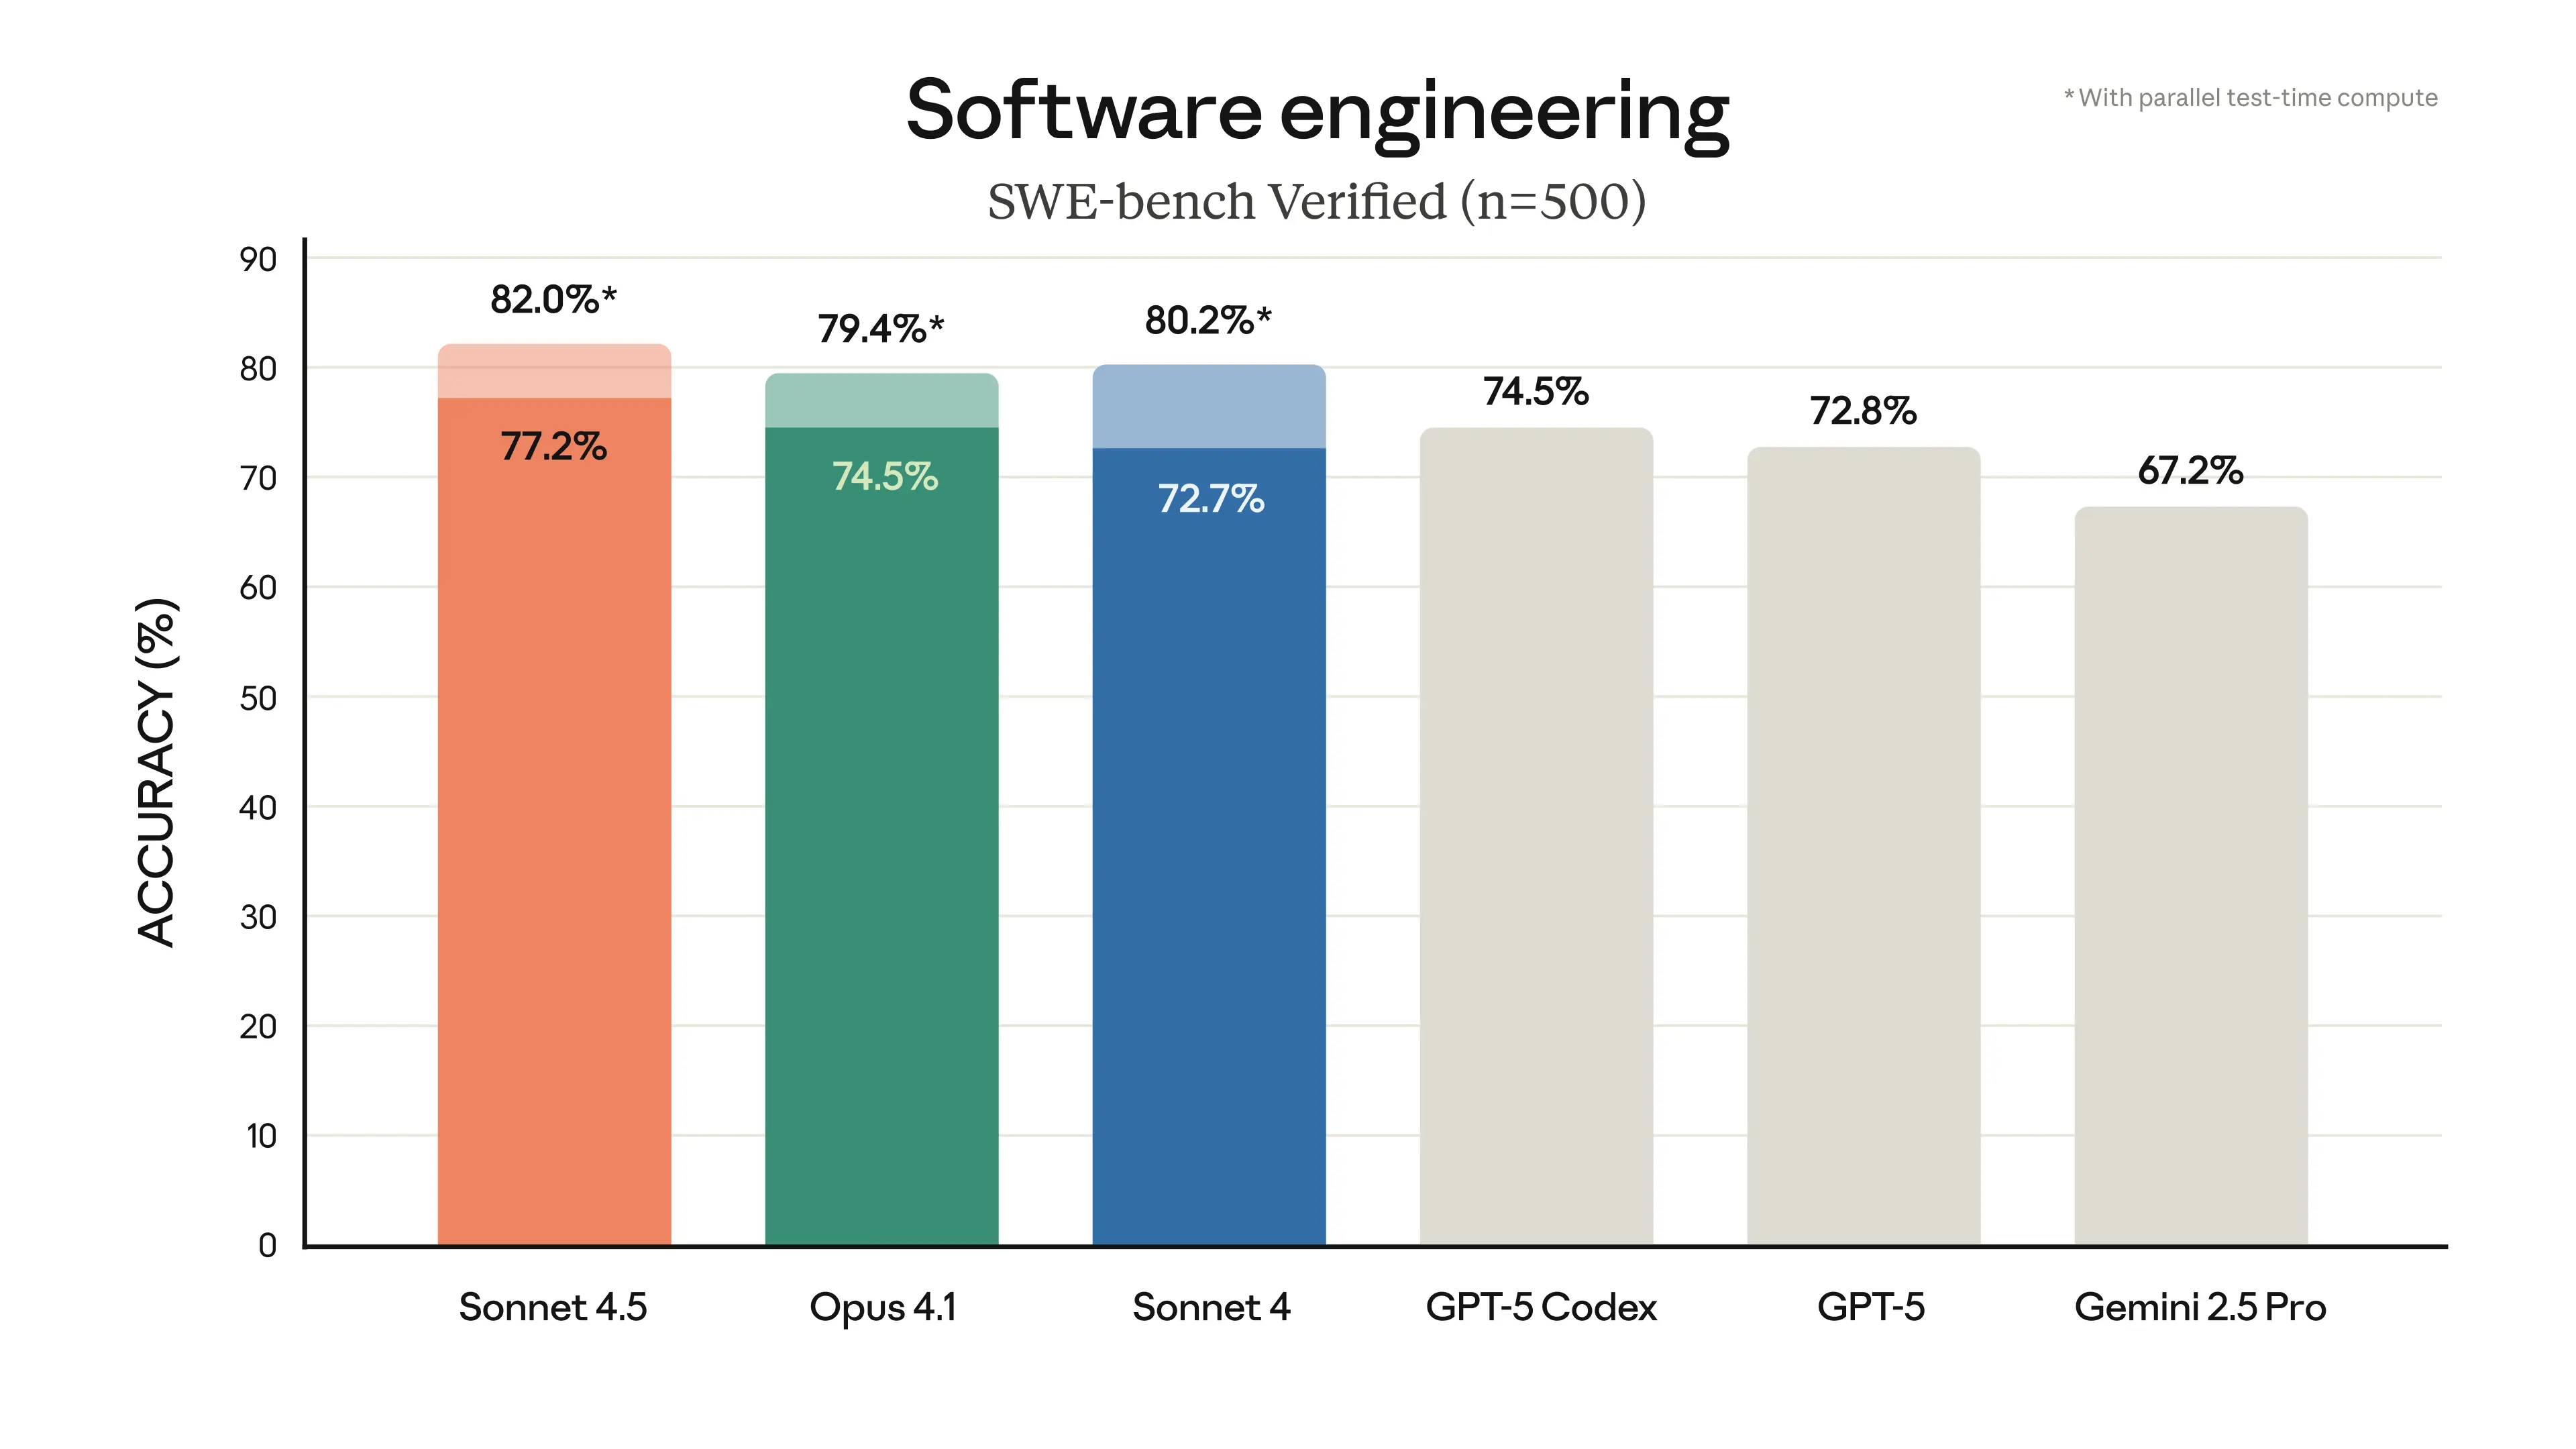
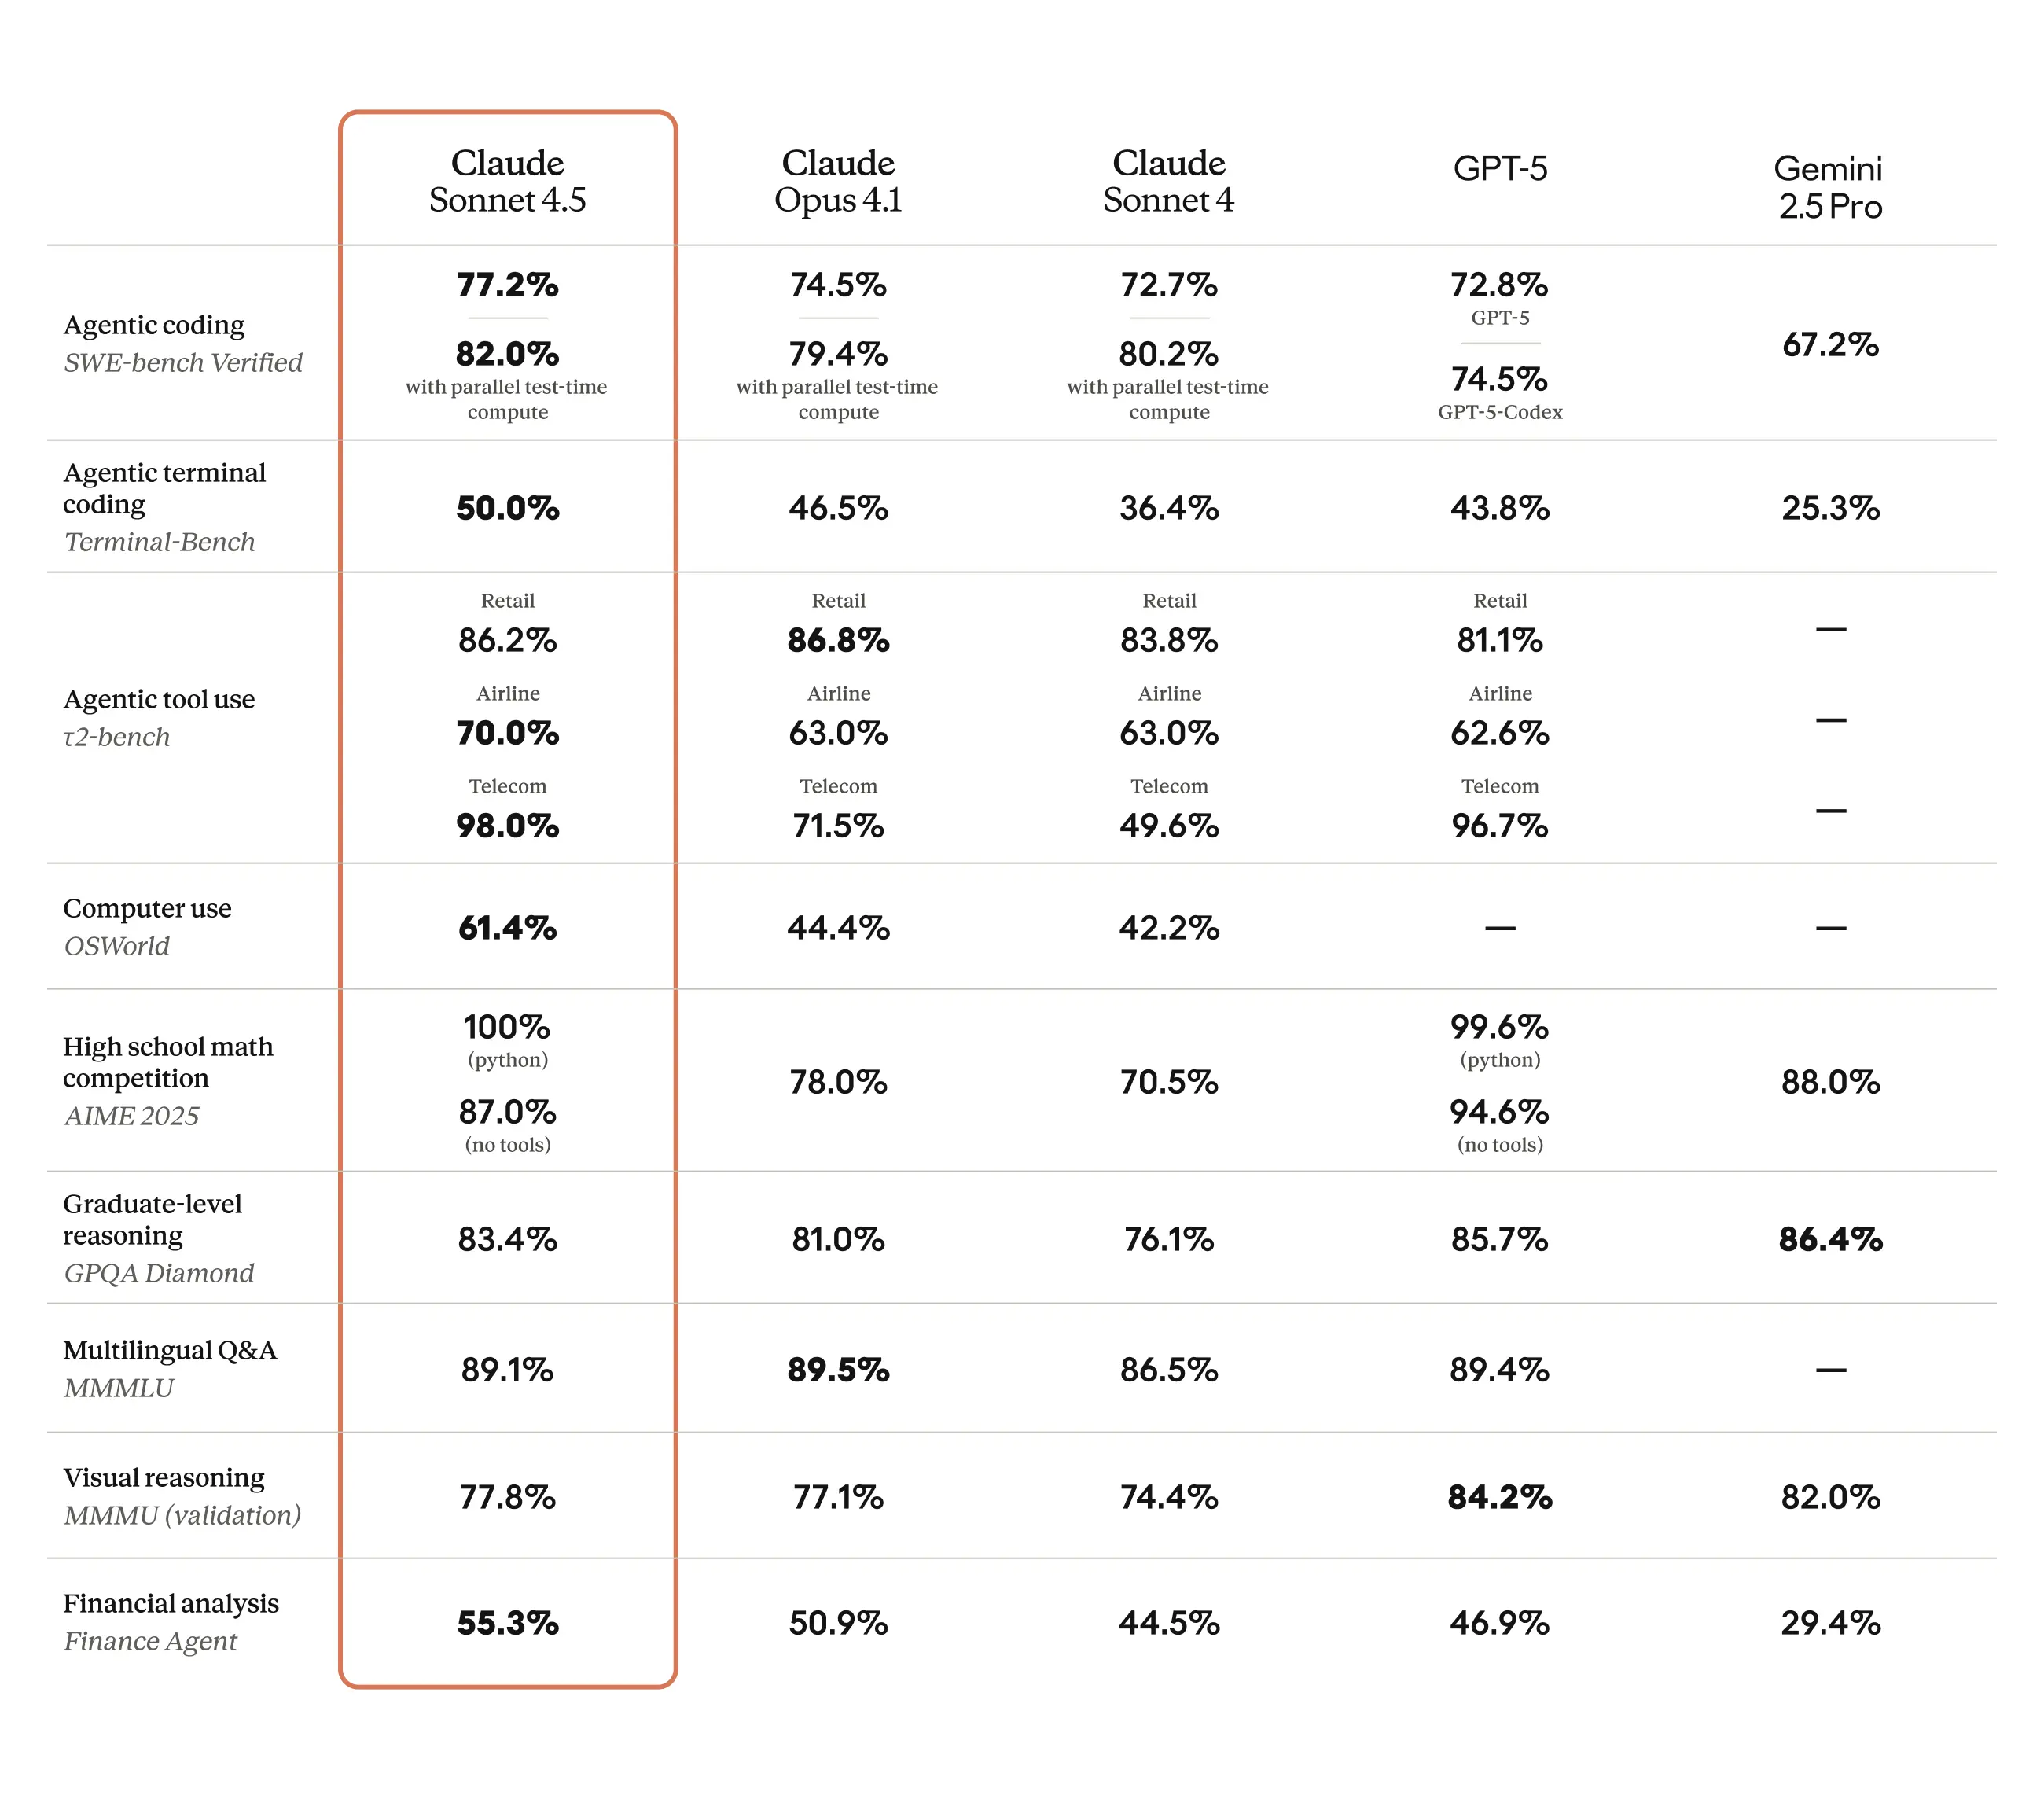
在技术更新中,Anthropic 强调 Sonnet 4.5 是“世界上最强的编码模型(best coding model)”,特别擅长构建复杂的 agent 系统与自动化工具。通告指出,在 SWE‑bench Verified(衡量真实世界软件工程能力的基准)上,4.5 取得顶尖表现。
- “检查点”(checkpoints):用户在使用 Claude Code 时可保存进度、回滚状态,这是用户长期编码过程中非常实用的版本控制功能。 Anthropic
- VS Code 原生扩展与终端界面刷新:提升开发环境的无缝性和效率。
- Claude Agent SDK:Anthropic 开放其内部构建 agent 的框架与工具给开发者,让构建可组合的、上下文智能的 agent 更加便捷。
这些改进让 Sonnet 4.5 在“理解意图 → 拟定策划 → 工具调用 → 执行动作”这一链条上能更顺畅地协同工作。
3. 在 OSWorld 与现实操作任务上的跨越式提升
Claude 4.5 在 OSWorld 基准上的表现尤为引人注目:官方数据显示,其在执行真实计算机任务(如界面操作、文件操作、软件使用等)的得分从 Sonnet 4 的 ~42.2% 跃升至 61.4%。这意味着模型在控制电脑环境、执行系统级操作方面的能力大幅增强。
在操作系统与计算机使用能力上,4.5 被宣传为 “最强的模型”,可在浏览器中直接导航、填写表格、执行脚本、操纵界面等。
4. 改进的推理、数学与对齐表现
Anthropic 在通告中还强调,Sonnet 4.5 在推理(reasoning)和数学(math)任务上的表现也有显著提升,是该公司迄今为止“最对齐”的 frontier 模型。相较于早期版本,它在行为对齐(alignment)方面进行了多项优化:减少讨好行为 (sycophancy)、欺骗风险 (deception)、权力驱动 (power‑seeking) 和幻觉 (hallucination) 的倾向。
此外,在系统安全方面,4.5 被纳入 ASL‑3(Artificial Intelligence Safety Level 3) 保护框架,其输出与输入会被多层分类器检测,特别针对化学 / 生物 /核 /放射性 (CBRN) 风险内容。Anthropic 表示其分类器误报率已大幅降低。
5. 推出即享有无更改价格 / 下层兼容性
令人注意的是,Anthropic 宣称 Sonnet 4.5 的 API 定价与 Sonnet 4 保持一致:$3 / $15(输入 / 输出 token)不变。也就是说,用户可升级为 4.5 而无需承担更高成本。
此外,4.5 在部署上具备向下兼容性:无论你是通过 Claude 应用、API 还是 Claude Code,都可以将 claude-sonnet-4-5 作为直接可用选项。Anthropic 将其视为对 Sonnet 系列的“无缝升级”版本。
背景与行业意义
此次发布并非仅仅是常规版本更新,而是在 “AI 作为 agent / 自动化工具” 战场上的一次显著布局。近年来,构建能够长期执行复杂任务的 AI 被视为下一阶段竞争核心,而在这一方向上,持续运行能力 + 编码 + 工具协作通常是瓶颈。Sonnet 4.5 在多个维度同时发力,有望在企业级 AI、智能编程助手、自动化 agent 等场景获得更明确落地路径。
在市场竞争方面,Claude 4.5 的推出也正值 AI 模型阵营加速迭代期。OpenAI、Google、Anthropic 等都在加码 agent 能力,争夺编码/自动化/agent 市场。从这个角度看,4.5 不仅是技术更新,更是 Anthropic 巩固其在企业与开发者阵地的战略一步。
小结
Claude Sonnet 4.5 的发布带来了以下几大突破:
- 自主执行能力提升至 30 小时以上
- 在真实系统操作类任务(OSWorld)得分跳升至 ~61.4%
- 编码能力强化,并开放开发者级工具(checkpoints、Agent SDK、VS Code 扩展)
- 推理、数学能力与对齐表现全面升级
- 保持不变的 API 定价与向下兼容设计,降低升级门槛
可以预见,在未来几个月里,随着开发者、企业客户的实际使用反馈与基准测试结果陆续浮现,Claude 4.5 将成为 AI 编程、agent 应用、任务自动化领域的重要比较标杆。