
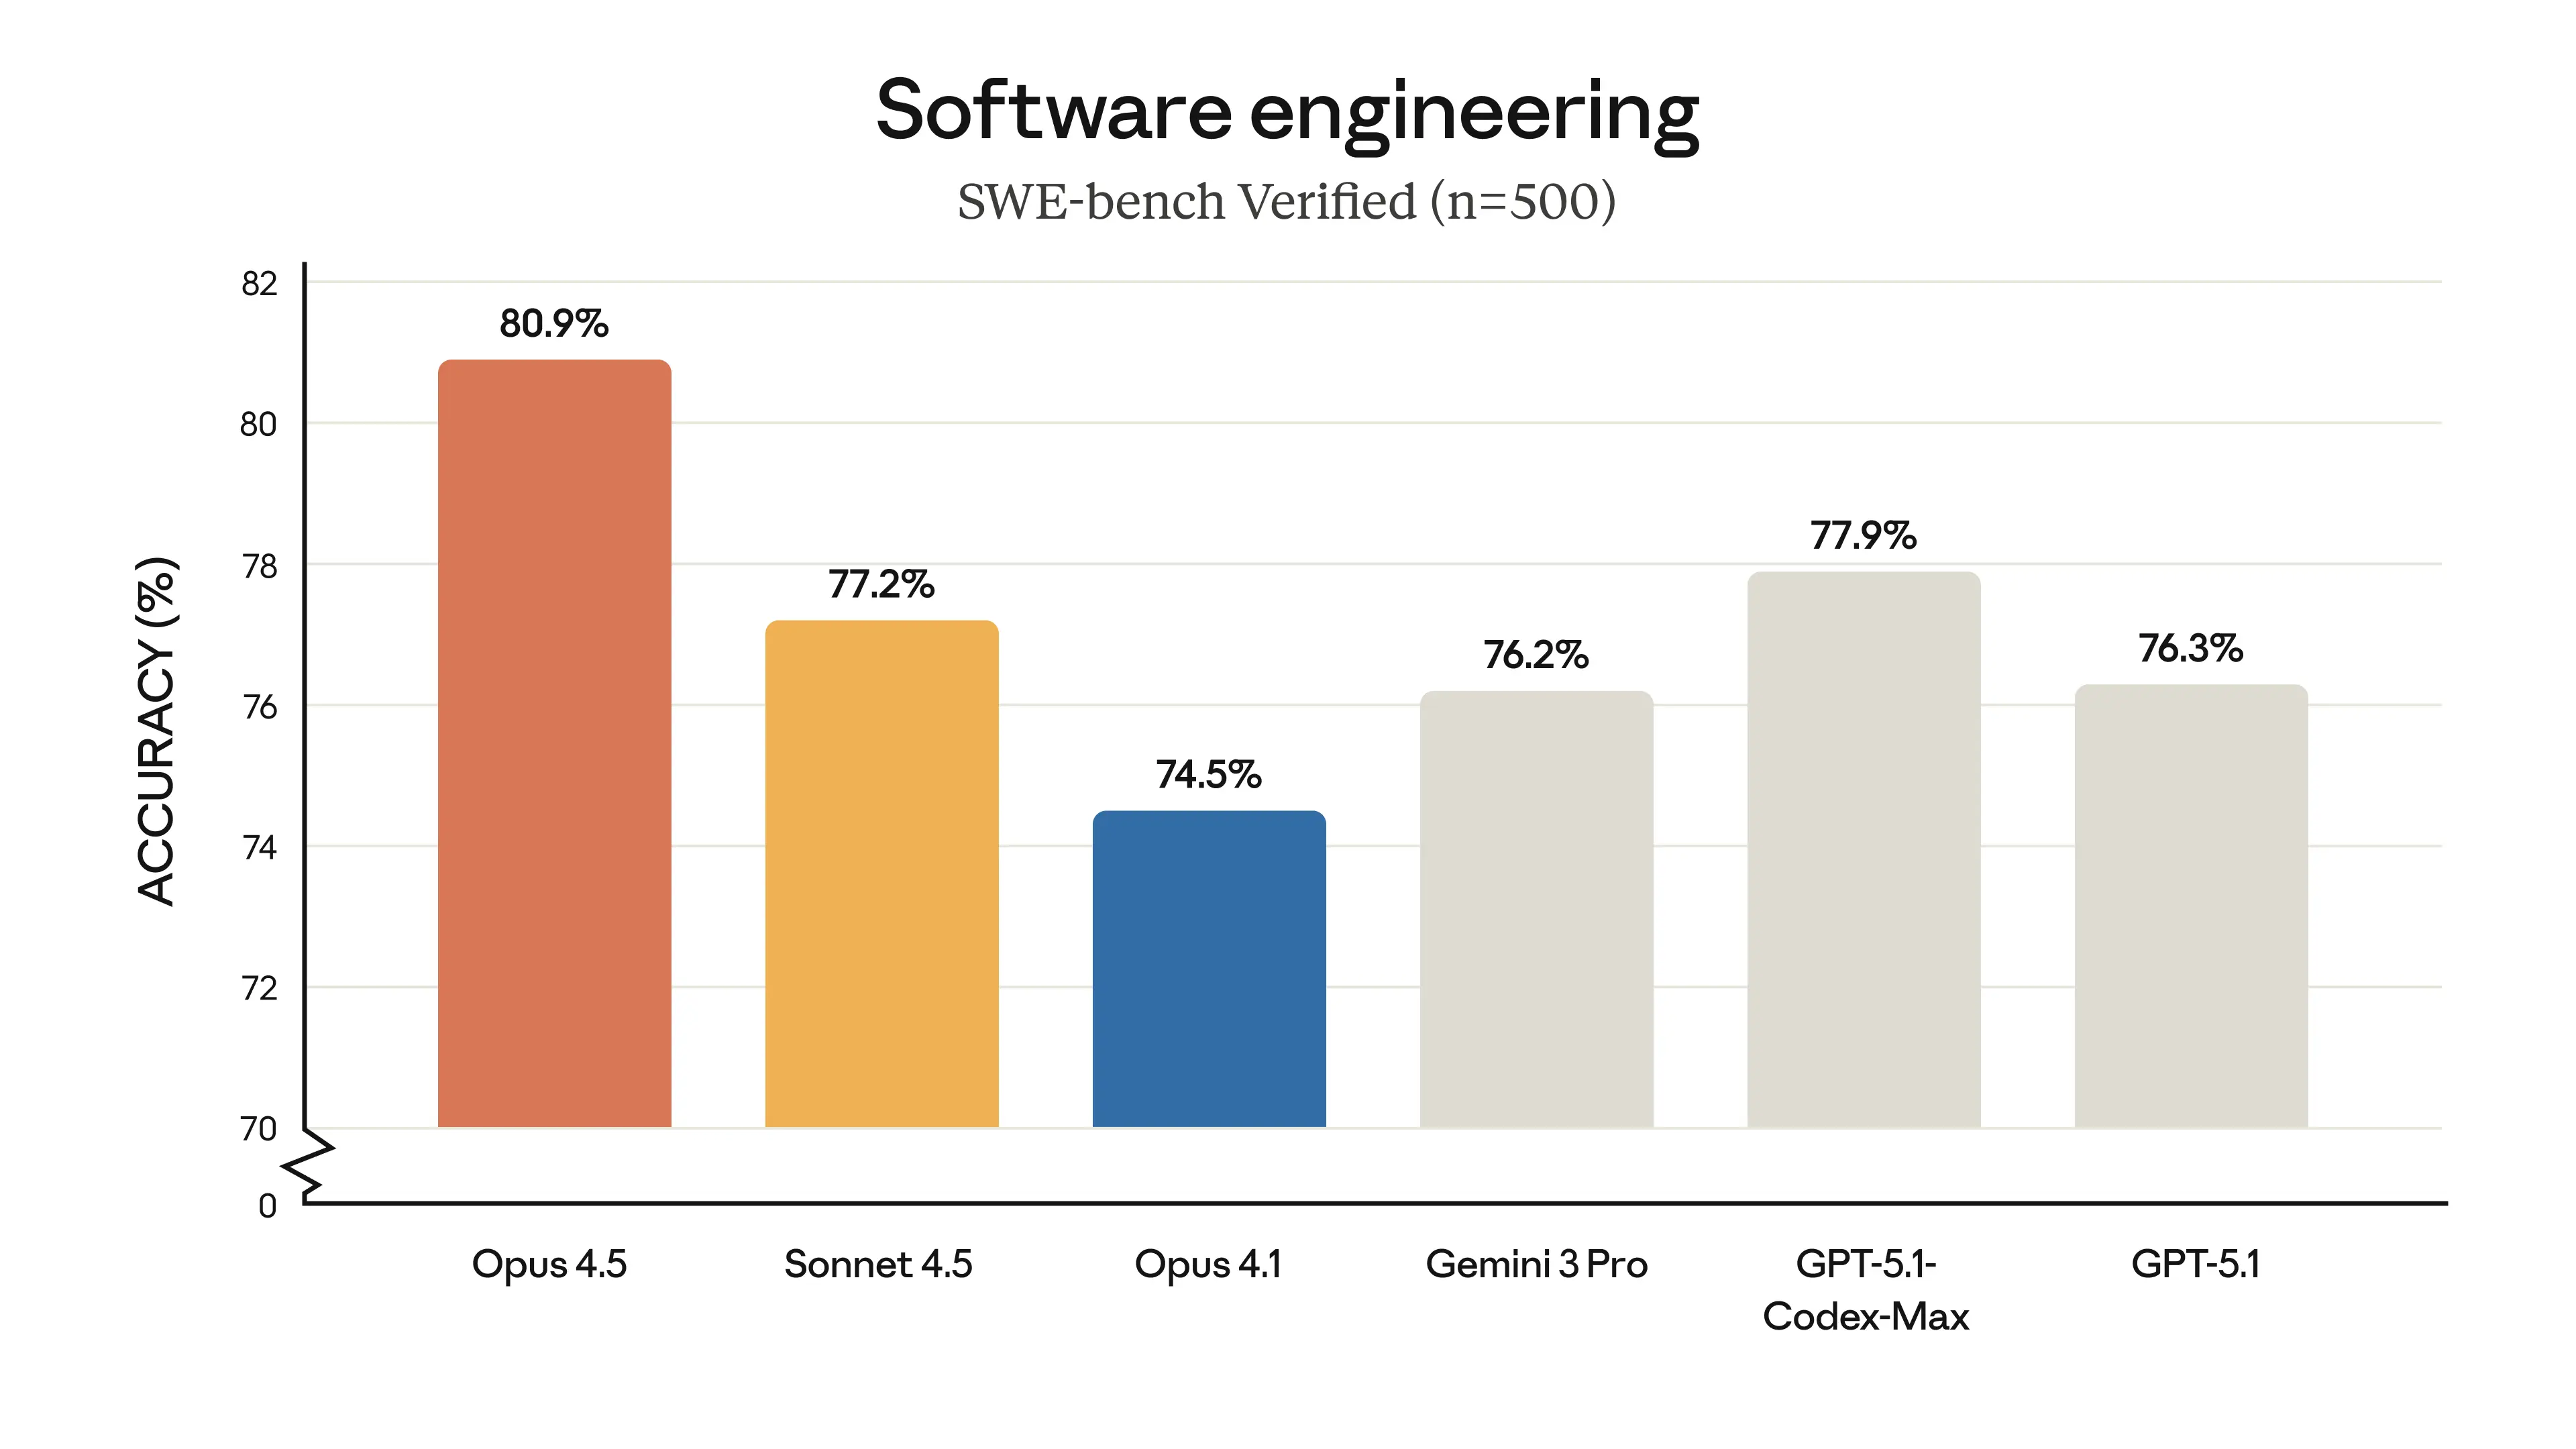
继OpenAI、xAI和Google相继发布最新大语言模型升级版本之后,Anthropic公司于2025年11月25日正式推出Claude Opus 4.5,这款旗舰级大型语言模型(LLM)以其在复杂编程、长时序推理和工具集成上的革命性表现,一举登顶LMSYS排行榜首位。作为Claude系列的巅峰之作,Opus 4.5不仅延续了Anthropic“宪法AI”框架的安全承诺,还在SWE‑bench Verified基准上得分80.9%,领先竞争对手3个百分点以上。 Anthropic CEO Dario Amodei在公司博客中宣布,该模型已向Claude Pro、Team和Enterprise用户开放,支持API即时访问,并深度集成GitHub Copilot和Microsoft Excel等工具。 Amodei强调:“Opus 4.5不是简单升级,而是我们对安全、可扩展AI的承诺。它将让开发者从‘手动编码’转向‘AI协作者’。” 这一发布紧随Google Gemini 3 Pro的脚步,OpenAI GPT‑5.1的竞争窗口中,Anthropic以其“平衡强大与实用”的定位反击,预计将重塑软件开发生态。CNBC报道,Opus 4.5上线首小时API调用量破百万,GitHub Copilot用户反馈“编码效率提升30%”。 与同期发布的Claude Sonnet 4.5相比,Opus 4.5更注重深度推理和代理能力,而Sonnet则强调速度和成本控制,这一“双子星”策略或将成为Anthropic的杀手锏。TechCrunch分析,Opus 4.5的“嵌套推理链”设计,让它在长任务上领先,但Sonnet的“轻量级”架构更适合日常部署。
Claude Opus 4.5的诞生源于Anthropic对“实用AI”的长期追求。自Claude 3 Opus于2024年3月发布以来,该系列已迭代至4.1(2025年6月),累计用户超1亿。 Opus 4.5作为4.1的重大升级,专注于“代理级能力”(agentic capabilities),通过“宪法AI”框架内置伦理守卫栏,确保输出可靠且无偏见。Anthropic系统卡(System Card)于今日发布,详细披露了模型的安全评估:它在AI Safety Level 3标准下通过测试,抵抗提示注入率达99.5%。 Amodei在博客中解释:“Opus 4.5是Claude的巅峰之作,它在编码、工具使用和多代理协作上达到SOTA水平,同时保持我们对安全的承诺。” 这一低调上线策略借鉴了Google的shadow release,避免了早期bug曝光,但也让开发者惊喜连连:GitHub Copilot公测版已支持Opus 4.5,数小时内下载量激增40%。
从技术细节看,Claude Opus 4.5的核心在于“代理编码与工具集成”的双重革命。架构基于Transformer变体,参数规模达万亿级,训练于Anthropic的专用TPU集群。 与Claude 4.1相比,它在SWE‑bench Verified基准上得分飙升至80.9%,位居首位,领先Gemini 3 Pro的76.2%。 这一成绩得益于“嵌套推理链”(nested reasoning chain):模型能处理长时序任务,如从需求文档生成端到端Web应用,包括前端React组件、后端Node.js服务和数据库集成,测试覆盖率95%。 The New Stack报道,Opus 4.5是首个“Windows原生”训练模型,支持本地环境协作,减少“思考时间”——复杂逻辑前不需冗长前缀。 在Terminal‑Bench 2.0上得分54.2%,SWE‑Lancer IC SWE 79.9%,擅长多模块代码审查。 工具集成是另一杀手锏:它无缝支持Chrome浏览器和Microsoft Excel操作,例如从Excel数据自动生成Python脚本,或在浏览器中执行web scraping任务。 Anthropic博客演示:在Codex CLI中,输入“构建航班跟踪应用”,模型规划端到端流程:前端UI、后端服务、数据库集成,并验证代码。 幻觉率降至3%以内,远低于GPT‑5.1的5%。
Opus 4.5的应用场景广泛,覆盖从个人开发者到企业级部署。首先,“长时序工程”:它能自主处理24小时任务,如从UML图生成完整微服务架构,包括API设计、测试和部署脚本。 其次,“协作开发”:作为Cursor、Cognition和Warp等初创的合作伙伴,Opus 4.5优化了“编码个性”,支持用户中断式交互——AI暂停“思考”,等待反馈。 企业级如Factory的自动化流水线,可用它生成CI/CD管道,减少手动编码40%。 The Decoder报道,它在内部代码审查工具中表现突出,识别漏洞和优化脚本。 定价亲民:Pro/Team/Enterprise用户免费访问,API费用为(5/25美元/1m输入/输出token)。
Opus 4.5 与 Sonnet 4.5 的区别:Anthropic的Claude 4.5系列采用“双子星”策略:Opus作为旗舰,Sonnet作为平衡版。Opus 4.5参数规模更大(万亿级 vs. Sonnet的千亿级),推理深度领先:在GPQA Diamond基准上93.8%(Sonnet 88.5%),适合复杂代理任务如多步代码调试。 Sonnet 4.5速度更快(推理延迟0.5秒 vs. Opus的1.2秒),成本低30%,适用于日常聊天和快速原型。 Opus的嵌套推理链支持长上下文(100万token),Sonnet限50万token。 安全方面,Opus的宪法AI框架更严谨,抵抗注入率99.5%(Sonnet 98%)。 总体,Opus适合企业级深度应用,Sonnet更亲民——Anthropic博客称“Opus是思考者,Sonnet是执行者”。 这一设计借鉴Google Gemini 3的Pro/Ultra分层,平衡性能与可用性。
这一发布的影响深远。Opus 4.5标志着Anthropic从“通用模型”向“专业代理”的战略转向,挑战Google Gemini 3的代理编码能力(Elo 1487)。 VentureBeat分析,它将重塑软件工程:开发者从“代码工人”转为“AI导演”,生产力提升2‑3倍。 与Anthropic Claude 4.1(SWE‑bench 74.5%)相比,Opus 4.5的80.9%分数领先8%,尤其在长任务上。 应用潜力巨大:从初创自动化到企业DevOps,Opus 4.5的“压缩”机制解决“记忆墙”问题,支持百万token级项目。 OpenAI强调,其在网络安全上的能力虽强(漏洞识别提升),但未达“高能力”阈值,内置沙箱和监控机制。
用户反应热烈。从11月24日上线起,Reddit r/OpenAI子版块涌入数百帖:“Claude Opus 4.5太神了,24小时任务终于不用重启了!” ZDNet用户测试显示,复杂逻辑响应时间缩短42%,但少数抱怨“压缩后细节丢失”。 X上#ClaudeOpus45标签下,兴奋情绪占80%,开发者如@codewhisperer帖“从Claude 3到这个,Anthropic又赢了”。 批评焦点在成本:长任务token费用增20%。 初创反馈积极:Cursor创始人表示,Opus 4.5集成后,代码质量提升30%。
这一发布的影响深远。Opus 4.5标志着AI编码从“补全”向“自主工程”的跃迁,挑战GitHub Copilot的霸主地位(Copilot已集成GPT‑5.1‑Codex)。 Neowin预测,到2026年,代理编码市场规模达1000亿美元,Anthropic市占率将超过50%。 与Google Gemini 3的Antigravity平台相比,Opus 4.5更注重“耐力”,支持Windows原生协作。 企业如Warp的自动化流水线,可用它生成CI/CD管道,减少手动40%。 The Decoder报道,Opus 4.5在内部代码审查中识别漏洞提升,内置沙箱防范提示注入。
然而,挑战犹存。模型卡承认,网络安全能力虽强(漏洞识别提升),但未达“高能力”阈值,需持续监控滥用。 欧盟AI Act审查或延缓欧洲部署。Amodei回应:“Opus 4.5是负责任AI的承诺——强大,却可控。”