
2025年11月26日,Nature发布的一组图表将目光投向了一个已经改变科学工作方式的工具:AlphaFold。文章通过时间序列和领域分布图,展示了AlphaFold自2020年问世后如何把“未知三维结构”逐步变为“可获取模型”。
图表一显示数据库规模的爆炸式增长:从早期几万条预测快速扩展到覆盖数以亿计的蛋白序列,其中不仅包括模式生物的蛋白,还囊括了大量未培养微生物与环境样本的序列预测。这种规模带来的直接效果是在很多研究中,实验团队不再从零开始猜测折叠拓扑,而是以AlphaFold模型为起点,节省了数月到数年的结构验证时间。
另一组图用引用量和领域渗透率说明了采用速度:结构生物学的论文中引用AlphaFold的比例在短短几年内激增,药物研发、酶工程、植物科学和微生物生态学等领域的引用快速上升,图中可以看到某些交叉学科的曲线甚至在2023–2024年出现陡升。这意味着越来越多的年轻实验室和跨学科团队把预测结构直接纳入试验设计,推动了高通量筛选和理性设计的普及。
文章还细化了AlphaFold在实验室工作流程中的角色:对冷门或难溶的蛋白,研究者用预测模型指导截短、突变与表达策略;在低分辨率的冷冻电子显微镜(cryo‑EM)图像处理中,AlphaFold模型被用作初始模板,加速了装配和拟合过程。Nature的图表通过具体案例累计展示了“模型→实验验证→功能发现”的闭环如何缩短从假设到确证的时间窗。
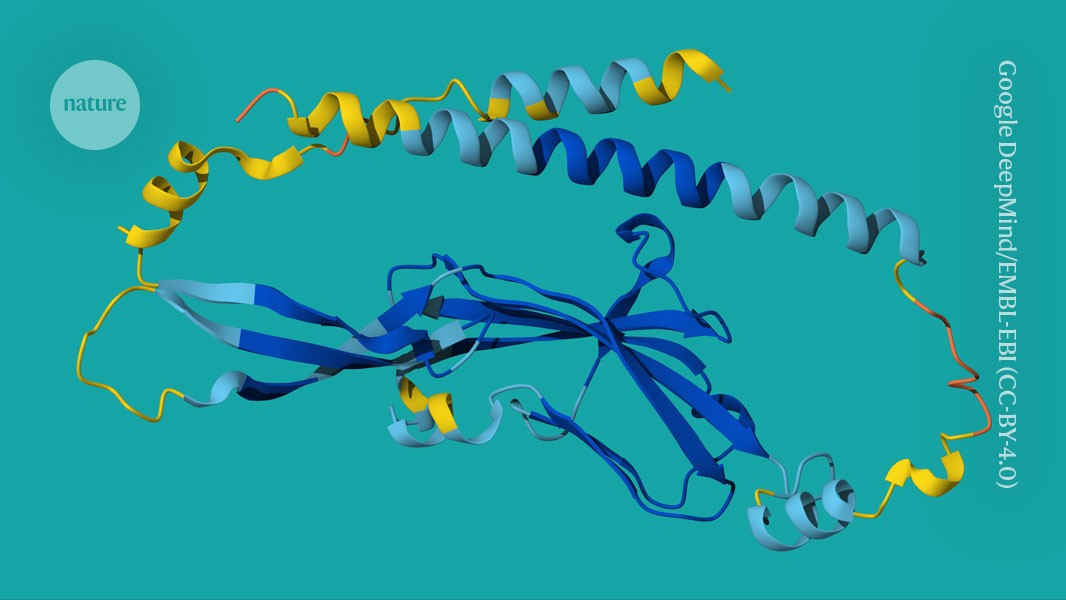
然而图表也揭示了局限:在涉及配体结合、翻译后修饰、多蛋白复合体与高度无定形区(intrinsically disordered regions)的预测上,AlphaFold的置信度仍然不均。文章用置信度评分(pLDDT)分布图说明,低置信区往往与功能相关的调节片段或相互作用界面重合,提示研究者在这些区域仍需借助实验验证。
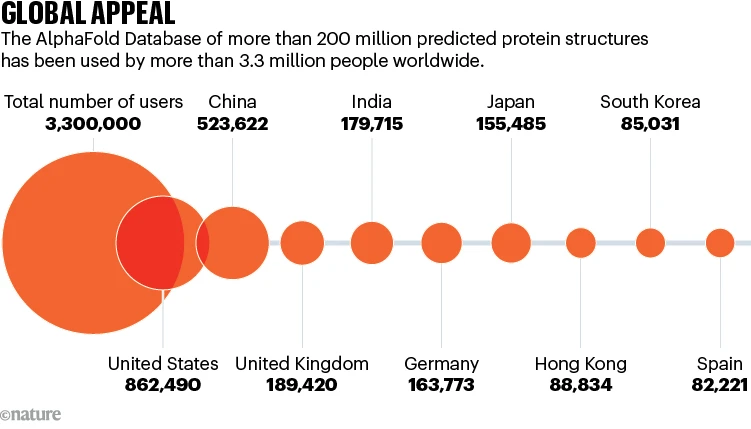
技术演进方面,Nature指出AlphaFold家族的拓展(如AlphaFold Multimer等模块)正在尝试覆盖复合体建模;同时,图表显示开源数据策略极大地拉低了获取门槛,全球多个中低收入国家的研究机构开始在本地样本上应用结构预测,推动了更多样化的生物学问题入列。
面向未来的图表将重点放在“可解释性”和“动态性”上:静态三维坐标虽然有价值,但蛋白质功能常常依赖构象振荡和相互转换,文章建议下一步应把机器学习预测、分子动力学和高通量实验更紧密地结合,以捕捉功能相关的动力学景观。此外,如何在药物靶点选择与设计时正确处理置信区间、以及把预测结果与化学位点和配体信息整合,都是接下来需要攻克的工程与算法问题。
总的来看,这组图表并非单纯颂扬工具,而是以可视化数据展示了AlphaFold既带来效率革命,也暴露出新的科学难题:开放的模型和数据库把结构学门槛向世界各地的年轻研究者打开,同时也把“需要实验验证的边界”明晰化。对于正在寻找下一个突破口的科研团队和初创公司来说,AlphaFold既是加速器,也是放大镜——它放大了可被测的生物学问题,也放大了未被解决的复杂性。