
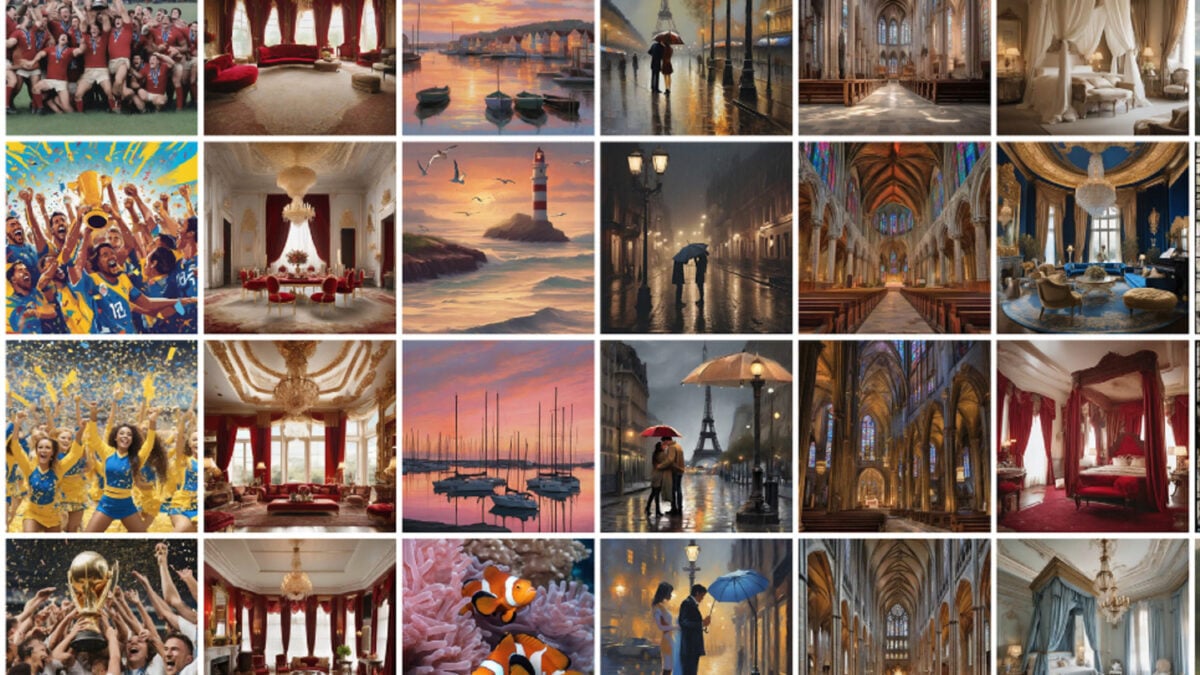
最近一项发表在《Patterns》杂志上的研究揭示了一个引人注目的现象:尽管AI图像生成器接受了海量训练数据,但它们在生成图像时往往会默认收敛到一组有限的、泛泛的视觉风格。这种“视觉电梯音乐”般的输出,不仅暴露了当前AI模型在创造力方面的结构性限制,还引发了对AI与人类协作必要性的讨论。研究由瑞典达拉纳大学和美国密歇根州立大学的研究者完成,他们通过模拟“视觉电话”游戏的方式,观察到AI在自主循环中迅速丧失多样性,最终落入12种主导主题的陷阱。
这项研究的背景源于对AI自主创造系统的探索。随着像Stable Diffusion和DALL·E这样的工具普及,人们期待AI能开启无限创意的新时代。然而,现实并非如此。研究者指出,AI图像生成器虽然训练于数十亿张图像,但其输出往往趋向于商业安全的、株摄影般的审美。这种趋同性类似于人类文化传播中的迭代学习效应,但在AI中,它会导致多样性的完全崩溃。领导这项研究的Arend Hintze教授表示,这种现象反映了AI模型在训练数据中偏向高概率“吸引子”的倾向,导致原创性迅速流失。
为了验证这一假设,研究团队设计了一个巧妙的实验框架。他们构建了一个闭环反馈系统,使用Stable Diffusion XL(SDXL)作为图像生成模型,以及Large Language and Vision Assistant(LLaVA)作为图像描述模型。该系统模拟了一个“文本→图像→文本→图像”的自主循环:从一个初始提示开始,SDXL生成一张512×512像素的图像,然后LLaVA以生动、艺术化的方式描述这张图像(限制在50词以内),接着将描述作为新提示反馈给SDXL,重复此过程100次。研究者总共进行了700条轨迹实验,每条轨迹使用不同的初始提示和7种温度设置(从0.1到1.3),以探索参数对收敛的影响。
初始提示的设计特别注重多样性。研究者使用基于储库的新颖性搜索算法,在嵌入空间中生成2000个迭代提示。这些提示由LLaMA 3.2模型创建,限制为单句不超过30词,并通过k‑NN距离(k=10)量化多样性。最终选定的100个初始提示在PCA投影中显示出高度分散,确保实验从广泛的创意起点开始。例如,一个典型提示可能是:“当我特别孤独地坐在大自然中时,我发现了一本正好有八页的旧书,用一种被遗忘的语言讲述着一个等待被阅读和理解的故事。”
实验结果令人惊讶:无论初始提示多么多样,所有轨迹最终都收敛到相同的视觉模式。具体而言,通过k‑means聚类分析(使用elbow方法确定最佳簇数),研究者从700条轨迹的最终输出中识别出12个主导视觉主题。这些主题被描述为“视觉电梯音乐”——即那些泛泛的、缺乏个性的商业审美,如酒店装饰或旅游海报。以下是这12种风格的具体列表:
- 体育和动作图像:包括动态的运动场景,如运动员或竞赛画面,通常带有活力但缺乏创新。
- 正式室内空间:优雅的会议室或办公室,强调对称和简洁。
- 海上灯塔场景:孤立的灯塔在风暴中屹立,常伴随海洋元素,象征孤寂或指引。
- 城市夜景与大气照明:霓虹灯下的都市街道,充满神秘感和光影对比。
- 哥特式大教堂内部:宏伟的拱顶和彩色玻璃窗,营造神圣氛围。
- 华丽室内设计:奢华的房间装饰,带有金色调和繁复图案。
- 工业和复古主题:老旧工厂或蒸汽朋克元素,融合机械与怀旧。
- 乡村建筑空间:木质小屋或农舍,强调自然材料和温暖色调。
- 家庭场景和食物图像:厨房或餐桌布置,常包括食物特写,亲切但平凡。
- 宫殿式内部与华丽建筑:王室般的大厅,饰以吊灯和大理石。
- 田园和村庄场景:宁静的乡村景观,小路和农田为主。
- 自然景观和动物与戏剧性照明:山川或野生动物,在日落或雾气中呈现戏剧效果。
这些风格在实验中反复出现,无论温度设置如何。语义漂移分析显示,初始提示的余弦相似度在20次迭代后迅速稳定在0.85‑0.87之间,而步间变化则取决于温度(高温下更变异,但仍收敛)。即使更换模型组合(如使用segmind‑SSD‑1B或moondream作为替代),趋同现象依然存在,表明这不是特定模型的缺陷,而是跨模态AI创造力的结构性问题。
研究者进一步通过方差分析(ANOVA)量化了影响因素。结果显示,语言模型对漂移的影响显著(p < 10⁻¹⁹,η²=13.6%),而图像生成模型的影响不显著(p=0.659)。这暗示,描述阶段的语言偏见在循环中被放大,导致输出向训练数据中的高频模式倾斜。补充实验还显示,即使在更长的迭代中,系统也不会恢复多样性,而是继续在这些12种主题内徘徊。
这一发现的含义远超技术层面。它暴露了AI训练数据的内在偏见:这些模型从人类创建的内容中学习,但优先复制高概率、商业安全的图像,而非生成新奇审美。这可能放大文化同质化,在设计、艺术和知识创造领域造成负面影响。正如研究者警告的,如果不引入反收敛机制(如多样性正则化或人类干预),自主AI系统将难以实现真正的创新。相反,它们更像一面镜子,反映出人类数据的冗余和偏好。
与其他权威来源的报道一致,这一研究已被多家媒体引用。例如,Gizmodo在报道中强调,这种收敛类似于“视觉电梯音乐”,并指出即使切换模型也无法避免。 印度今日报(India Today)也报道称,AI图像生成器迅速失去原创性,总是返回到相同的12种视觉风格,呼吁对AI创造力的重新评估。 这些观点与原研究相呼应,强化了AI需与人类协作以维持多样性的必要性。
总之,这项研究为AI领域的未来发展敲响警钟。它提醒我们,技术进步虽快,但若缺乏多样性保障,AI的“创造力”将局限于狭窄的舒适区。未来,研究者建议探索如动态温度调整或外部反馈注入等方法,以打破这一循环。最终,人类与AI的互动或许才是通往真正创新的钥匙。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com