
长期以来,网站内容被各家AI爬虫反复抓取用于模型训练,已成为内容发布方普遍面临的问题。由于OpenAI、谷歌、微软、Anthropic等公司各自使用不同的爬虫标识(如GPTBot、Google‑Extended、ClaudeBot等),站长若想限制内容用于AI训练,往往需要逐一在robots.txt中配置规则,操作繁琐且容易遗漏。
2026年10月30日前后,OpenAI、谷歌、微软与Anthropic宣布,将共同支持一套新的统一标准,让内容发布方能够通过单一信号,一次性向多家AI公司表明“拒绝将内容用于生成式AI训练”的偏好。相关消息经多家媒体报道后,于11月1日前后在中文科技圈引发关注。
新标准如何运作
这套机制由Anthropic负责标准事务的技术负责人Kevin Kelley向互联网工程任务组(IETF)提交草案,核心是在网站已有的robots.txt文件中增加一个共享的“策略令牌”(policy token)。
具体写法示例为:
text
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
其中,User‑Agent: __usage_ai‑training 是统一识别标识,Disallow: / 表示禁止全站内容用于训练,Allow 则可针对特定目录(如新闻稿页面)开放例外。支持该标准的AI公司在识别到这一信号后,将限制其相关爬虫将对应内容用于生成式模型训练。
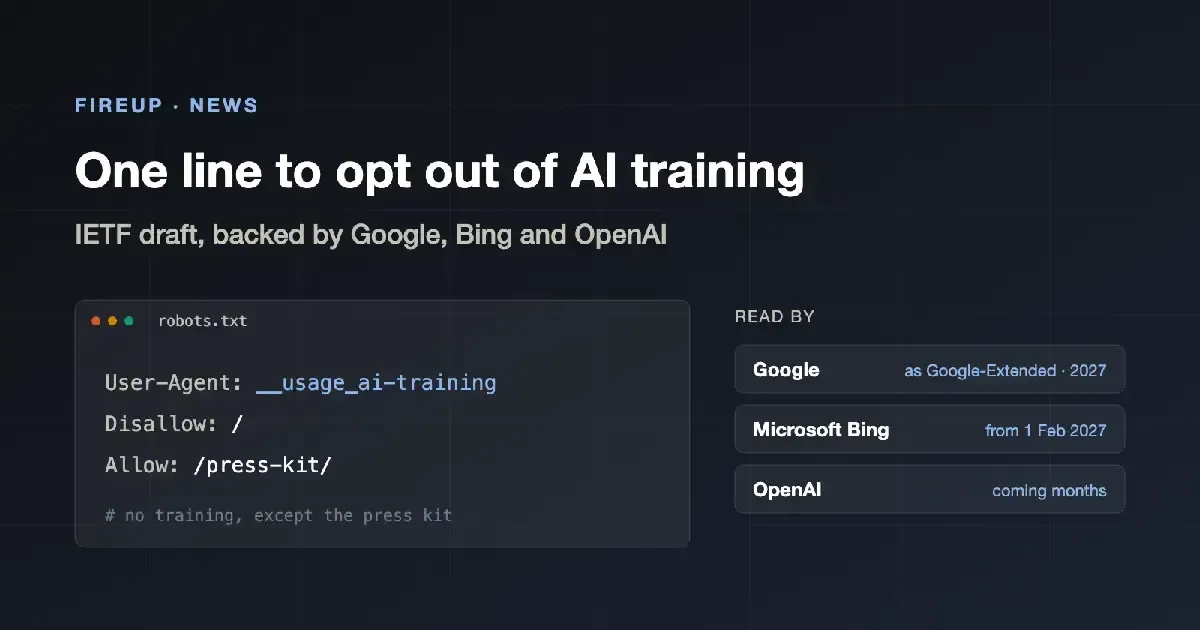
与以往逐家配置不同,新标准旨在让发布方“一次设置、多方生效”。它主要针对生成式AI训练用途,一般不影响传统搜索引擎的正常索引(如Googlebot、Bing爬虫),网站仍可出现在常规搜索结果中。微软还额外提供了更细粒度的控制,允许区分“训练”与“AI grounding”(即模型引用验证来源以降低幻觉),并强调相关设置不会影响Bing搜索可见性。
各公司落地时间表
目前各家推进节奏并不一致:
- Anthropic已率先开始支持;
- OpenAI计划在未来几个月内落地;
- 微软明确将于2027年2月1日起支持;
- 谷歌则计划在2027年初支持,并将其与现有的Google‑Extended控制机制衔接。
Meta相关负责人也表示支持建立此类通用信号,但尚未公布具体落地时间。需要注意的是,该草案目前仍属IETF个人提交的Internet‑Draft,并非已正式生效的互联网标准,实际约束力仍依赖各公司自愿遵守。
意义与局限
这一举措被视为回应内容方长期抱怨的重要一步。此前,站长不得不持续跟踪各家爬虫名称并单独维护规则,管理成本较高。统一信号降低了操作门槛,也有助于将“是否允许用于AI训练”的偏好,从企业间的双边约定,逐步推向更标准化、机器可读的公共协议层。
不过,客观来看,该标准仍有明显边界。首先,它不具追溯效力,无法要求删除或停止使用此前已被抓取并用于训练的内容,只能约束标准生效后的新抓取行为。其次,它主要针对生成式训练场景,并不全面禁止所有爬虫访问,搜索索引、部分实时检索等用途通常仍可继续。此外,协议本身为自愿性质,尚未参与的其他AI公司或小型爬虫并不受此约束。
对内容产业而言,这更像是一次务实的流程优化,而非从根本上解决版权与数据使用争议。未来,统一退出信号能否进一步扩展到更多公司、形成更广泛的行业惯例,以及是否与付费授权、内容许可等商业模式结合,仍有待观察。
总体来看,OpenAI、谷歌、微软与Anthropic共同支持统一AI训练退出标准,标志着头部AI公司在内容抓取规则上开始走向一定程度的协调。对网站主来说,这提供了一个更简便的统一声明方式;对整个行业而言,则是将数据使用偏好从碎片化管理,向标准化信号迈出的一步。实际效果如何,还需看后续落地进度与更多参与方的跟进情况。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com