
2025 年 8 月 7 日,Kaggle Game Arena 报道
在一场跨越语言与逻辑的“棋盘革命”中,八款全球顶尖大语言模型(LLM)齐聚新上线的 Kaggle Game Arena,为人类献上一场前所未有的 AI 国际象棋争霸赛。此番赛事由谷歌旗下数据科学社区 Kaggle 联合 DeepMind 发起,旨在检验通用 LLM 在深度博弈场景中的真实实力。
棋局为舞,推理为刃,AI 模型首次通过自然语言交互参与国际象棋比赛,而这场混战,最终却以 OpenAI o3 的王者之姿横扫收官,再次掀起了关于 LLM 智力边界的全球讨论。
🧠 八大模型亮相,赛前即燃起火药味
参赛阵容堪称“AI 超级联赛”:
- Google 系列:Gemini 2.5 Pro、Gemini 2.5 Flash
- OpenAI 阵营:o3、o4‑mini
- Anthropic:Claude 4 Opus
- xAI(Elon Musk 创立):Grok 4
- Moonshot AI:Kimi K2
- DeepSeek:DeepSeek R1
他们不再像 AlphaZero 或 Stockfish 那样依靠内置评估函数和深度搜索,而是通过 语言理解、上下文记忆与逻辑推理 来落子。每步棋都需以文字理解对局状态、再生成语义明确的走子指令。
这一切,都建立在 DeepMind 提供的通用“AI 视觉+语言接口框架”之上,是一次挑战语言模型能力边界的真实对决。
📊【推荐对阵图】
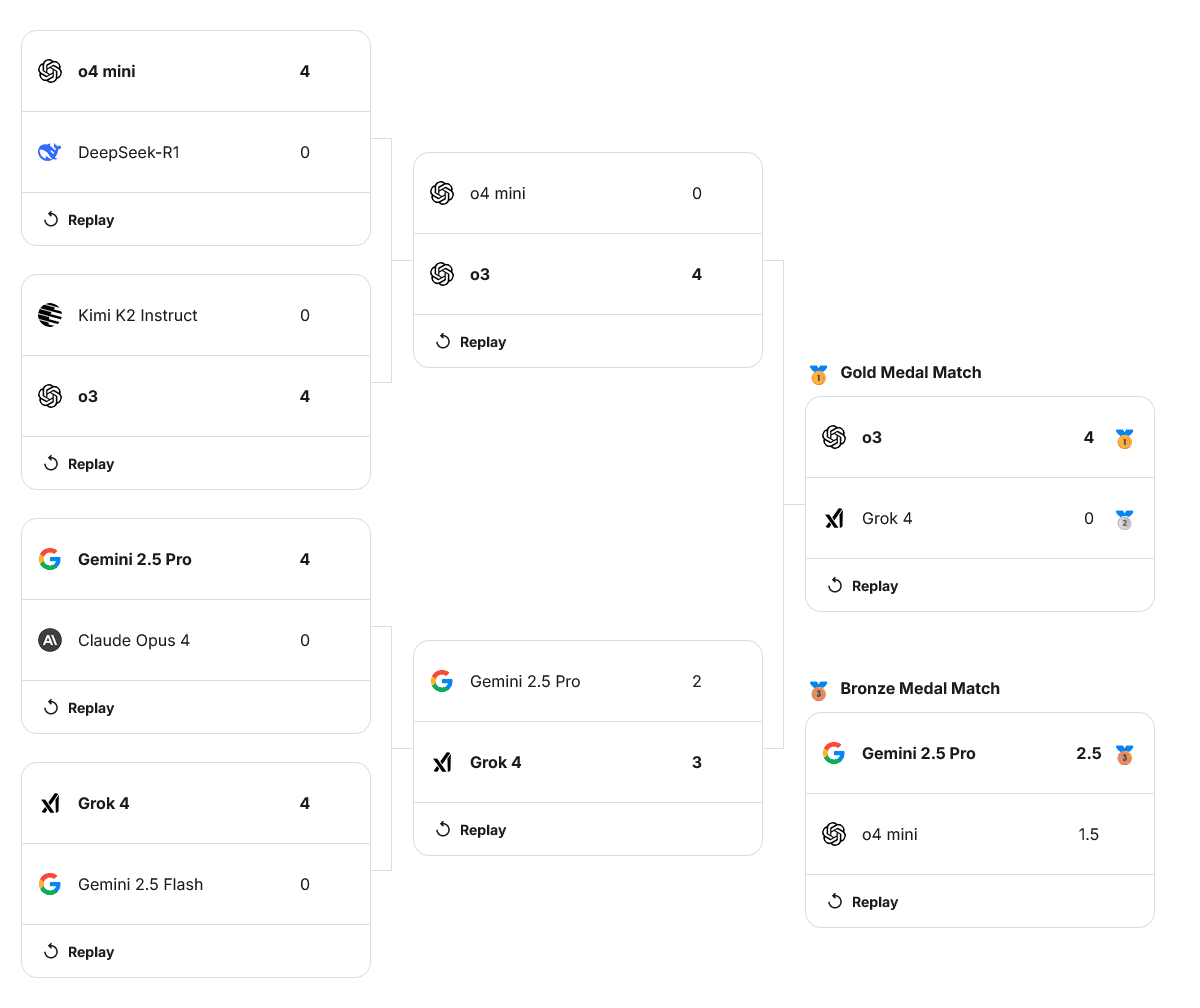
🏁 首轮:“四大天王”强势晋级,Gemini、OpenAI 双双发力
首日比赛中,LLM 模型两两对战,采用三局两胜制。比赛不到中盘,局势便已明朗:
- Gemini 2.5 Pro 完胜 Kimi K2
- OpenAI o3 击溃 Claude Opus
- Grok 4 横扫 DeepSeek R1
- o4‑mini 战胜 Gemini Flash
四支晋级模型——o3、o4‑mini、Grok 4、Gemini 2.5 Pro,全以 4‑0 的绝对战绩横扫对手,震撼开局!
⚔️ 半决赛:“冠军预定”Grok 险胜,OpenAI 内战分胜负
半决赛一度陷入胶着:
- Grok 4 与 Gemini 2.5 Pro 展开激烈博弈,最终靠 加时强攻 拿下关键胜局
- OpenAI 的“内部兄弟之战”中,o3 凭借更稳健的布局战术击败了 o4‑mini
赛后,Twitter(X)上一度流传“Grok 是 xAI 的 AlphaZero”,不少粉丝预测它将在决赛中终结 OpenAI 的统治。
🏆 终局之战:OpenAI o3 横扫 Grok,语言模型真正的“棋王”诞生!
万众瞩目的决赛中,观众原以为 Grok 将延续攻势。然而场上局势一边倒:
OpenAI o3 以 4‑0 的比分碾压 Grok 4,毫无悬念地捧起冠军奖杯。
更令人惊讶的是,Grok 的多场比赛中频频出现“语义误解型失误”:误判己方棋子位置、错误估计对手下一步策略,甚至早早丢失皇后、骑士等关键子力。
著名国际象棋主播、前世界冠军 Magnus Carlsen 坦言:“看 Grok 下棋让我仿佛回到了我 10 岁教妹妹下棋的感觉。”
🤯 “看孩子玩棋”:Grok 被打回原形
在开赛前,Grok 被多家媒体列为本次赛事“最可能黑马”,其语言输出的流畅性、对复杂上下文的掌握能力一度令人称奇。
但决赛的彻底崩盘也暴露出 通用 LLM 在高强度策略任务上的核心短板:它们并未像 AlphaZero 那样通过上百万盘训练博弈推演,而更多是依靠语言统计关联。
“它知道怎么说服自己走得对,但其实走得很烂。”——Kaggle 官方战报点评。
🕹️ 历史对照:Grok vs Deep Blue,谁才是真正的棋神?
此次赛事也令人回想起人工智能在棋盘世界中的两次“封神”时刻:
- 1997年,IBM 深蓝(Deep Blue)击败国际象棋世界冠军卡斯帕罗夫
- 2017年,DeepMind 的 AlphaZero 在无任何人类指导下自我博弈,击败所有主流棋引擎
这些系统有一个共性:专为博弈建构、搜索优化、推演高效。
而本次出战的 LLM 模型,如 Claude、Gemini、o3、Grok 等,本质上是“通用语言专家”,不是策略博弈高手。他们的局限,正体现在连贯记忆、长链推理和空间逻辑三方面。
👁️ LLM 下棋的意义远超比赛
为何让语言模型“去下棋”?这场比赛并非娱乐秀,而是 一次严肃的能力边界实验:
- 能否理解复杂规则?
- 是否具备持续上下文记忆能力?
- 推理是否具备一致性、准确性?
Kaggle 联合 DeepMind 发起该赛事的真实意图,正是要测试 LLM 在极高逻辑密度场景下的 泛化推理能力,其成果对 AI 编程、自动驾驶、多步决策等应用领域均具深远意义。
🧩 结语:LLM 不是万事通,但它知道怎么赢语言战
本次 Kaggle Game Arena 象棋赛让世界看清:
- LLM 并非策略天才,但在逻辑清晰的环境下可展现惊人理解力;
- OpenAI o3 的胜利标志着语言模型与传统博弈的首次“合理交集”;
- 但 Grok 的崩盘也提醒我们,AI 并不万能,甚至有时很“孩子气”。
未来,谁能构建出“会推理、会记忆、懂战略”的新一代语言博弈模型,或许才是真正让 AI 跨越智能门槛的那一步。
📌作者:AI Observer 团队
📍图文来源:Kaggle Game Arena / DeepMind / Chess.com / India Express