
近年来,人工智能(AI)以前所未有的速度改变全球科技产业。以大语言模型(LLM)为代表的生成式AI,正在从实验室走向产业实践,并逐渐渗透到软件开发、科学研究、医疗诊断、金融服务、自动驾驶和智能制造等领域。从ChatGPT到多模态模型,从AI Agent到世界模型,今天的人工智能已经不再局限于单一算法或应用场景,而是在逐步形成覆盖模型、算力、数据和应用的完整技术体系。
然而,这场变革并非一蹴而就。今天的AI技术建立在过去数十年积累的基础研究之上。一些看似已经成为基础设施的算法和技术,例如ResNet、Adam、Transformer、BERT、U‑Net和Scikit‑learn,实际上都源于具有里程碑意义的学术论文。它们不仅推动了算法本身的突破,也改变了后续研究的方向和产业技术路线。
本网站曾于2025年6月发表《2025年AI领域十大高被引论文全解析:深度学习与生成模型的里程碑》,介绍了当时引用量较高的十篇AI论文。经过一年多的发展,我们重新审视这些经典研究,并结合截至2026年11月能够获取的最新引文数据,对其影响力进行更新。
需要说明的是,论文引用量并不存在一个全球统一的统计口径。不同的统计途径如Google Scholar、Semantic Scholar以及其他学术数据库在论文版本合并、收录范围和引用识别方面存在较大差异。因此,本文并不专注于具体比较多个数据统计的比较,将不同数据库的数据混合成一个严格的全球排名,而是以google scholar上的最新数据为主,选取十篇其引用数据最多的具有代表性的高引用论文,观察它们的学术影响力及其在AI技术发展中的地位。
一、十篇代表性AI论文的引用数据变化
下表将2025年原文记录的引用量与目前可以查到的最新Google Schloar统计数据进行对照。由于两次统计的数据库和收录口径未必完全一致,表中数字主要用于观察量级和变化趋势,不能将差值直接理解为同一数据库在这一时期内新增的引用次数。
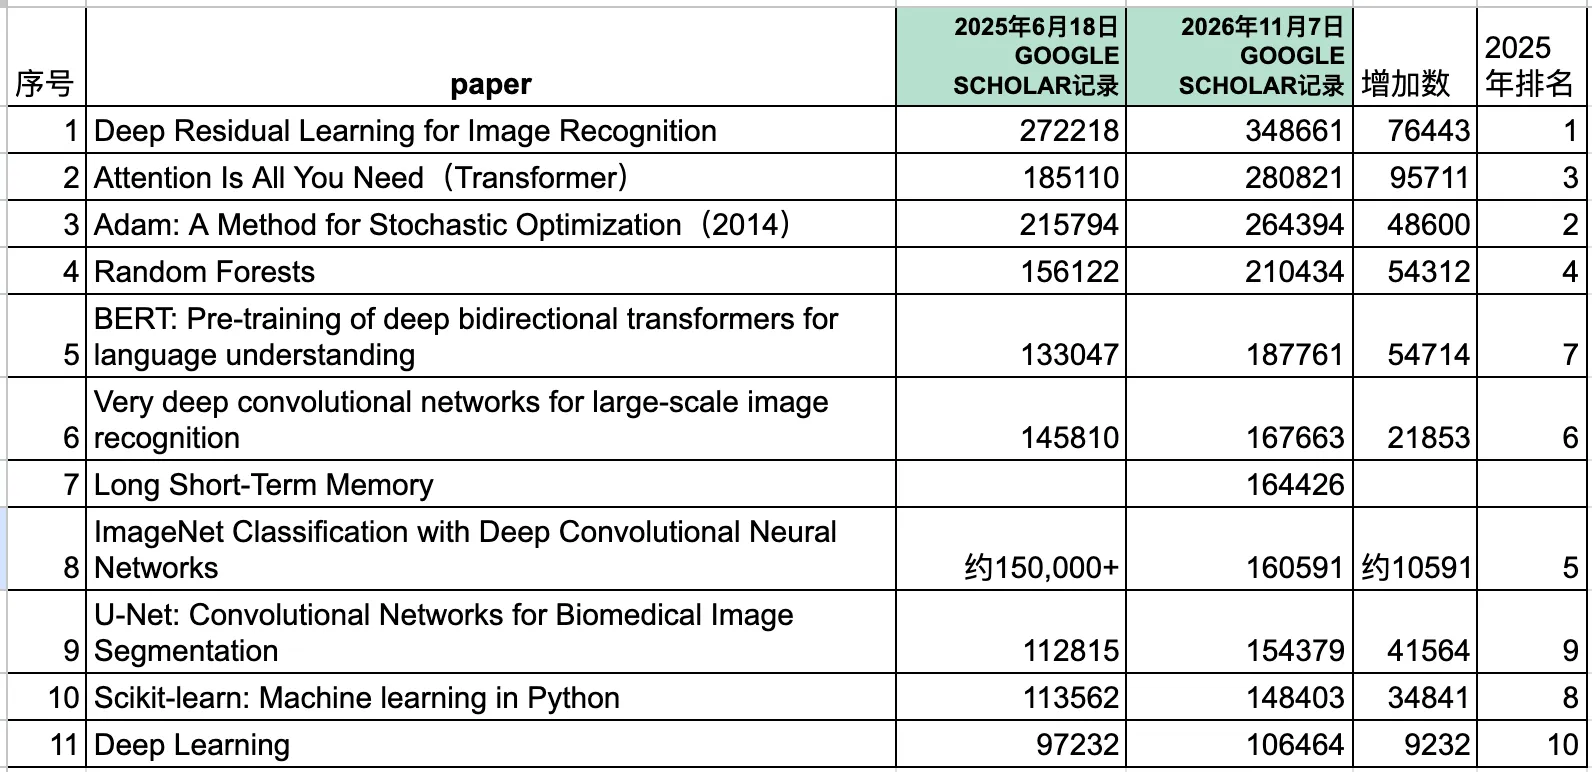
从这组数据可以看到几个值得关注的现象。
首先,Transformer和Adam依然是深度学习领域最具影响力的基础研究之一。它们分别解决了序列建模和神经网络优化中的关键问题,至今仍然是大量现代AI系统的技术基础。
其次,ResNet的影响力依然突出。它提出的残差连接已经成为深度神经网络设计中的重要思想,并不局限于图像识别领域。
第三,经典视觉模型并没有因为生成式AI的兴起而失去学术价值。AlexNet、VGG和U‑Net所代表的研究,仍然构成计算机视觉技术发展史的重要组成部分。
第四,Long Short‑Term Memory在去年的榜单中遗漏,本次将其加入,它是Transformer之前最受欢迎的深度学习框架之一。
二、十篇具有代表性的AI里程碑论文
1. Deep Residual Learning for Image Recognition(ResNet,2015/2016)
作者:Kaiming He、Xiangyu Zhang、Shaoqing Ren、Jian Sun
论文链接:arXiv:1512.03385
ResNet是现代深度学习发展史上最重要的架构创新之一。何恺明等人在2015年提出这一方法,并于2016年发表相关会议论文,解决了深度神经网络在不断增加层数时出现的优化退化问题。
传统神经网络通常直接学习输入到输出的映射关系,而ResNet引入了残差学习机制,让网络学习输入与目标输出之间的差值。其核心表达式为:
[H(x)=F(x)+x]
其中,(x)是输入,(F(x))是网络需要学习的残差映射。通过恒等映射跳跃连接,输入可以直接传递到后续层,从而改善深层网络的优化过程。
论文提出了ResNet‑34、ResNet‑50、ResNet‑101和ResNet‑152等不同深度的网络结构。其中,ResNet‑152在ImageNet图像分类任务中取得了当时领先的结果,推动深度神经网络进入更深层次的架构设计阶段。
技术影响:
- 残差连接成为深度神经网络的重要基础设计。
- 推动了DenseNet、Inception‑ResNet等后续架构的发展。
- 残差思想被广泛应用于Transformer、视觉模型和多模态网络。
ResNet的重要性并不仅仅在于它提高了图像识别准确率,更在于它改变了研究人员构建深层神经网络的方式。
2. Attention Is All You Need(Transformer,2017)
作者:Ashish Vaswani等八位研究人员
论文链接:arXiv:1706.03762
如果说ResNet改变了深度视觉网络的设计方式,那么Transformer则彻底改变了自然语言处理的发展方向。
2017年,Google研究团队发表《Attention Is All You Need》,提出完全基于注意力机制的序列建模架构,摆脱了传统循环神经网络(RNN)对序列逐步处理的依赖。
Transformer的核心是自注意力机制(Self‑Attention)。模型通过Query、Key和Value三个向量计算序列中不同Token之间的关联程度,使每个Token能够根据上下文动态聚合其他Token的信息。
其核心计算形式为:
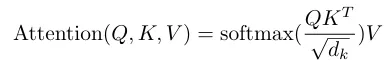
这一设计带来了几个重要突破:
- 并行计算: 相比传统RNN,Transformer能够更充分地利用GPU进行并行训练。
- 长距离依赖建模: 自注意力机制能够直接建立序列不同位置之间的联系。
- 架构扩展性: 模型可以通过增加层数、隐藏维度和训练数据规模持续扩展。
原始Transformer在WMT 2014英德和英法机器翻译任务中分别取得28.4和41.8的BLEU成绩,展示了注意力架构在序列建模中的优势。
此后,BERT、GPT、T5以及大量多模态模型都采用了Transformer或其衍生结构。今天的大语言模型技术体系,很大程度上建立在这篇论文提出的架构思想之上。
技术影响: Transformer不仅是一种新的神经网络架构,更是现代基础模型发展的关键起点。它使研究人员能够通过扩大模型规模、训练数据和计算资源,持续探索更强大的模型能力。
3. Adam: A Method for Stochastic Optimization(2014)
作者:Diederik P. Kingma、Jimmy Ba
论文链接:arXiv:1412.6980
Adam(Adaptive Moment Estimation)是深度学习中最具影响力的优化算法之一。它结合了Momentum的一阶动量估计和RMSProp的二阶动量估计,为不同模型参数提供自适应学习率。
Adam通过指数加权平均分别估计梯度的一阶矩和二阶矩,并通过偏差校正改善训练早期的估计效果。
其主要优势包括:
- 为不同参数自动调整学习率。
- 对稀疏梯度和非平稳目标函数具有较好的适应能力。
- 在许多深度学习任务中能够提供稳定、高效的优化表现。
Adam及其变体AdamW、AMSGrad、RAdam等,已经广泛应用于Transformer、BERT、GPT及各类生成模型的训练。
值得注意的是,Adam并非在所有任务中都优于SGD。例如,在部分计算机视觉任务中,经过精心调参的SGD仍然具有竞争力。但Adam的通用性和易用性,使其成为现代深度学习训练流程中的重要基础工具。
技术影响: Adam的意义在于降低了深度神经网络优化的工程门槛,使研究人员能够更高效地训练复杂模型。随着模型规模不断增长,优化算法的稳定性和效率仍然是决定模型训练成本的重要因素。
4. Random Forests(2001)
作者:Leo Breiman
论文链接:Machine Learning期刊
Random Forests(随机森林)是传统机器学习领域最具代表性的集成学习算法之一。
Leo Breiman在2001年发表的论文系统提出了随机森林方法,通过组合多棵决策树来提高预测性能和模型泛化能力。
其核心机制包括:
- Bootstrap采样: 从原始训练数据中有放回地抽取多个子集。
- 随机特征选择: 每棵树在节点分裂时只考虑随机选取的部分特征。
- 集成决策: 分类任务通过多数投票,回归任务通过平均预测结果形成最终输出。
随机森林具有较强的鲁棒性,能够处理非线性关系,并且可以提供特征重要性分析,因此在金融风控、医学诊断、生物信息和工业预测等领域仍然具有广泛应用。
与近年来快速发展的深度学习相比,随机森林不需要大量GPU资源,也不一定需要海量训练数据。在结构化数据任务中,它依然是值得优先考虑的基线模型。
技术影响: 这篇论文证明了通过多个相对简单的模型进行合理集成,可以获得比单一模型更稳定的预测能力。集成学习思想至今仍然影响着机器学习系统的设计。
5. BERT: Pre‑training of Deep Bidirectional Transformers for Language Understanding(2018)
作者:Jacob Devlin、Ming‑Wei Chang、Kenton Lee、Kristina Toutanova
论文链接:arXiv:1810.04805
BERT是自然语言处理发展史上的重要里程碑。
2018年,Google AI团队提出BERT(Bidirectional Encoder Representations from Transformers),通过双向Transformer编码器学习文本的上下文表示,改变了传统自然语言处理任务中针对不同任务分别训练模型的方式。
BERT采用大规模无标注文本进行预训练,再针对具体任务进行微调,主要使用两种训练目标:
- Masked Language Modeling(MLM): 随机遮盖输入文本中的部分Token,让模型根据上下文预测被遮盖的内容。
- Next Sentence Prediction(NSP): 在原始BERT中,通过判断两个句子是否具有连续关系,帮助模型学习句子之间的关系。
BERT在GLUE、SQuAD和SWAG等多项自然语言理解基准测试中取得了当时领先的成绩。
它的主要贡献在于证明了大规模预训练模型可以学习通用语言表示,并通过微调迁移到不同的下游任务。
技术影响:
- 推动了预训练语言模型成为自然语言处理的主流方法。
- 催生了RoBERTa、ALBERT和DistilBERT等模型。
- 为搜索、文本分类、问答和语义理解系统提供了重要技术基础。
需要区分的是,BERT属于以编码器为核心的双向语言表示模型,而GPT系列主要采用自回归生成方式。两者都建立在Transformer基础之上,但训练目标和应用方向有所不同。
6. Very Deep Convolutional Networks for Large‑Scale Image Recognition(VGG,2014)
作者:Karen Simonyan、Andrew Zisserman
论文链接:arXiv:1409.1556
VGG网络由牛津大学视觉几何组提出,系统研究了增加卷积网络深度对图像识别性能的影响。
其最具代表性的结构是VGG‑16和VGG‑19。VGG的核心设计理念是使用多个连续的3×3小卷积核替代较大的卷积核,通过增加网络深度提升特征表达能力。
例如,多个3×3卷积层可以在获得较大感受野的同时,引入更多非线性变换。
VGG的主要特点包括:
- 结构简单,网络模块高度规则。
- 通过小卷积核堆叠增加网络深度。
- 能够提取具有较强表达能力的视觉特征。
VGG在ImageNet 2014竞赛中取得了优异成绩。尽管其参数量和计算成本较高,但其结构清晰、易于理解和复现,因此长期被用于视觉研究和迁移学习。
技术影响: VGG证明了网络深度和结构设计对视觉特征学习的重要性,也为后续深度卷积网络的发展提供了重要参考。
7. Long Short‑Term Memory(LSTM,1997)
作者: Sepp Hochreiter、Jürgen Schmidhuber
论文链接: DOI: 10.1162/neco.1997.9.8.1735
如果说传统循环神经网络(RNN)开启了序列数据建模,那么LSTM则解决了传统RNN难以学习长期依赖关系的重要问题,为后来的自然语言处理和序列学习奠定了基础。
1997年,Hochreiter和Schmidhuber发表《Long Short‑Term Memory》,提出长短期记忆网络。其核心创新是在循环神经网络中引入记忆单元(Cell State)和门控机制,使模型能够有选择地保留、更新和输出历史信息,从而缓解传统RNN训练过程中容易出现的梯度消失问题。
LSTM主要包含三个门控结构:
- 遗忘门(Forget Gate): 决定哪些历史信息需要保留,哪些可以丢弃。
- 输入门(Input Gate): 控制当前输入中的哪些信息写入记忆单元。
- 输出门(Output Gate): 决定记忆单元中的哪些信息用于当前输出。
这一设计带来了几个重要突破:
- 长期依赖学习: 改善传统RNN难以捕捉长距离信息关联的问题。
- 动态记忆管理: 模型能够根据输入内容决定信息的保留、更新和输出。
- 广泛的应用能力: 适用于自然语言处理、语音识别、机器翻译和时间序列预测等任务。
此后,LSTM及其变体GRU成为Transformer出现之前序列建模领域的主流架构。2017年Transformer提出后,注意力机制逐渐成为大规模语言模型的核心技术,但LSTM至今仍在部分实时语音处理、时间序列预测和资源受限场景中发挥作用。
技术影响: LSTM的重要贡献不仅是改进了RNN的训练方式,更在于证明了神经网络可以通过专门设计的信息控制机制,有效管理长期上下文。这一思想也为后来研究如何在神经网络中组织、筛选和利用信息提供了重要启发。
8. ImageNet Classification with Deep Convolutional Neural Networks(AlexNet,2012)
作者:Alex Krizhevsky、Ilya Sutskever、Geoffrey Hinton
论文链接:ACM Digital Library
AlexNet是深度学习发展史上的关键转折点。
2012年,Alex Krizhevsky、Ilya Sutskever和Geoffrey Hinton利用深度卷积神经网络,在ImageNet大规模图像分类竞赛中取得突破性成绩。该模型包含约6000万个参数,使用5个卷积层和3个全连接层,在当年的ImageNet分类任务中取得约15.3%的Top‑5错误率,明显优于当时的传统方法。
AlexNet的主要技术创新包括:
- ReLU激活函数: 改善深层网络的训练效率。
- GPU并行训练: 利用两块GPU完成大规模图像模型训练。
- Dropout: 降低全连接层的过拟合风险。
- 数据增强: 通过图像变换提升模型泛化能力。
AlexNet最重要的意义,是证明了在大规模数据集和GPU计算支持下,深度卷积神经网络能够显著超越当时的传统图像识别方法。
这一成果直接推动了深度学习在计算机视觉领域的普及,也加速了GPU在人工智能研究中的应用。
技术影响: AlexNet标志着深度学习在现代计算机视觉领域取得决定性突破,并成为后来ResNet、VGG和其他视觉网络发展的重要基础。
9. Scikit‑learn: Machine Learning in Python(2011)
作者:F. Pedregosa等
论文链接:Journal of Machine Learning Research
Scikit‑learn并不是一种新的机器学习算法,而是一个极具影响力的Python机器学习工具库。
2011年,Fabian Pedregosa等人发表论文,系统介绍了Scikit‑learn的设计理念、算法实现和软件架构。
Scikit‑learn提供了统一的API,覆盖分类、回归、聚类、降维、特征处理、模型选择和评估等多个机器学习环节。
其最重要的工程设计之一,是统一了模型训练与预测接口:
fit():训练模型。predict():生成预测结果。transform():进行特征转换。
这种标准化接口极大降低了机器学习应用开发的复杂度,使研究人员能够更加方便地切换算法、组合处理流程和开展实验。
技术影响: Scikit‑learn推动了Python成为机器学习和数据科学领域的重要开发语言,也建立了大量开发者熟悉的机器学习工程实践规范。
10. U‑Net: Convolutional Networks for Biomedical Image Segmentation(2015)
作者:Olaf Ronneberger、Philipp Fischer、Thomas Brox
论文链接:arXiv:1505.04597
U‑Net最初是为生物医学图像分割任务设计的深度学习架构,后来成为图像分割领域最具影响力的网络结构之一。
其核心设计是对称的编码器—解码器结构:
- 编码器逐步降低图像空间分辨率,提取更高层次的语义特征。
- 解码器逐步恢复空间分辨率,生成精细的像素级预测。
- 跳跃连接将编码器中的高分辨率特征传递给解码器,弥补下采样过程中丢失的空间信息。
U‑Net尤其适合医学图像分割,因为医学影像往往需要在有限训练样本下准确识别器官、组织和病变区域。
此后,U‑Net及其衍生架构被广泛应用于医学影像、遥感、农业、工业检测和自动驾驶等领域。
技术影响: U‑Net建立了经典的编码器—解码器分割架构范式,其跳跃连接设计也影响了后续大量视觉模型。
11. Deep Learning(2015)
作者:Yann LeCun、Yoshua Bengio、Geoffrey Hinton
论文链接:Nature
2015年,Yann LeCun、Yoshua Bengio和Geoffrey Hinton在Nature发表综述论文《Deep Learning》,系统总结了深度学习的基本原理、发展历史和主要应用。
文章回顾了深度神经网络在计算机视觉、语音识别和自然语言处理等领域的进展,并分析了大规模数据、GPU计算和优化算法对深度学习发展的推动作用。
论文强调了深度学习的核心思想:通过多层神经网络逐步学习数据的层次化表示,从原始输入中自动提取具有不同抽象程度的特征。
它不仅总结了CNN、RNN和深度生成模型等技术,也解释了为什么深层网络能够在复杂任务中取得优异表现。
技术影响:
- 系统总结了深度学习的理论基础和技术发展。
- 推动深度学习成为人工智能研究的核心方向。
- 为后续大规模神经网络、Transformer和基础模型的发展提供了重要背景。
尽管它退出了前十榜单,但是作为深度学习的总结奠基之作,这篇论文的价值不仅在于总结已有成果,也在于帮助学术界和产业界理解深度学习技术革命背后的共同规律。
三、从十篇经典论文看AI技术发展的三个阶段
回顾这十篇论文,可以发现现代AI的发展并不是由某一个算法单独推动的,而是多个基础技术方向相互促进的结果。
第一阶段:深度学习基础能力的建立
AlexNet、VGG和ResNet代表了深度卷积神经网络的发展过程。
AlexNet证明了GPU、大规模数据和深度神经网络结合的巨大潜力;VGG进一步探索了网络深度与特征表达之间的关系;ResNet则解决了深层网络训练中的重要优化问题。
这一阶段的核心任务,是让神经网络能够从大量数据中自动学习复杂特征。
第二阶段:通用模型与工程化体系的形成
Adam、Random Forests和Scikit‑learn分别代表了模型优化、集成学习和机器学习工程化三个方向。
这些研究共同推动了机器学习从单一算法实验走向可复用、可扩展的工程体系。
与此同时,BERT和U‑Net进一步展示了预训练模型与特定任务架构的价值,使AI能够在语言理解和精细视觉任务中取得更强的表现。
第三阶段:Transformer与基础模型时代
2017年Transformer的提出,是现代AI发展史上的关键转折点。
与传统针对单一任务设计的模型相比,Transformer具备更强的并行计算能力和架构扩展能力。通过扩大模型参数、训练数据和计算资源,研究人员逐步构建出具有通用表示和生成能力的基础模型。
此后,大语言模型、多模态模型和AI Agent快速发展,人工智能开始从单一任务模型向能够处理多种任务的通用系统演进。
四、经典论文的引用量意味着什么?
论文引用量是衡量学术影响力的重要指标,但它并不等于技术价值,也不能简单理解为某项技术的实际应用规模。
一篇论文被大量引用,可能意味着它提出了新的基础方法,也可能是因为它成为某个研究方向的标准参考文献,或者提供了广泛使用的工具和数据集。
例如,Transformer的影响力不仅来自论文本身的引用数量,更来自它对整个大模型技术路线的深刻影响;Scikit‑learn的价值则更多体现在机器学习工程生态和开发者实践中。
因此,评价一篇AI论文的历史地位,至少需要考虑三个维度:
- 学术影响力: 论文被后续研究引用的广度和深度。
- 技术影响力: 论文提出的方法是否改变了后续算法和模型架构的设计。
- 产业影响力: 相关技术是否真正进入主流软件、硬件和商业产品。
从这个角度看,引用量只是观察AI技术演进的一扇窗口,而不是衡量技术贡献的唯一标准。
结语:AI的下一次技术突破会来自哪里?
这十篇论文跨越了二十多年,覆盖了深度学习、优化算法、计算机视觉、自然语言处理和机器学习工程等多个方向。它们共同构成了今天人工智能技术体系的重要基础。
但AI的发展并没有停留在Transformer时代。
当前的研究正在向更复杂的方向演进,包括推理能力、强化学习、多模态融合、世界模型、具身智能、AI Agent和持续学习等。未来的突破可能不再仅仅来自扩大模型参数规模,而是来自更有效的数据组织、更高效的训练方法、更合理的模型架构,以及模型与真实物理世界之间更紧密的交互。
从AlexNet到ResNet,从BERT到Transformer,再到今天的大语言模型,每一次重要突破都建立在此前研究成果的基础之上。
真正改变AI发展方向的,往往不是某一个模型有多大,而是研究人员是否提出了一种能够被整个技术体系持续采用的新方法。 这也正是这些经典论文在多年之后仍然值得重新阅读的原因。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com