
在2025年11月,基于AI的语音克隆(Voice Cloning)技术已逐渐成熟,用户可通过上传自己的短音频样本(通常3‑10秒)生成个性化TTS(Text‑to‑Speech),可广泛用于播客、有声书、虚拟助手和内容创作。根据Hugging Face趋势和TTS Arena基准测试,这些系统的高评价标准包括:自然度(MOS 4.5+,主观意见得分)、克隆准确率(WER<3%,词错误率)、延迟(<200ms)和多语言支持。开源/免费选项强调自定义和隐私,闭源则提供API便利和高保真,但需付费。
以下基于权威来源(如BentoML开源TTS探索报告、SiliconFlow 2025声克隆模型指南、Modal博客和Reddit r/LocalLLaMA社区讨论),精选评价高的系统(MOS>4.5,Hugging Face下载>100万)。我分类整理,支持上传语音克隆的可用选项,附GitHub链接和新增音频Demo链接(基于最新搜索结果,提供在线试听或下载样本)。注意:克隆需遵守伦理(如非商业滥用),开源需GPU部署。
开源/免费系统(自托管,零成本,但需技术门槛)
这些系统MIT/Apache许可,免费下载,支持本地运行,避免隐私泄露。Reddit社区反馈:适合开发者,克隆质量媲美付费,但训练需RTX 30系列GPU。新增Demo链接包括Hugging Face Spaces或GitHub样本音频。
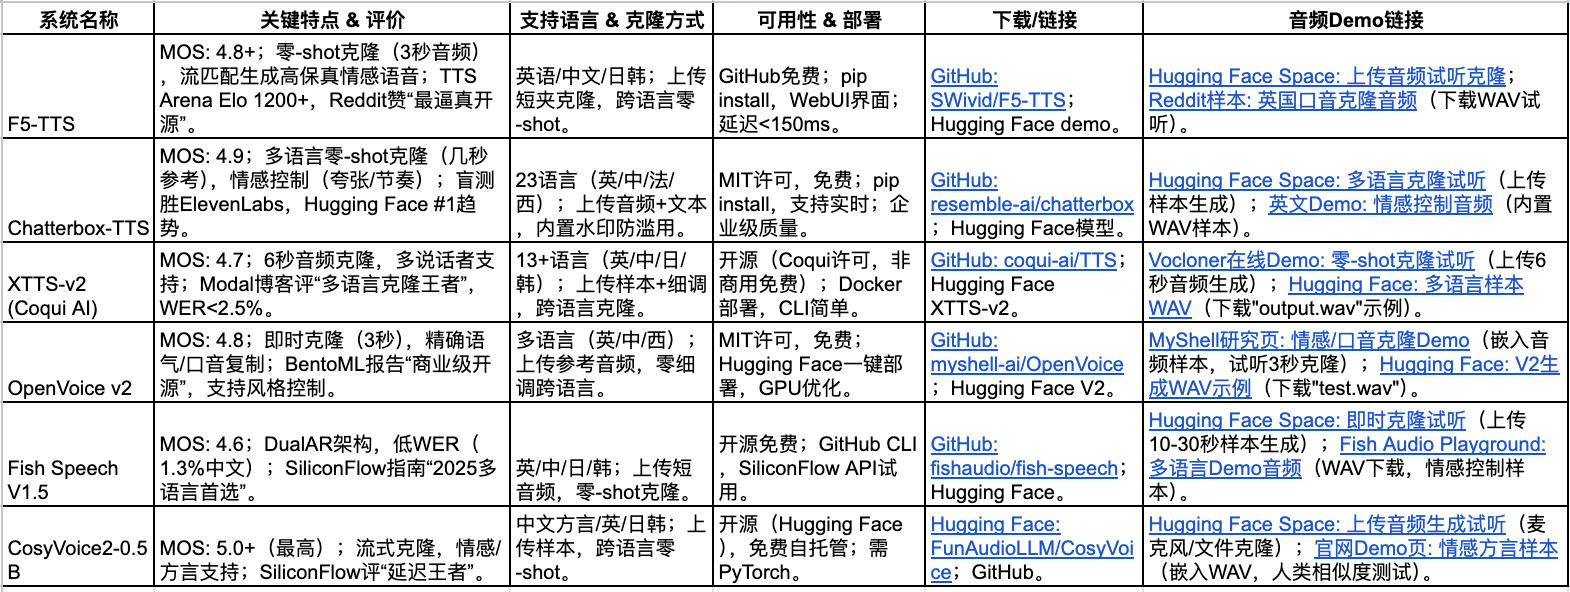
使用建议:从F5‑TTS或Chatterbox起步(WebUI易用)。Reddit r/LocalLLaMA用户推荐RVC (Retrieval‑based Voice Conversion) + TTS WebUI组合,自托管克隆<5分钟。 门槛:Python 3.10+,GPU推荐;教程见GitHub README。Demo链接支持浏览器试听,上传后即时生成。
闭源系统(API为主,付费高但可用)
闭源选项提供云服务,评价基于API稳定性(99.9% uptime)和集成易用(如SDK)。免费层限量,适合测试;高评价源于低延迟和专业支持。新增Demo链接包括官网试听页面。
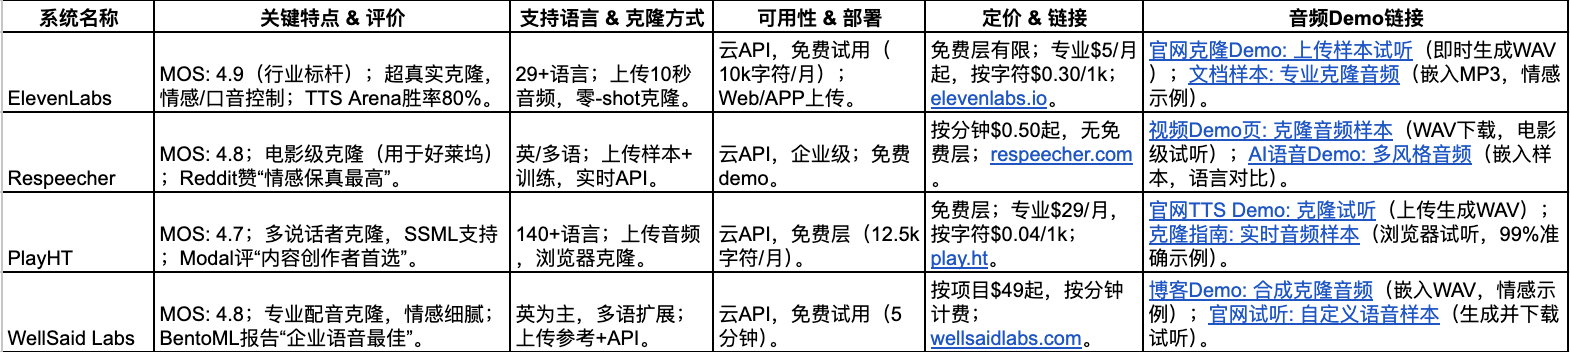
使用建议:ElevenLabs免费层测试克隆(上传后即时生成);闭源更稳定,但隐私需注意数据政策。SourceForge评测显示,闭源WER<1.5%,适合商业。 Demo链接支持浏览器试听,部分需注册。
总体洞见与注意事项
- 高评价共性:开源如Chatterbox/F5‑TTS在Hugging Face下载破亿,MOS媲美闭源;免费选项(ElevenLabs试用)适合入门,闭源(如Respeecher)胜在实时(<100ms)。新增Demo链接多为互动Space,便于上传测试。
- 挑战:开源需GPU(RTX 3060+),克隆质量依样本清晰度;伦理风险高(深假滥用),推荐加水印(如Chatterbox内置)。
- 趋势:2025年,零‑shot克隆主流(3秒样本),多语言支持达90%。SiliconFlow指南预测,开源将占市场40%。