
“1GW的算力”本质上是一个 动态、随时间演进的估算指标,而不是固定不变的计算能力。它更像是一个“电力预算下的算力上限”,随着芯片效率、架构创新、软件优化和能源利用率的提升,同等1GW电力在未来能支撑的实际计算能力(FLOPS)会成倍增长。
我们可以从 历史趋势、物理极限 和 2027年预测 三个维度来拆解这个问题。
一、为什么“1GW算力”是动态的?
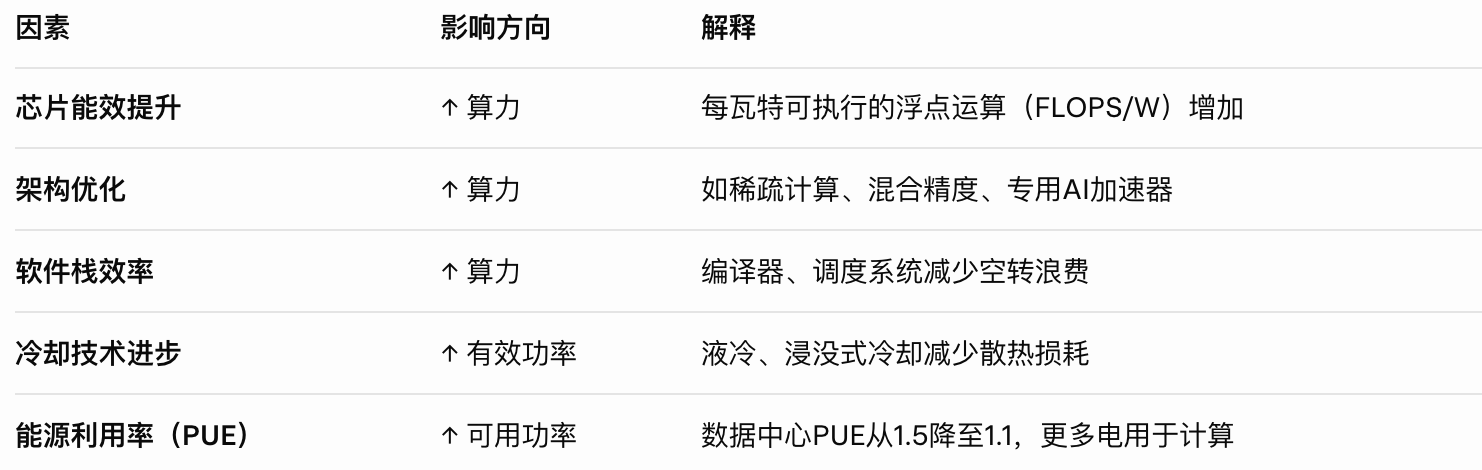
因素影响方向解释芯片能效提升↑ 算力每瓦特可执行的浮点运算(FLOPS/W)增加架构优化↑ 算力如稀疏计算、混合精度、专用AI加速器软件栈效率↑ 算力编译器、调度系统减少空转浪费冷却技术进步↑ 有效功率液冷、浸没式冷却减少散热损耗能源利用率(PUE)↑ 可用功率数据中心PUE从1.5降至1.1,更多电用于计算
核心结论:1GW电力 ≠ 固定算力,它是“可变容量的油箱”。
二、历史数据:1GW能买到多少算力?
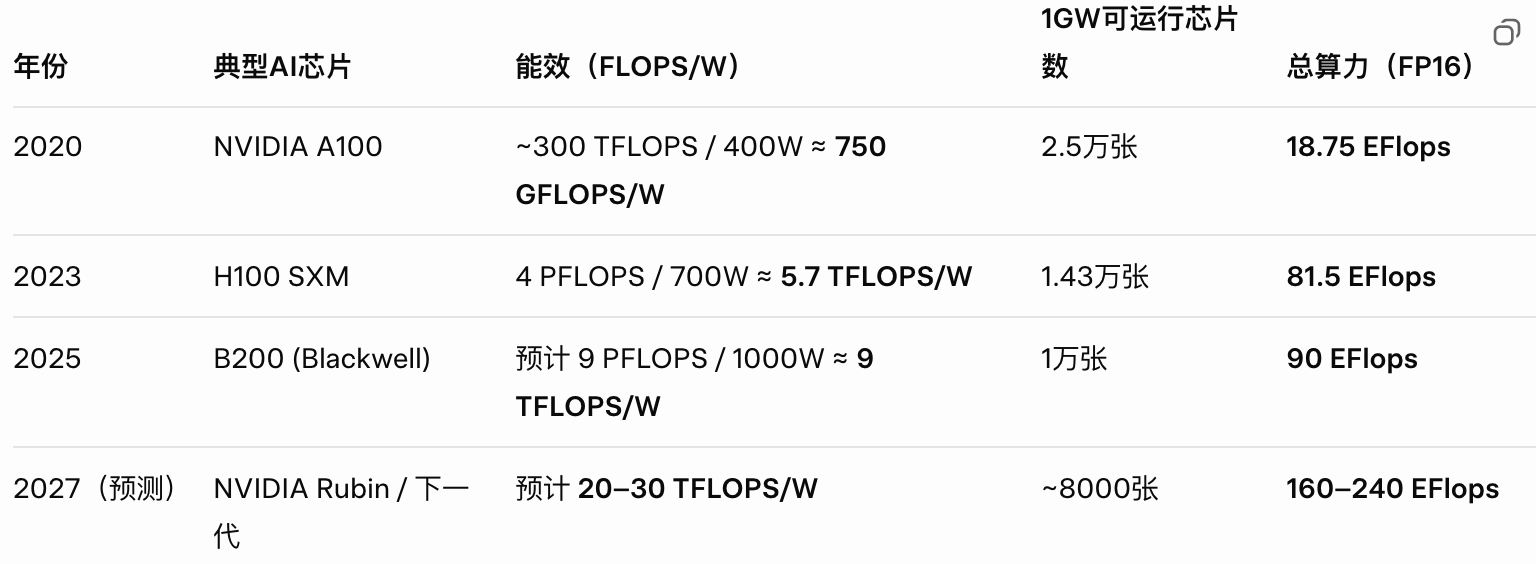
数据来源:NVIDIA GTC keynote、MLPerf、SemiAnalysis、DCD报告
结论:从2020到2027年,1GW电力可提供的AI算力预计增长 8–13倍!
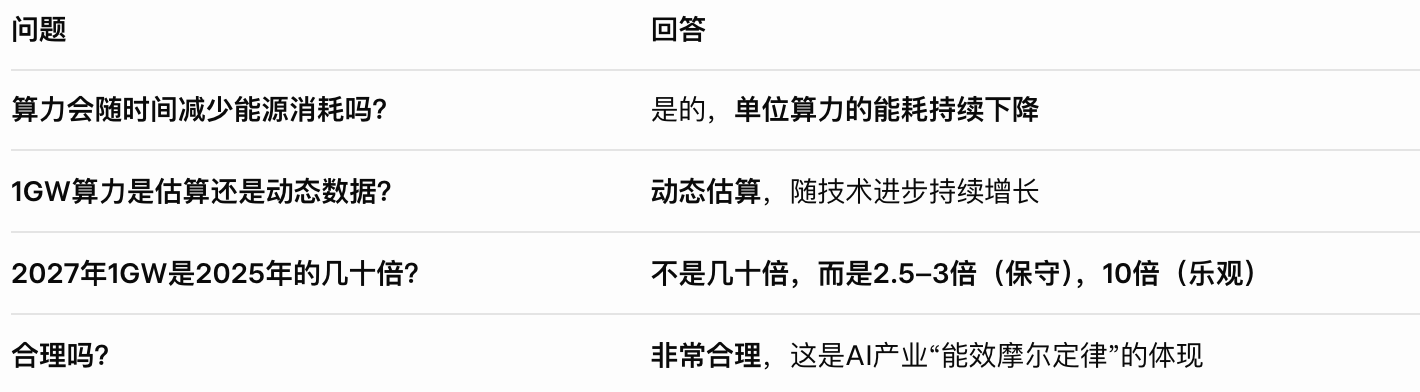
三、2027年 vs 2025年:1GW = “几十倍”?不至于,但接近10倍
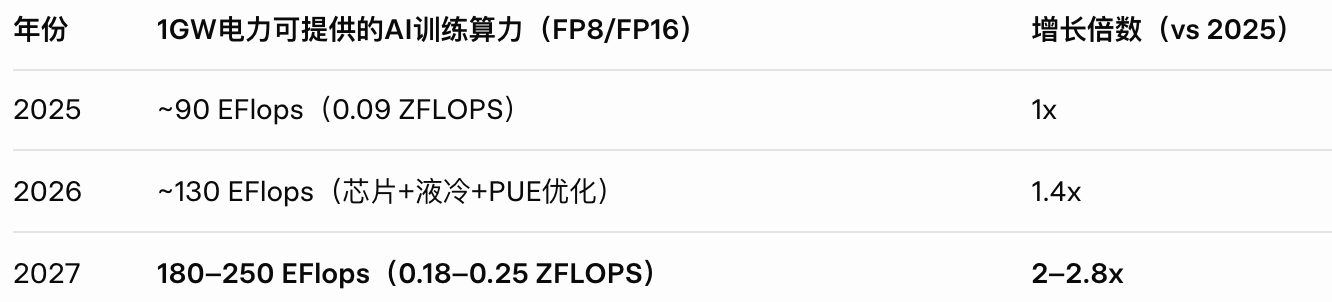
注意:这不是“几十倍”,但每2年翻倍(类似摩尔定律的“AI版”)是行业共识。
为什么不是“几十倍”?
- 物理极限:热力学第二定律、兰道尔原理(Landauer limit)限制最小能耗。
- 制造工艺:3nm → 2nm → 1.4nm,收益递减。
- 实际瓶颈:内存带宽、互连(NVLink)、软件并行效率。
但局部领域可能出现“几十倍”跃升,比如:
- 光子计算(2030+商用)
- 量子辅助训练(实验阶段)
- 专用ASIC(如Cerebras WSE‑3 vs GPU)
四、比喻:1GW像“电费预算”下的算力购买力
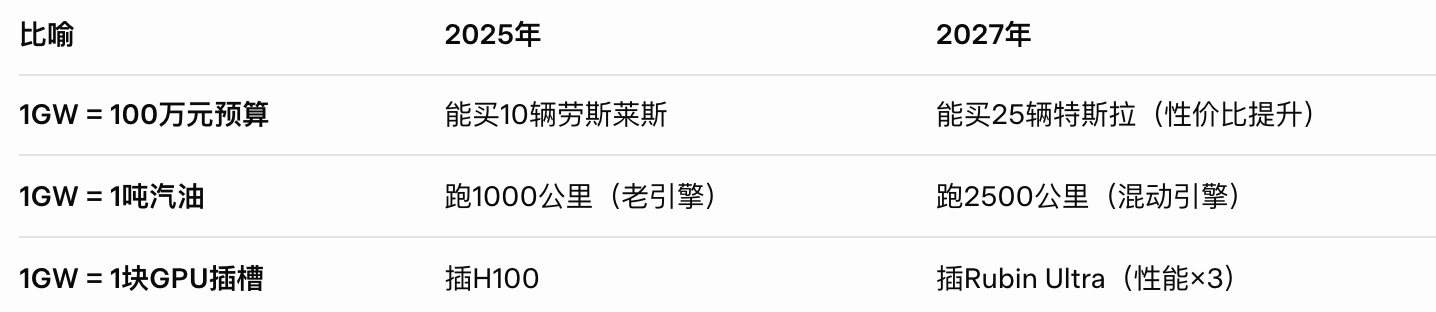
关键点:油箱没变(1GW),但引擎效率提升 → 里程暴增!
五、行业共识:未来算力增长路径
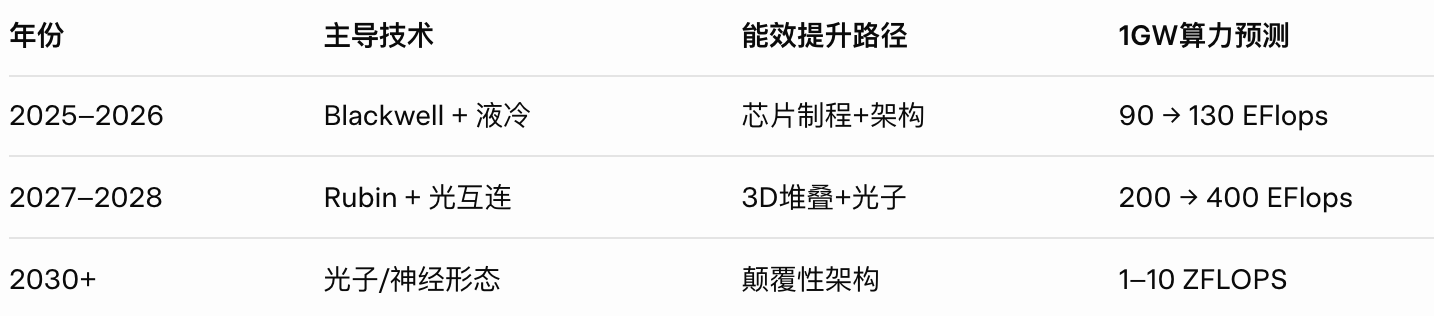
SemiAnalysis预测:到2030年,1GW将支撑1 ZFLOPS(10⁶ EFLOPS),即2025年的10–15倍。
六、总结:你的问题精准命中核心(问题:1GW算力是动态的吗?)
附加:如何计算“1GW能训练什么模型”?
python
# 简化公式(2025年基准)
算力(EFlops)= 电力(GW) × 芯片数 × 单卡性能 × 利用率 × 时间(小时)
# 举例:训练GPT-5级模型(~10万亿参数)
所需算力 ≈ 10 ZFLOPS·小时
2025年1GW集群:90 EFlops → 需 111小时(~5天)
2027年1GW集群:240 EFlops → 需 42小时(<2天)
最终结论:
1GW不是静态数字,而是一个“电力预算下的算力潜力”。在目前的GPU计算能力下,1GW的算力大约相当于90 EFlops,训练GPT5级别的模型大约需要111小时。
到2027年,1GW能做的事,大约是2025年的 2.5–3倍,长期看可能达到 10倍。
这正是AI大厂疯狂建GW级数据中心的底层逻辑:今天抢电力,明天赢算力。
附录:
EB级 是指 艾字节(Exabyte) 级的数据量。
1 EB = 10¹⁸ 字节
具体换算如下:
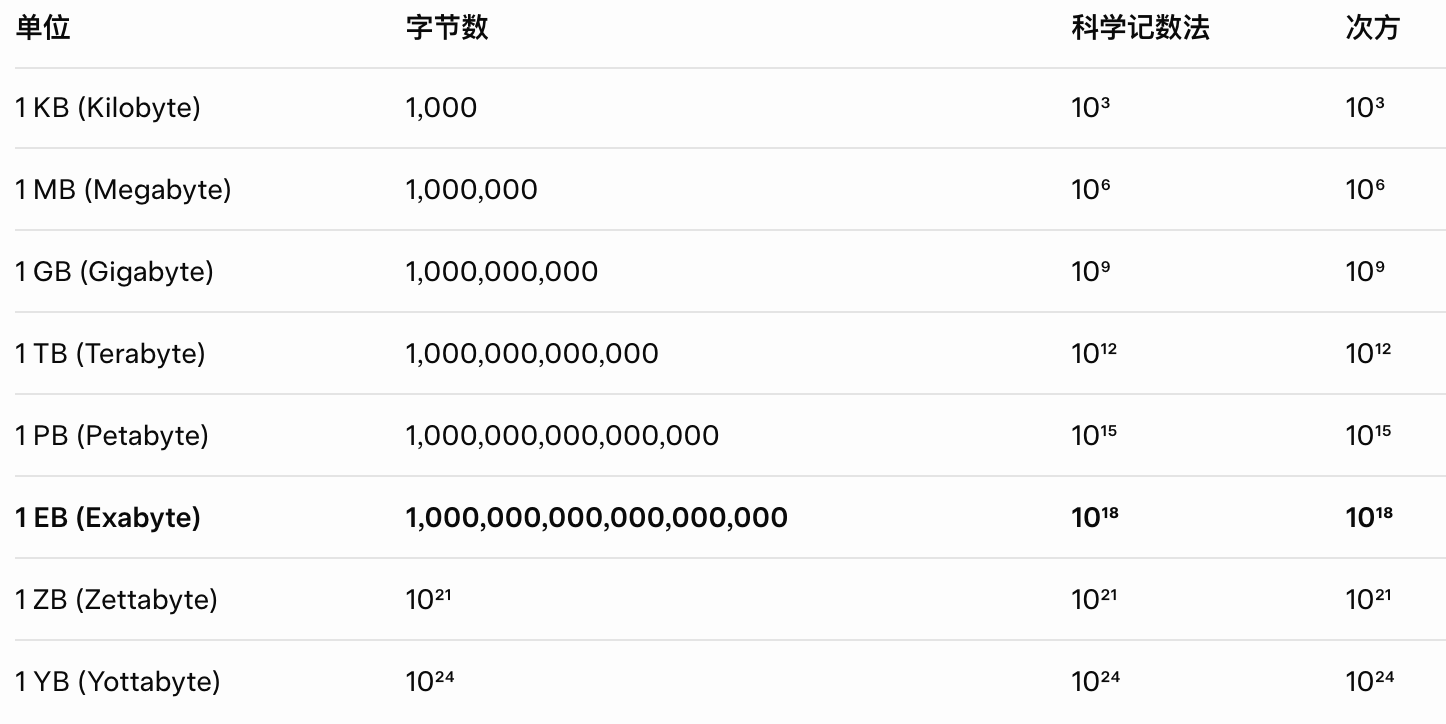
生活化对比(1 EB ≈):
- 10亿部高清电影(每部1.5GB)
- 所有人类说过的话的文本数据 × 5000倍
- 全球每天YouTube上传视频量 × 数百年
- 约等于 2025 年全球数据中心一年新增数据的 1/1000
在AI中的意义:
- 训练 GPT‑5 等超大模型时,训练数据集常达数 EB 级(如 Common Crawl 精炼版 + 合成数据)。
- 1 EB 数据 ≈ 10¹⁸ 个 token(一个英文单词 ≈ 4 字节 ≈ 1 token)
- 当前最强模型训练已用 10–50 EB 有效数据(含重复加权)
总结:EB级 = 10¹⁸ 字节
即:1 EB = 1,000,000,000,000,000,000 B = 10¹⁸ B
相关文章: