
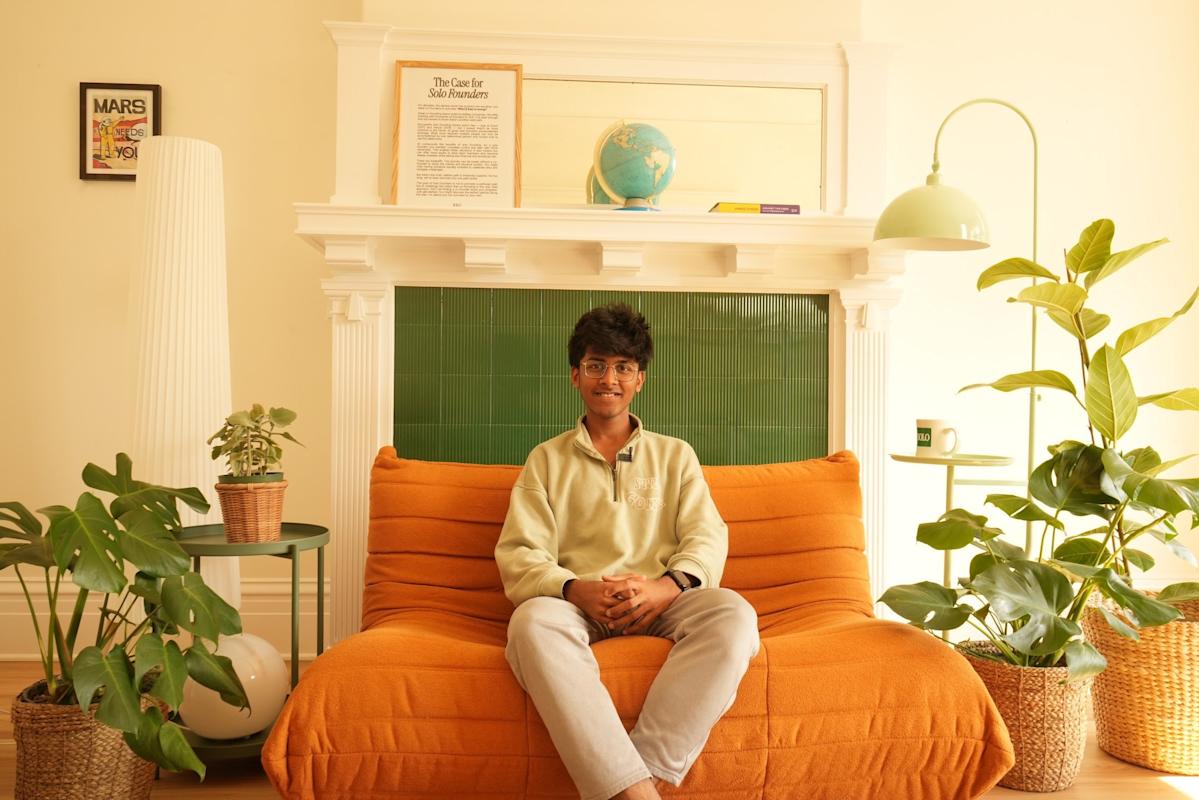
2025年10月7日,Yahoo Finance报道,一位年仅19岁的印度裔开发者Dhravya Shah在硅谷技术圈引起关注。他创办的初创公司Supermemory主打“为AI补记忆层”的技术,声称能让现有的大语言模型(LLM)在处理长期用户信息与连续对话时表现得更加连贯与个性化。
Supermemory的核心思路并非替代模型,而是在模型与应用之间插入一层专门管理记忆的数据层。该层通过向量化表征、元数据标注与时序索引,记录重要事件、偏好、任务上下文和知识片段,并在每次模型调用时按优先级检索相关记忆以拼接进提示(prompt)。据报道,系统支持按主题、时间和信任度对记忆分级,能够在用户长期使用过程中自动升级或遗忘条目。 Yahoo Finance还披露,Supermemory已获得多位谷歌高管的支持,其中包括谷歌AI部门的高级人士作为顾问或天使支持者。报道指出,这类高层级别的背书为团队打开了工程资源和行业渠道,有助于Supermemory更快完成与现有云基础设施及主流模型的兼容工作。
技术细节上,Supermemory被描述为结合了向量数据库、快速检索器和规则化的记忆管理模块。工程实现侧重于低延迟检索与提示规模控制,既要在有限token预算内提供相关上下文,又要避免过度暴露敏感信息。对话场景、客户服务记录与个人知识库是其首批目标场景;在这些场景中,记忆层能显著减少重复询问、提升问题解决速度,并为用户提供更连贯的多轮交互体验。
Dhravya Shah出生于孟买,创立Supermemory的动机部分源自他对当下大模型“短时记忆”和“会话漂移”问题的不满。报道提到,他强调产品应对接开发者友好的API,允许应用在不替换底层模型的前提下,直接利用记忆层提升个性化能力。为此,团队正对接主流模型提供商与向量存储服务,试图把记忆的索引、检索和权限控制做成可复用模块。
投资与商业化进程上,报道未披露具体融资轮次与金额,但多位来自谷歌的高管参与到早期支持中,表明行业对“记忆”构件作为AI基础设施一环具有浓厚兴趣。Supermemory计划在接下来的版本中增强隐私保护机制、提升跨设备同步能力,并推出更多行业适配器,目标客户包括SaaS公司、知识型企业和希望为用户构建长期个人化体验的开发者团队。
这则报道将注意力再次拉向“模型之外”的AI基础设施:当算力与模型能力迅速提升时,如何管理长期记忆、保证上下文连续性与用户隐私,正成为产品化落地的关键。Supermemory以记忆层切入这个问题,能否在激烈的技术供应链中找到明确定位,还需在更多真实业务场景中接受检验。