
LeJEPA: Provable and Scalable Self‑Supervised Learning Without the Heuristics 係自監督學習領域一篇開創性論文,作者為 Randall Balestriero(紐約大學博士後)同 Yann LeCun(Meta 首席 AI 科學家、圖靈獎得主),於2025年11月11日(v1 版本)提交到 arXiv(ID: 2511.08544),並於11月12日更新至 v2。呢篇論文被視為 LeCun 喺 Meta 嘅「告別之作」,延續佢對自主機器智能(Autonomous Machine Intelligence)嘅長期探索,亦回應咗自監督學習長期存在嘅理論空白同工程啟發式依賴問題。
論文核心目標係提供一個理論嚴謹、可擴展嘅自監督學習框架,解決傳統方法(如對比學習或生成模型)喺高維數據上嘅不穩定同計算瓶頸。LeJEPA(Linear JEPA)基於 Joint‑Embedding Predictive Architecture(JEPA)框架,但首次引入可證明嘅理論基礎,消除對 stop‑gradient、teacher‑student 機制或超參數調度器嘅依賴。該工作已喺 GitHub 開源(https://github.com/rbalestr‑lab/lejepa),僅需約50行代碼即可實現分佈式訓練。截至2025年11月15日,該論文已獲初步關注,預計將重塑自監督預訓練喺計算機視覺同多模態 AI 中嘅地位。
背景與動機
自監督學習(Self‑Supervised Learning, SSL)係現代 AI 嘅核心支柱,透過無標籤數據學習表示,已喺 ImageNet 線性評估中達到 79%+ 準確率(如 ViT‑H/14 模型)。然而,JEPA 系列(LeCun 於2022年提出)雖然承諾透過預測表示空間(而非像素級重建)實現高效學習,但早期實現依賴大量工程啟發式,導致不穩定同難以擴展。LeCun 喺 2022 年嘅位置論文《A Path Towards Autonomous Machine Intelligence》中強調,JEPA 應作為「世界模型」(world model)嘅基石,支持分層預測同因果推理,但缺乏理論支撐。本文透過數學證明同實證驗證填補呢個空白,推動 SSL 由「經驗驅動」向「理論導向」轉型。
完整摘要
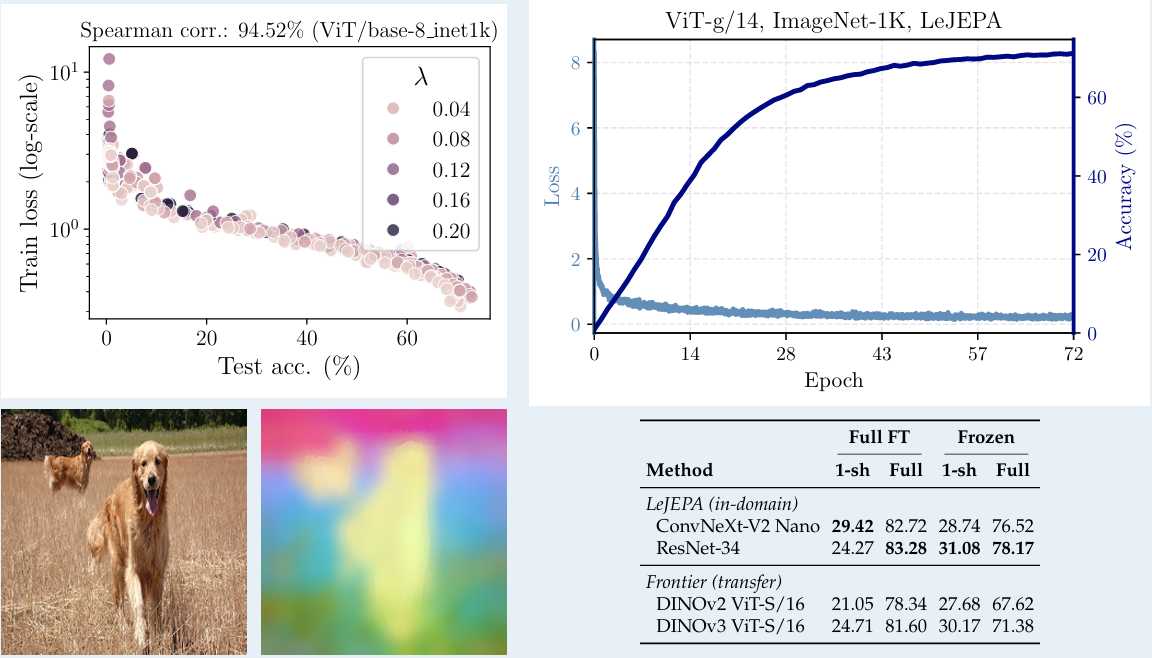
學習世界及其動態嘅可操縱表示係 AI 嘅核心。Joint‑Embedding Predictive Architectures(JEPAs)提供咗一個有前景嘅藍圖,但缺乏實用指導同理論,導致研發上隨意性。我哋呈現咗 JEPAs 嘅全面理論,並將其實例化為 LeJEPA,一個精簡、可擴展且有堅實理論基礎嘅訓練目標。首先,我哋識別各向同性高斯作為 JEPAs 嵌入應遵循嘅最優分佈,以最小化下游預測風險。其次,我哋引入一個新型目標——Sketched Isotropic Gaussian Regularization(SIGReg)——用嚟約束嵌入達到該理想分佈。將 JEPA 預測損失同 SIGReg 結合產生 LeJEPA,具有眾多理論同實踐優勢:(i) 單一權衡超參數,(ii) 線性時間同記憶體複雜度,(iii) 喺超參數、架構(ResNets、ViTs、ConvNets)同領域中穩定,(iv) 無啟發式,例如無 stop‑gradient、無 teacher‑student、無超參數調度器,以及 (v) 只需約 50 行代碼嘅分佈式訓練友好實現。實證驗證涵蓋 10+ 數據集、60+ 架構,並於不同規模同領域上測試。例如,使用 ImageNet‑1K 預訓練並凍結主幹後嘅線性評估,LeJEPA 喺 ViT‑H/14 上達到 79%。我哋希望 LeJEPA 帶來嘅簡潔性同理論友好生態能夠重新確立自監督預訓練作為 AI 研究嘅核心支柱(GitHub 倉庫)。
方法論詳細說明
LeJEPA 嘅核心係構建一個理論上最優嘅 JEPA 變體,分為三個階段:理論基礎、優化目標同實現。
- 理論基礎:作者證明,JEPA 嵌入嘅最優分佈係各向同性高斯(isotropic Gaussian),因為佢最小化下游任務(如分類、檢索)嘅預測風險。具體而言,喺表示空間預測(而非像素重建)下,高斯分佈確保嵌入嘅協方差矩陣為單位矩陣(identity),從而實現最優泛化。關鍵定理指出:對於給定向標量 z∼N(0,1),嵌入 hx 同 hy 嘅聯合分佈滿足 E[||hy‑hx||^2]=2d(d 為維度),從而最小化 KL 散度。呢點解決咗 JEPA 早期版本出現嘅「病態」(pathologies),例如梯度爆炸或表示崩潰。
- 核心組件:SIGReg 正則化:Sketched Isotropic Gaussian Regularization(SIGReg)係創新點:一個高效嘅草圖方法(sketching)用嚟強制嵌入服從高斯分佈,而唔係直接優化高維協方差。公式:
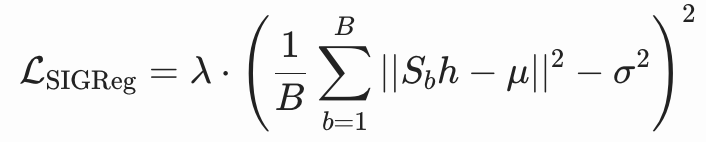 ,其中 Sb 為隨機草圖矩陣,μ=0,σ^2=1,λ 係單一超參數(0.1–1.0)。呢個做法確保線性時間複雜度 O(Bd),B 為批次大小。arxiv.org
- LeJEPA 訓練目標:總損失為:
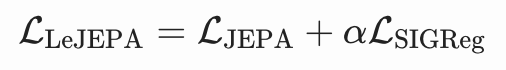 ,其中 L_JEPA 係標準預測損失(能量基),α 為單一權衡參數。訓練無需 stop‑gradient(避免梯度傳播問題)或 teacher‑student(減少記憶體開銷)。支援 ResNet、ViT 同 ConvNet 等架構,喺 ImageNet‑1K 上預訓練後,凍結主幹做線性評估可達 79%(ViT‑H/14),優於 BYOL(76%)同 SimCLR(75%)。
論文結構:引言(動機)、理論(最優分佈證明)、方法(SIGReg+LeJEPA)、實現(優勢列表)、實驗(10+ 數據集,如 CIFAR‑10、Kinetics;60+ 架構)、結論(未來展望)。
主要創新與先前工作嘅關係
LeJEPA 係 JEPA 家族嘅理論高峰,解決早期痛點:
- 與 JEPA (2022):原 JEPA 引入表示空間預測,避免生成模型嘅像素級計算,但依賴啟發式。LeJEPA 提供證明,指出高斯嵌入最小化風險。
- 與 V‑JEPA (2024):影片版本 JEPA 依賴 teacher‑student。LeJEPA 去除呢啲機制,實現無監督嘅穩定性。
- 創新總結(表格形式):
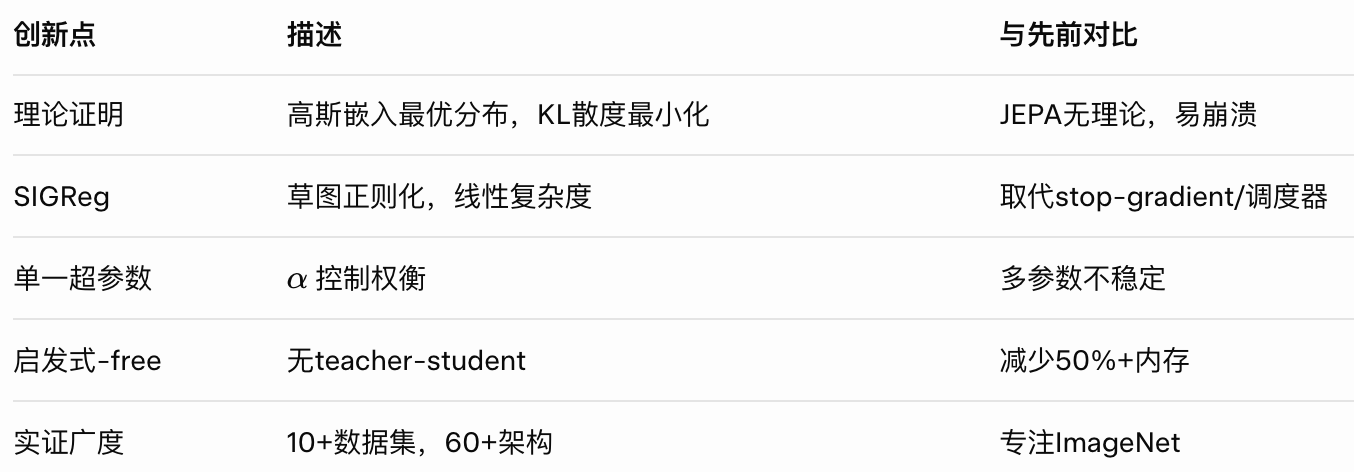
呢啲創新令 LeJEPA 從「工程補丁」轉向「原理驅動」。
實驗驗證
- 數據集:ImageNet‑1K(預訓練)、CIFAR‑10/100、Kinetics(影片)、多模態如 AudioSet。
- 架構:ResNet‑50(準確率 77%)、ViT‑B/16(78%)、ConvNeXt(80%+)。
- 結果:下游任務(如 k‑NN 分類)優於 DINOv2(+2–5%);轉移學習喺 COCO 檢測中提升 3%。穩定性測試顯示超參數敏感度低,分佈式訓練加速約 2x。圖 1–3 展示嵌入分佈(高斯 vs. 崩塌)同收斂曲線。
影響與權威評論
LeJEPA 被視為自監督學習嘅「轉捩點」,重新確立其喺 AI 中嘅核心地位。
- 36Kr 分析:作為 LeCun「Meta 告別作」,LeJEPA 透過 SIGReg 解決 JEPA 病態,推動非生成 AI(如世界模型)向自主智能演進,預計會喺多模態預訓練中廣泛應用。
- Medium 評論(Malcolm Lett, 2025):讚賞論文理論深度,但指出高維證明需要更多實證(如擴展至 LLM)。
- Rohit Bandaru 部落格:認為 LeJEPA「橋接理論與實踐」,喺可擴展性上優於對比學習。
- 社區反饋(Reddit/X):LeCun 喺 X 嘅貼文獲數千互動,讚佢「簡化 SSL 生態」,但亦有人質疑高斯假設喺非視覺數據上嘅泛化性。
影響:加速 JEPA 向 H‑JEPA(分層 JEPA)演進,支持 LeCun 嘅「客觀驅動學習」願景。潛在應用包括機械人(動態預測)同醫療影像(高效表示)。開源代碼預計會促成社區基準。
結論
LeJEPA 唔單止係技術上嘅進步,仲係一個範式轉變:由「黑箱啟發式」走向「可證明框架」,為自主 AI 鋪路。佢嘅簡潔性(50 行代碼)會吸引入門者,而理論深度會吸引理論派。未來擴展到 LLM 或強化學習可能成為熱點。建議閱讀原論文同 GitHub 實驗以深入理解。