
一、乜嘢係 LLM 嘅詞彙表?(Vocabulary)
喺大型語言模型(LLM)如 GPT、LLaMA、Claude 等嘅核心組件入面,詞彙表(Vocabulary,或稱 Token Set)係模型處理自然語言嘅基石。佢係模型喺訓練同推理過程中所有可能 token(令牌)嘅集合,直接決定模型點樣將文本轉做可計算嘅數字序列。
佢定義咗:
➡ 模型可以識別同處理嘅最細語言單位
➡ 每個 token 對應唯一嘅整數 ID
➡ 呢啲 ID 會喺 embedding 表入面查同訓練
喺 NLP 系統入面,呢啲 token 並唔係自然語言入面嘅「單字」,而係子詞級別 (subword) 嘅編碼單位。
例如:
“playing” → “play”, “ing”
📌 將文本映射到呢啲子詞單位,就係 tokenization 嘅過程。
二、詞彙表係點樣構建嘅?
詞彙表唔係人工寫嘅「字典」,而係由大量語料自動學習出嚟:
1) 字符級(Char)
最基本嘅做法,每個字符做一個 token。
優點:覆蓋晒所有語言
缺點:序列太長、效率低。
2) 子詞級(Subword):主流方法
⭐ BPE(Byte Pair Encoding)
- 由字符開始(例如所有 Unicode 字符)
- 喺語料入面統計出現頻率最高嘅子串組合
- 將高頻組合同併為新嘅 token
- 反覆迭代直到達到目標詞表大小
- 最終會得到「最常用子詞」集合
- 用喺 GPT 系列同好多 autoregressive 模型。
SentencePiece(Unigram / BPE)
- 類似 BPE,但用概率模型或者 unigram 方法揀 token
- 可以更加自然咁覆蓋多語言
- 被好多開源模型採用(例如 LLaMA、Mistral)。
WordPiece
- 主要用喺 BERT 系列
- 都係基於統計方法構建 subword token
- 同 BPE 嘅合併規則唔同,WordPiece 採用概率搜索最大互信息。
3) 特殊標記
除咗子詞,仲有啲專用 token,例如:
- <PAD> 填充
- <UNK> 未知 token
- <CLS> / <SEP> 結構分隔
- 呢啲都會計入詞彙表大小。
三、而家流行嘅 LLM 詞彙表大小係幾多?
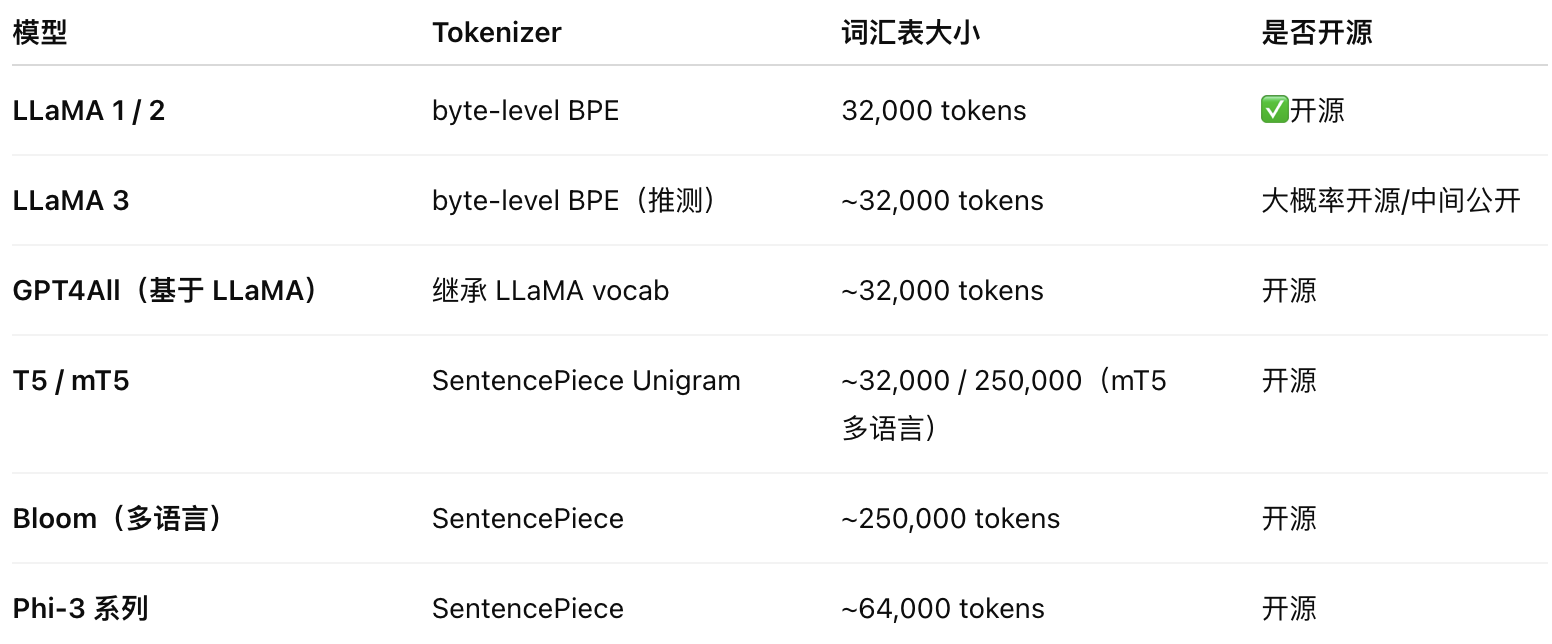
唔同模型同 tokenizer 策略嘅詞彙表大小有好大差異,與目標語言、多語言覆蓋、token 化策略有關。
以下係較可靠嘅數值範圍同已知資訊:
主流開源模型詞彙表大小(公開)
商業閉源詞彙表(通常未公開具體數據)
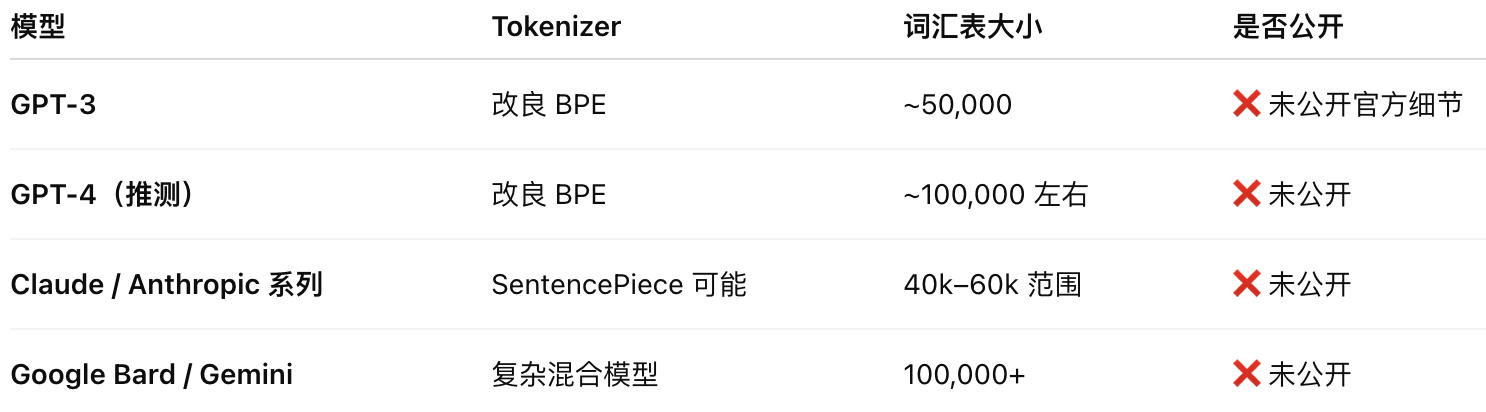
⚠ 呢啲閉源模型通常唔會直接公布詞彙表內容或 tokenizer 細節。工程上只可以透過推斷或者社群反推規模。
四、點解唔同模型嘅詞彙表大小會唔同?
詞彙表大小會影響:
📌 輸入序列長度(vocab 細 → 序列更長)
📌 模型參數量(vocab 大 → embedding 參數更多)
📌 多語言覆蓋能力(vocab 大可以包攬更多文字)
所以唔同目標會有唔同嘅權衡:
- 單語言模型(例如英語) 詞表可以細啲就夠
- 多語言模型 需要更大詞表
- 代碼/符號豐富嘅任務 都需要大詞表
呢個亦都係點解 LLaMA 3 將 vocab 擴展到 ~128k 嘅原因——可以更好覆蓋中文、特殊符號等。Rohan's Bytes
五、邊啲詞彙表係已公開同開源?
✅ 開源詞彙表常見來源:
📌 HuggingFace 模型庫
幾乎所有開源模型嘅 tokenizer 同 vocab 都可以直接下載使用。
👉 例如:
- LLaMA 詞彙表
- Bloom 詞彙表
- T5 / mT5 詞彙表
- Phi 系列詞彙表
呢啲通常以 vocab.json、merges.txt 或 spm.model 等檔案形式提供,可直接用 tokenizer 工具載入。Rahat Ibn Rafiq
六、詞彙表有啲乜嘢常見檔案格式?
格式說明:vocab.json + merges.txt — BPE(例如 GPT‑2 系列);spm.model / spm.vocab — SentencePiece 模型;純 txt 列表 — 單詞級或舊式詞表;自定義 bin/jar — 專有格式。
呢啲檔案可以喺模型發佈包入面搵到,或者喺 HuggingFace/Model Zoo 下載。Rahat Ibn Rafiq
七、點樣自己訓練一個詞彙表?
如果你想做自己嘅 LLM 或者客製化領域詞彙(例如法律/醫療):
1️⃣ 收集大規模語料
2️⃣ 使用工具訓練 tokenizer
SentencePiece(支持 Unigram/BPE)tokenizers庫(Rust/C/Python)- 3️⃣ 指定詞彙表大小(例如 32k、64k 等)
- 4️⃣ 生成 vocab 檔案
- 5️⃣ 用佢訓練模型或做 fine‑tune
呢種客製化做法喺行業應用好常見,可以顯著提升專業詞彙識別嘅效率。
八、總結
📌 詞彙表係模型理解語言嘅「基本字典」
📌 通過 BPE / SentencePiece 等算法由大語料自動學習出嚟
📌 流行開源詞彙表一般喺 32k ~ 250k 之間
📌 GPT‑3、GPT‑4、Claude 等閉源模型詞彙表未公開
📌 HuggingFace 同開源社群係獲取詞彙表最豐富嘅地方
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎訂閱我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請到: https://www.airosetta.com