
2026年4月29日,騰訊混元團隊正式開源Hy‑MT1.5‑1.8B‑1.25bit翻譯模型。該模型將支持33種語言(含5種民族語言/方言)的翻譯能力壓縮至僅440MB,可喺手機等消費級設備上實現完全離線即時翻譯,且翻譯質量喺多項基準測試中超越谷歌翻譯等主流商用 API。呢項開源成果迅速引起業界關注,被視為 AI 大模型「輕量化+本地化」嘅一次重要突破,為私隱保護、離線場景同低資源設備下嘅 AI 翻譯提供實用方案。
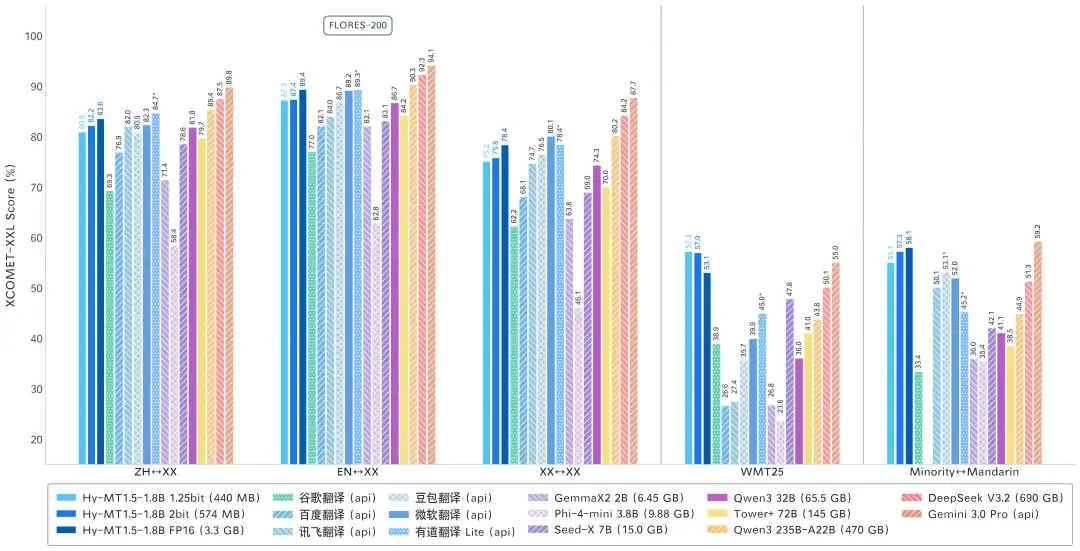
Hy‑MT1.5:細模型做到「大能力」
Hy‑MT1.5 系列包括1.8B 輕量版同7B 完整版。其中,1.8B 參數嘅量化壓縮版本僅 440MB,經過極致量化後,喺驍龍865+8GB 記憶體等中低端設備上即可流暢運行,實現即時離線翻譯。騰訊混元團隊表示,該模型喺嚴格評測基準中,翻譯質量唔單止超越谷歌翻譯、微軟翻譯等商用 API,仲達到或接近 235B 級超大模型嘅效果,喺 WMT 等國際機器翻譯競賽中表現出色。
技術亮點包括:
- 多語言覆蓋:支援33種國際語言互譯,涵蓋中英、法德、日韓等主流語種,仲包括5種中文方言/民族語言,翻譯方向達1056種。
- 高級功能:支援術語干預、上下文翻譯、格式保留等專業能力,適用於文件、即時對話等多種場景。
- 本地部署:完全離線運行,唔會上傳任何數據,顯著提升私隱安全性。
- 高效量化:通過 1.25bit 等極致壓縮技術,喺保持高性能嘅同時大幅降低模型體積同記憶體佔用。
同傳統雲端翻譯服務相比,Hy‑MT1.5 最大嘅優勢係無需網絡。喺訊號差嘅偏遠地區、國際旅行、出國留學或網絡受限環境,使用者仍然可以獲得高質量翻譯支援。呢點對跨境交流、緊急救援同個人學習場景好有實際價值。
對 AI 翻譯產業同用家嘅深遠影響
1. 私隱保護與數據安全升級
傳統在線翻譯服務需要將用戶文本上傳到伺服器,存在數據洩露風險。Hy‑MT1.5 完全本地運行,從根本上解決咗呢個痛點。特別係涉及敏感資訊、商業機密或個人私隱嘅場景,本地化翻譯會成為首選。呢個做法亦符合全球日益嚴格嘅數據私隱監管趨勢(如 GDPR、內地《個人信息保護法》),為企業級應用提供合規方案。
2. 離線場景賦能與普惠價值
440MB 嘅體積令高端翻譯能力下沉到普通智能手機,甚至中低端設備。呢點大大擴展咗 AI 翻譯嘅應用邊界:喺發展中國家、網絡基礎設施薄弱嘅地區,或者航空、偏遠旅遊等場景,用戶無需依賴昂貴數據或穩定網絡就可以使用高質量翻譯。騰訊呢個舉動顯著降低咗 AI 技術嘅門檻,令更多普通用戶受惠,推動 AI 普惠。
3. 挑戰雲端翻譯商業模式
谷歌翻譯、DeepL 等主流服務高度依賴雲端算力。Hy‑MT1.5 等開源本地模型嘅出現,會對呢種模式造成衝擊。用戶可能會轉向免費、離線、本地化嘅替代方案,迫使雲端服務進一步提升差異化競爭力(例如即時多輪對話、專有領域知識)。同時,亦加速咗 AI 模型「邊緣計算」趨勢,促使行業由「雲端中心化」向「雲邊端協同」演進。
4. 開源生態與技術創新加速
騰訊將模型權重、代碼及技術報告全面開源(支援 Android 體驗 Demo,後續會擴展到 iOS 等平台),為開發者、研究者同中小企業提供高性能嘅翻譯基礎模型。呢個會激發更多本地化 AI 應用創新,例如整合到翻譯 App、教育工具、跨境電商同智能硬件入面。開源亦促進全球 AI 社區協作,推動「小模型、大能力」嘅技術路線進一步成熟。
5. 可持續性與成本優化
本地運行大幅降低咗對雲端伺服器嘅依賴,減少能耗同碳排放,符合綠色 AI 發展趨勢。對企業嚟講,部署成本明顯下降,無需持續支付 API 調用費用。呢點對中小企業同開發者尤其友好,有助 AI 翻譯技術喺更多垂直領域滲透。
挑戰與未來展望
儘管性能亮眼,Hy‑MT1.5 仍然面臨挑戰:極致量化喺極複雜嘅長文本或罕見語種上可能會有一定嘅精度損失;手機端嘅即時性需依賴硬件優化;未來多模態(語音、圖像)翻譯整合仍係重點方向。
騰訊混元今次開源,不單止展示咗國產 AI 喺翻譯領域嘅實力,亦為全球 AI 輕量化提供咗中國方案。將來,隨住更多類似開源模型湧現,AI 翻譯會變得更智能、便捷同普惠。Hy‑MT1.5 嘅落地,或者只係 AI「由細模型走向大規模應用」嘅開始。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請訪問:https://www.airosetta.com