
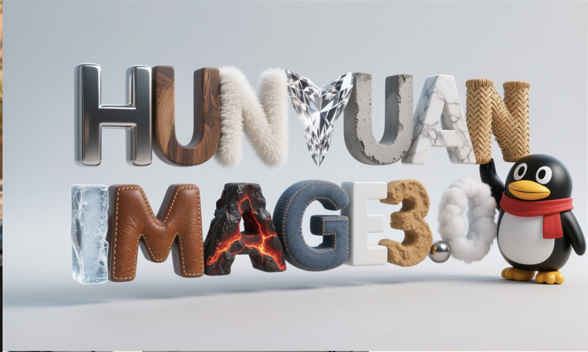
2025年9月,位於中國深圳嘅騰訊混元基礎模型團隊喺arXiv發佈咗論文(arXiv:2509.23951v1),正式推出HunyuanImage 3.0模型。呢款全球最大、最強嘅開源圖像生成AI,標誌住中國AI喺多模態領域嘅重大突破。HunyuanImage 3.0係一個原生多模態模型,既可以「睇得懂」圖片做理解同分析,又可以生成高質量圖像,支持由照片級到藝術風格嘅多樣創作。根據騰訊新聞報道,該模型基於超過800億參數嘅語言模型,激活130億參數,具備「思維鏈」推理能力,徹底革新圖像生成同理解嘅統一框架。Wired強調,呢個開源模型嘅發布推動咗AI圖像技術嘅民主化,令開發者可以免費接觸到頂尖性能,預計會加速創意產業嘅應用。
騰訊混元團隊自2023年起專注大型模型研發,此前HunyuanImage 2.1已展示強勁生成能力,但3.0版本喺多模態融合上實現質嘅飛躍。Hugging Face倉庫數據顯示,模型下載量快速突破50萬次。X用戶@TencentHunyuan 喺官方帖文寫道:「HunyuanImage 3.0:一個模型,識圖又生圖,開源賦能全球創意。」帖文獲得數千個讚,社區反饋認為其「全能型」設計係亮點。呢次發布唔單止鞏固騰訊喺開源AI嘅領導地位,亦為教育、設計同科研注入新動力。
數據準備:高質量數據集嘅構建
HunyuanImage 3.0嘅成功來自嚴謹嘅數據準備。由100億張原始圖片開始,團隊分三階段篩選:首先係技術過濾,剔除低分辨率、損壞或重複圖片;其次係客觀+主觀過濾,移除水印、AI生成嘅假圖片,利用美學評價模型評估色彩、光影同構圖;最後係去重,通過特徵向量聚類移除0.5%相似內容。最終保留近50億張高質量圖片(不到原始45%)。另外補充專業數據集,包括從影片中挖掘嘅片段:透過鏡頭檢測、運動分類、目標檢測同模糊檢測,從視頻中提取高價值幀。
呢個過程確保數據多樣性同質量。騰訊新聞指出,團隊構建咗1億對圖片數據集,通過圖片聚類生成成對描述,模擬編輯指令,支持圖像到圖像嘅理解同生成。與Llama 3.1嘅開源數據集相比,Hunyuan嘅篩選更著重美學同語義完整性,避免低質數據引入噪聲。
圖片描述生成與推理數據集構建
模型嘅關鍵係分層雙語描述架構,生成四個等級嘅描述:由簡短語義到超長細節,涵蓋語義欄位、風格屬性同事實實體。組合式數據增強透過採樣欄位生成30–1000詞描述,確保多樣性。集成OCR代理提取文字,同命名實體代理識別實體,雙向驗證確保準確性。對於成對圖片,使用差異描述生成器模擬編輯指令,提升模型理解深度。
推理數據集構建模擬人類思維鏈:由提示理解到細化思考,再到圖像生成。覆蓋照片級、藝術、UI設計同知識查詢場景,使用美學指標篩選圖像,標註推理軌跡。呢種設計令模型具備「思考」能力,避免傳統生成模型嘅隨機性。Hugging Face社區反饋顯示,呢種方法喺處理複雜提示方面優於Seedream 4.0。
模型設計與關鍵技術
HunyuanImage 3.0基於Hunyuan‑A13B(800億參數,64個專家模塊,每次激活8個+共享MLP,實際激活130億參數)。文本處理使用擴展詞彙表,圖像編碼採用雙編碼器:VAE(32維潛在空間,16倍下採樣)同視覺編碼器連接特徵。投影器包括VAE特徵嘅時間步調制殘差塊,以及視覺特徵嘅兩層MLP,支持交錯多模態交互。
廣義因果注意力機制係一個創新點,融合因果(文本自回歸)同全注意力(圖像全局)。圖像標記可以關注同一片段後續標記,訓練時引入「空洞」掩碼;推理時始終採用標準因位置編碼,使用廣義2D旋轉位置編碼(x,y坐標三角函數),文本保留1D兼容,確保一致性。自動分辨率調整嘅擴展詞彙表加入尺寸錨點同寬高比標記(1:4到4:1),模型會根據上下文預測尺寸,亦支持用戶指定(例如「3:4」)。呢項技術令模型可以靈活處理唔同分辨率輸入,屬於創新性領先。
訓練與後訓練優化
預訓練分四個階段:1. Transformer主幹+低分辨率(文本‑圖像生成、語言建模、多模態理解);2. 微調視覺編碼器;3. 聯合訓練+更高分辨率+交錯數據;4. 高分辨率子集(短邊≥1024像素)+推理數據。後續指令微調使用模板格式化數據,確保提示合規。
後訓練優化包括監督微調(高質量圖像類別)、直接偏好優化(標註好/壞樣本對,抑制變形)、MixGRPO(強化學習,優化美學、減少偽影)、SRPO(梯度引導,注入噪聲以優化真實感)同ReDA(獎勵分佈對齊,模仿高質量圖像分佈)。呢啲技術顯著提升模型嘅生成質量同穩定性。與Llama 3.1相比,Hunyuan喺優化上更注重多模態一致性。
性能評估與專家激活分析
喺SSAE指標上(500提示、3500要點,12欄位分類,使用多模態LLM評分0‑1匹配),HunyuanImage 3.0喺所有欄位都達到領先水平。GSB評估(1000提示,100+評估員):相對勝率 vs. HunyuanImage 2.1 為14.10%;vs. Seedream 4.0 為1.17%、Nano Banana 為2.64%、GPT‑Image 為5.00%。
專家激活分析顯示,1000提示熱力圖表明專家分工專業化(圖像/文本KL散度隨層數增加),自發分工加強咗多模態能力。呢啲結果證明模型喺圖像理解同生成方面具備SOTA地位。
社區反應與行業影響
HunyuanImage 3.0發布之後,社區反應熱烈。Hugging Face下載量超過50萬,開發者稱其「全能型」設計具革命性。X用戶@TencentHunyuan 分享:「開源圖像AI新標杆。」Bloomberg報道,Hunyuan挑戰美國大廠嘅壟斷,推動開源生態。
影響深遠。Info‑Tech評估認為,Hunyuan降低咗多模態入門門檻,支持創意、教育同科研。與o1相比,其開源性加速社區微調,但地緣政治風險存在,美國嘅管制可能影響國際合作。騰訊計劃推出後續版本,擴展圖像到圖像功能。
結論:HunyuanImage 3.0嘅開源之光
騰訊混元團隊嘅HunyuanImage 3.0以800億參數嘅多模態創新,重塑開源圖像AI格局。由數據篩選到後訓練優化,呢個模型唔單止領先基準測試,仲為全球開發者提供免費工具,推動AI普惠。未來Hunyuan有望激發更多應用,但亦需面對倫理同管制方面嘅挑戰。