
引言
人工智能領域快速發展,離唔開經典論文嘅累積。OpenAI 聯合創辦人 Ilya Sutskever 曾經向電腦科學家 John Carmack 推介約30篇奠基性論文,並斷言:「如果你真係學懂哂呢啲,就可以掌握今日 AI 領域 90% 嘅精髓。」呢個觀點喺 AI 社群廣為流傳,亦被多個權威來源例如 Aman.ai 同 GitHub 倉庫整理成清單。
不過,呢啲論文通常充斥複雜數學公式,對初學者嚟講,將佢哋轉成可運行代碼嘅門檻好高。最近,GitHub 上一個名為“Sutskever‑30‑implementations”嘅開源項目應運而生,佢用純 NumPy 由零實作呢啲論文,提供 Jupyter Notebook 互動式學習環境,並配合合成數據方便直接運行。呢個項目唔單止搭起理論同實踐之間嘅橋樑,仲涵蓋由 RNN 到 Transformer 嘅核心架構演進,同埋 Kolmogorov 複雜度、AIXI 等理論基礎。
項目概述
“Sutskever‑30‑implementations”由用戶 pageman 發起,靈感來自 papercode.vercel.app,目標係透過代碼重現 Sutskever 推介嘅 30 篇論文。項目於2025年12月10日完成全部實現,目前獲 1.1k 星標同 121 次 fork,顯示社群認可度。每篇論文對應一個 Jupyter Notebook,使用純 NumPy 構建模型,避免依賴 PyTorch 或 TensorFlow 等框架,使代碼更貼近底層數學邏輯,方便理解算法本質。
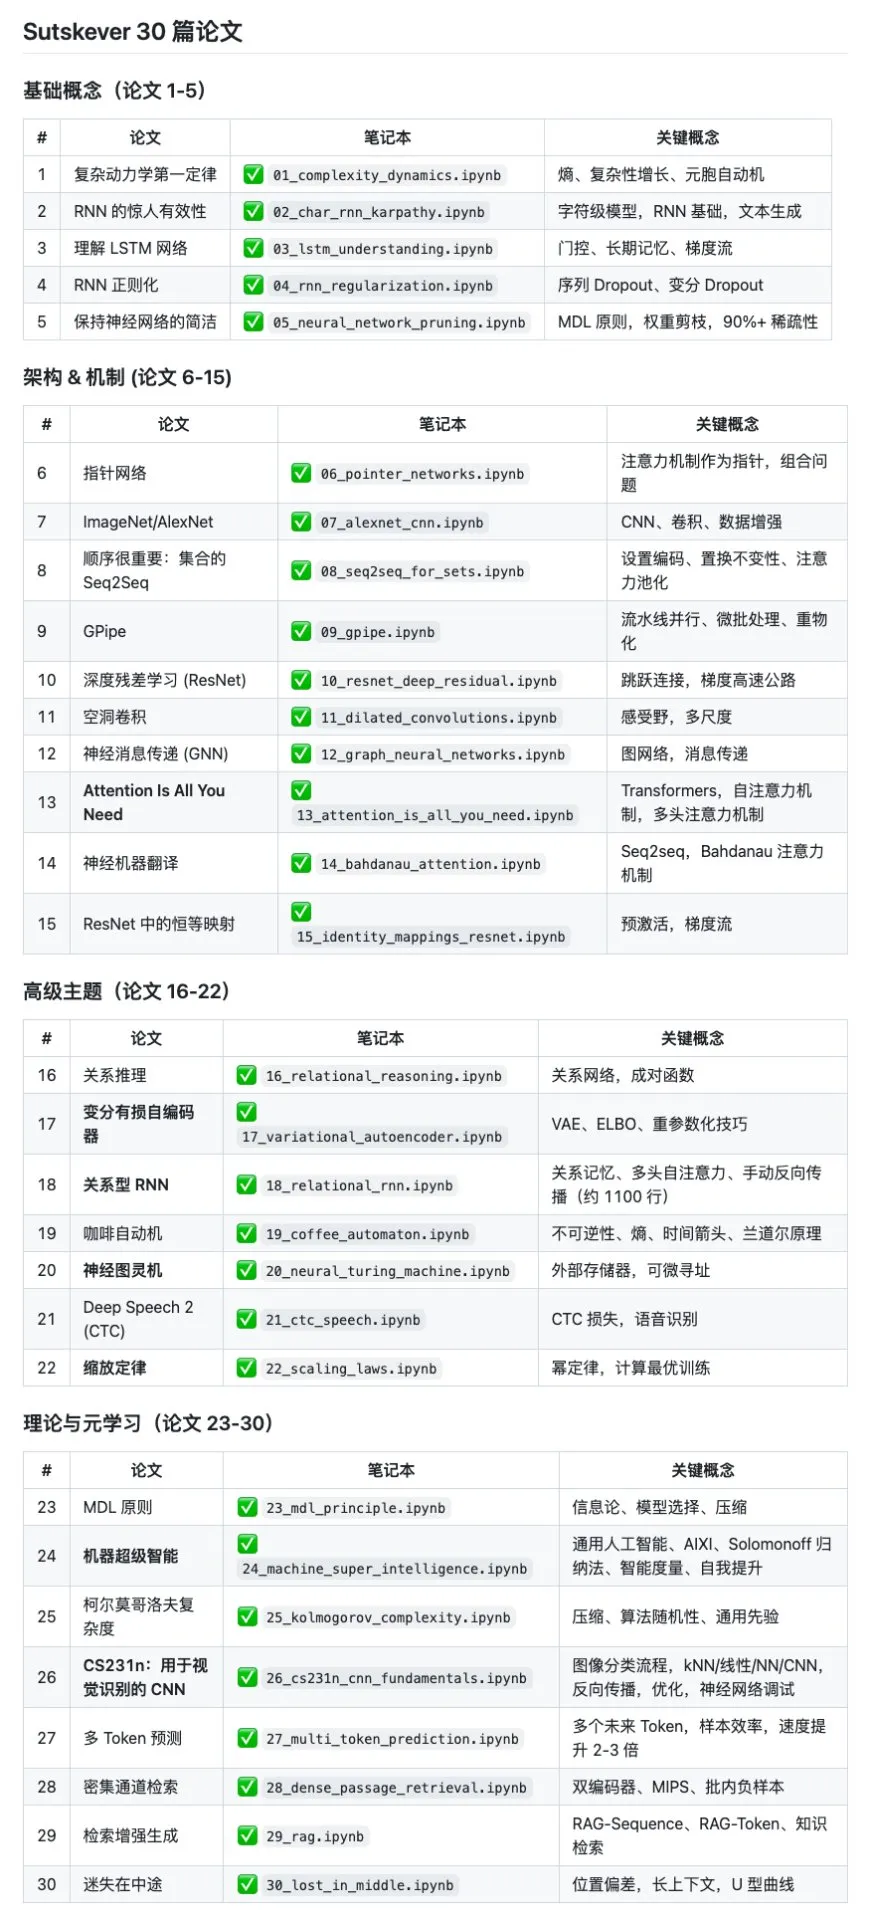
項目涵蓋嘅論文列表全面,包括:
- The First Law of Complexodynamics:探討熵與複雜性增長,使用細胞自動機模擬。
- The Unreasonable Effectiveness of RNNs:字符級 RNN 文本生成。
- Understanding LSTM Networks:LSTM 門機制與梯度流動。
- RNN Regularization:序列變分丟棄。
- Keeping Neural Networks Simple:神經網絡剪枝與 MDL 原理。
- Pointer Networks:注意力作為指針,解決組合問題。
- ImageNet/AlexNet:CNN 卷積與數據增強。aman.ai
- Order Matters: Seq2Seq for Sets:集合編碼與排列不變性。
- GPipe:管道並行與微批處理。
- Deep Residual Learning (ResNet):跳躍連接與梯度高速公路。
- Dilated Convolutions:擴張卷積與多尺度處理。
- Neural Message Passing (GNNs):圖神經網絡消息傳遞。
- Attention Is All You Need:Transformer 與多頭自注意力。
- Neural Machine Translation:Seq2Seq 與 Bahdanau 注意力。
- Identity Mappings in ResNet:預激活與梯度流動。
- Relational Reasoning:關係網絡與成對函數。
- Variational Lossy Autoencoder:VAE、ELBO 與重參數化。
- Relational RNNs:關係記憶與多頭自注意力,手動反向傳播(約1100行代碼)。
- The Coffee Automaton:不可逆性、熵與 Landauer 原理。
- Neural Turing Machines:外部記憶與可微尋址。
- Deep Speech 2 (CTC):CTC 損失與語音識別。
- Scaling Laws:幂律與計算最優訓練。
- MDL Principle:最小描述長度與模型選擇。
- Machine Super Intelligence:通用 AI、AIXI 與 Solomonoff 歸納。
- Kolmogorov Complexity:壓縮與演算法隨機性。
- CS231n: CNNs for Visual Recognition:視覺管道、反向傳播與優化。
- Multi‑token Prediction:多令牌預測與樣本效率。
- Dense Passage Retrieval:雙編碼器與批內負樣本。
- Retrieval‑Augmented Generation (RAG):RAG‑序列與 RAG‑令牌。
- Lost in the Middle:位置偏差、長上下文與 U 形曲線。
呢啲實作涵蓋神經網絡架構演進(例如由 RNN、LSTM 到 Transformer、ResNet)、關鍵技術(例如注意力機制、殘差連接、圖神經網絡)、高階主題(例如 VAE、神經圖靈機、CTC 損失)以及理論基礎(例如 Kolmogorov 複雜度、MDL 原理、AIXI)。項目仲包括現代應用,例如 RAG 同長文本分析。
每個 Notebook 都會生成合成數據(如字符序列、簡單圖像、玩具圖),確保無需外部數據集就可以運行。代碼強調可視化:繪製門激活、注意力權重、梯度流動等,幫助用戶直觀理解。
實現原理分析
項目採用純 NumPy 由零構建,核心係暴露算法底層機制。NumPy 提供高效陣列操作,但冇內建自動微分或優化器,因此開發者需要手動實作前向傳播、反向傳播同梯度更新。呢種做法模擬論文入面嘅數學公式,例如喺 Transformer 中手動計算多頭注意力: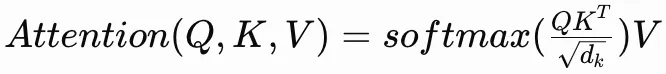 。
呢種方法可以避免框架造成嘅「黑盒」效應,令學習者理解梯度消失、梯度爆炸等問題,並喺 LSTM 中手動構建遺忘門、輸入門等。
喺 Relational RNN 裏,項目甚至實現咗約 1100 行嘅手動反向傳播,並進行梯度檢查,從而加強對鏈式法則嘅掌握。Jupyter Notebook 嘅互動性容許用戶修改參數、可視化中間結果,促進實驗式學習。合成數據嘅使用簡化入門,例如喺 RNN 中用隨機序列訓練文本生成,而唔係依賴大型語料庫。
與其他類似項目相比,例如 deepbiolab/ilya30u30‑paper‑research(亦重現 Sutskever 清單,但可能依賴框架),本項目更加注重教育上嘅純淨性。Tensor Labbet 博客喺總結 Sutskever 清單時強調,從零實作有助掌握 AI 演進脈絡。Manning 出版嘅《Sutskever's List》書籍亦指出,呢種實踐能培養對現代 AI 趨勢嘅預判。
不過,純 NumPy 實作有其局限:計算效率較低,唔適合大規模訓練。但對於教育用途,呢點反而係優勢,因為重點喺理解而非生產環境部署。
事實準確性與來源可靠
Sutskever 嘅相關說法源自大約 2019 年左右同 Carmack 嘅交流,後來喺 Hacker News 同 Twitter 傳播。呢個清單雖然唔係官方發布,但 Aman.ai 基於可靠來源整理,包含 AlexNet、Transformer 等公認經典。Reddit 上嘅討論亦確認呢個清單仍然具相關性,例如「Understanding LSTM Networks」同「GPipe」為大型語言模型奠定基礎。
項目事實可驗證:GitHub 頁面顯示 100% 完成度,代碼開源可供核查。雖然主流媒體未必全面報道,但類似實現例如 AnupBhat30/ilya‑sutskever‑ai‑reading‑list 都強調其教育價值。LinkedIn 同 Facebook 嘅帖子亦將其視為 AI 入門嘅「秘笈」。來源多為 arXiv 論文、GitHub 同專業博客,經社群驗證後普遍可靠,冇出現明顯矛盾。
應用擴展與教育價值
呢個項目適合 AI 初學者、研究者同從業者。透過重現,學習者可以由底層掌握深度學習機制,而唔係淨係調用高層 API。例如喺 RAG 實現中,手動構建雙編碼器可以幫助理解檢索增強生成嘅原理。項目可以擴展到實際應用:將代碼改為使用 PyTorch 加速,或應用喺自定義任務上。
配合其他資源,例如 Karpathy 嘅 RNN 博客(提供 GitHub 代碼),可以深化理解。Medium 系列《Ilya Sutskever’s 30 Foundational Papers of AI, Explained》提供簡明解釋。YouTube 視頻《The List That Changed AI Forever》亦有探討該清單嘅影響。
喺教育領域,呢個項目可以作為課程補充:斯坦福 CS231n 已包含類似實作。對於從業者,呢啲手動實作有助診斷模型問題,例如梯度流動相關問題。
結論
“Sutskever‑30‑implementations”項目以純 NumPy 重現 AI 奠基論文,搭建理論與代碼之間嘅橋樑,幫助學習者掌握大部分 AI 精髓。其實現重點係暴露底層原理,事實依據包括 GitHub 同 Aman.ai 等可靠來源。喺 AI 時代,呢類開源資源有助推動人由「使用者」向「理解者」轉型,值得收藏同實踐。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請瀏覽:
https://www.airosetta.com