
喺人工智能飛速發展嘅2025年,強化學習(Reinforcement Learning, RL)已成為提升大型語言模型(Large Language Models, LLMs)推理能力嘅「殺手鐧」。基於強化學習嘅思維鏈(Chain‑of‑Thought, CoT)廣泛應用喺各大推理模型之中。為此,清華大學同上海人工智能實驗室聯合發布嘅117頁(正文部分68頁)綜述論文《A Survey of Reinforcement Learning for Large Reasoning Models》(arXiv:2509.08827)系統剖析咗RL點樣將LLMs轉型成大型推理模型(Large Reasoning Models, LRMs),喺數學、編程、代理任務等領域實現突破。該論文由Kaiyan Zhang等39位作者執筆,發表喺2025年10月10日,聚焦RL嘅核心組件、訓練資源、應用場景及挑戰,標誌住RL由對齊工具向推理引擎嘅躍升。本文基於該綜述,提供深度技術解讀,剖析RL嘅數學基礎、創新機制與未來潛力。
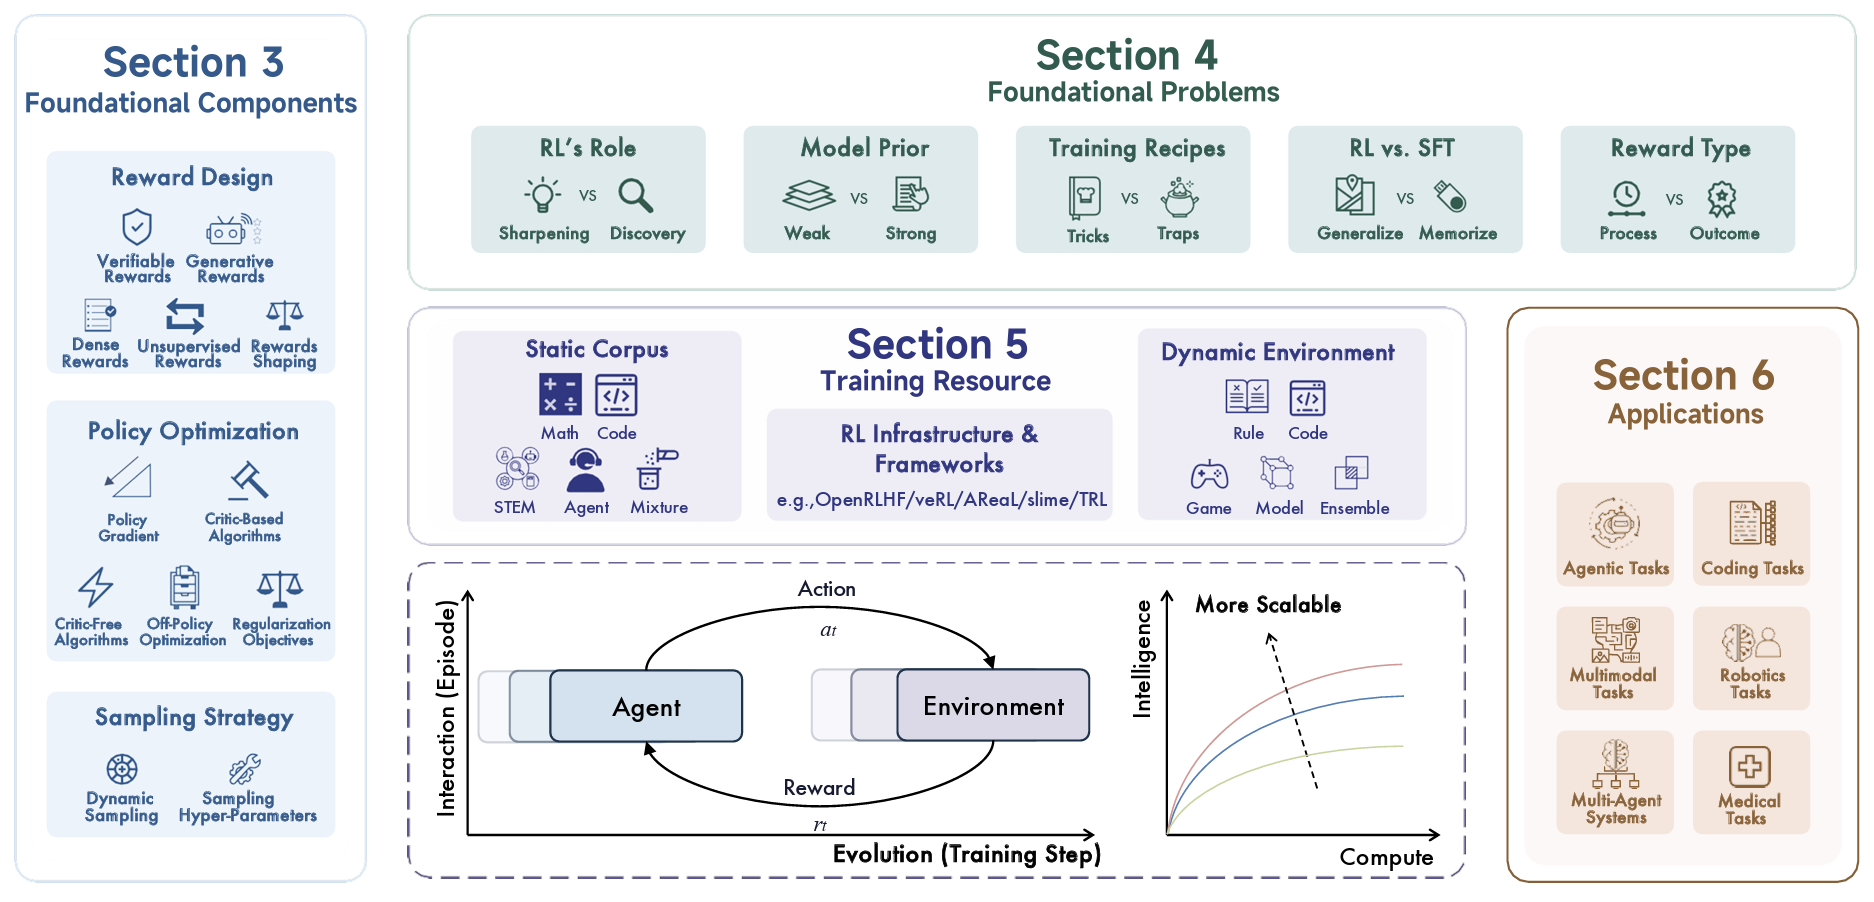
圖 | 綜述概覽 論文介紹咗用於大型推理模型(LRMs)嘅強化學習(RL)嘅基礎組件,以及開放性問題、訓練資源同應用場景。本綜述核心聚焦語言智能體同環境喺長期演化過程中嘅大規模交互。
引言:從LLMs到LRMs嘅範式轉變
傳統LLMs例如GPT‑4雖然喺自然語言生成上表現優異,但面對複雜推理任務(例如多步數學證明或代碼除錯)往往會「卡殼」,單靠靜態監督微調(Supervised Fine‑Tuning, SFT)好難捕捉動態決策路徑。RL嘅介入改變咗呢個局面:透過馬爾可夫決策過程(MDP)框架,RL將LLM視為智能體,提示作為初始狀態,生成序列作為動作,環境反饋獎勵訊號,從而實現策略優化。
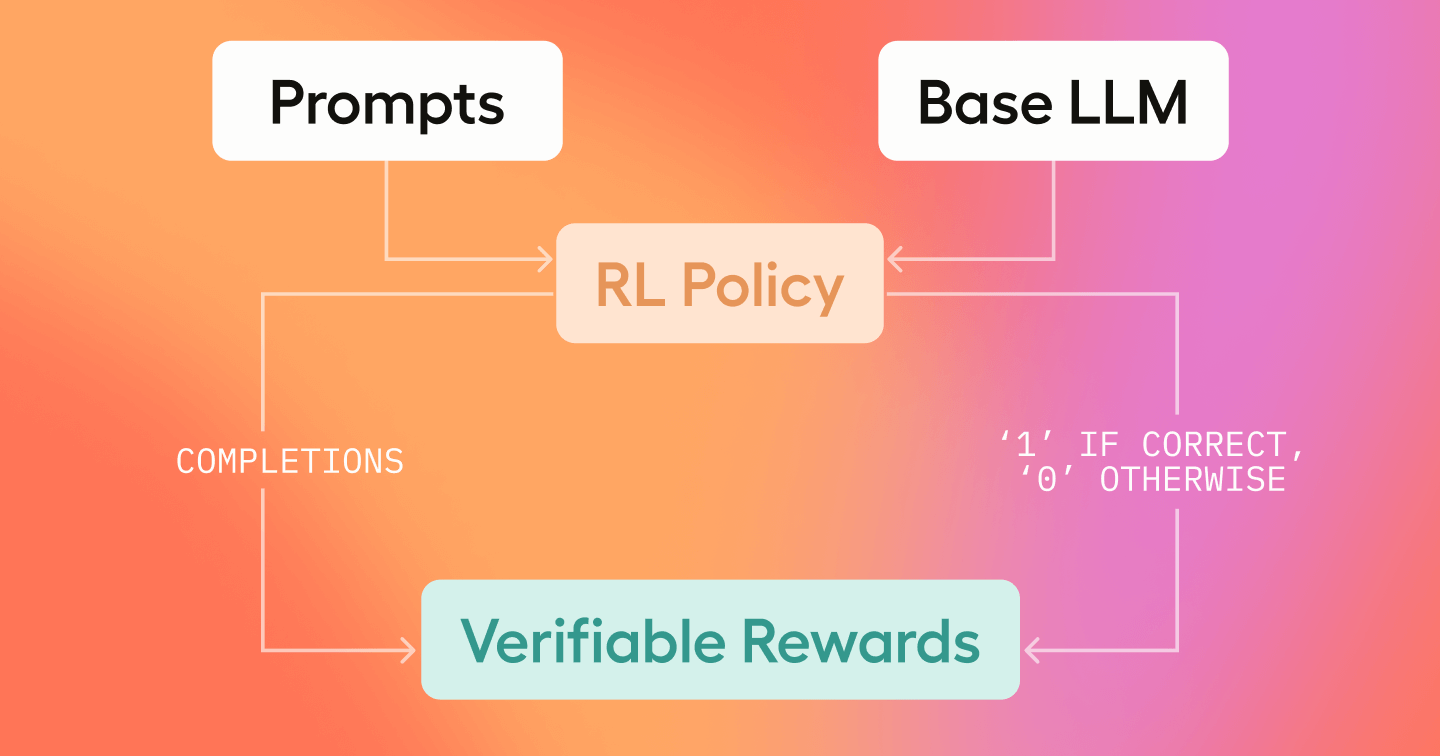
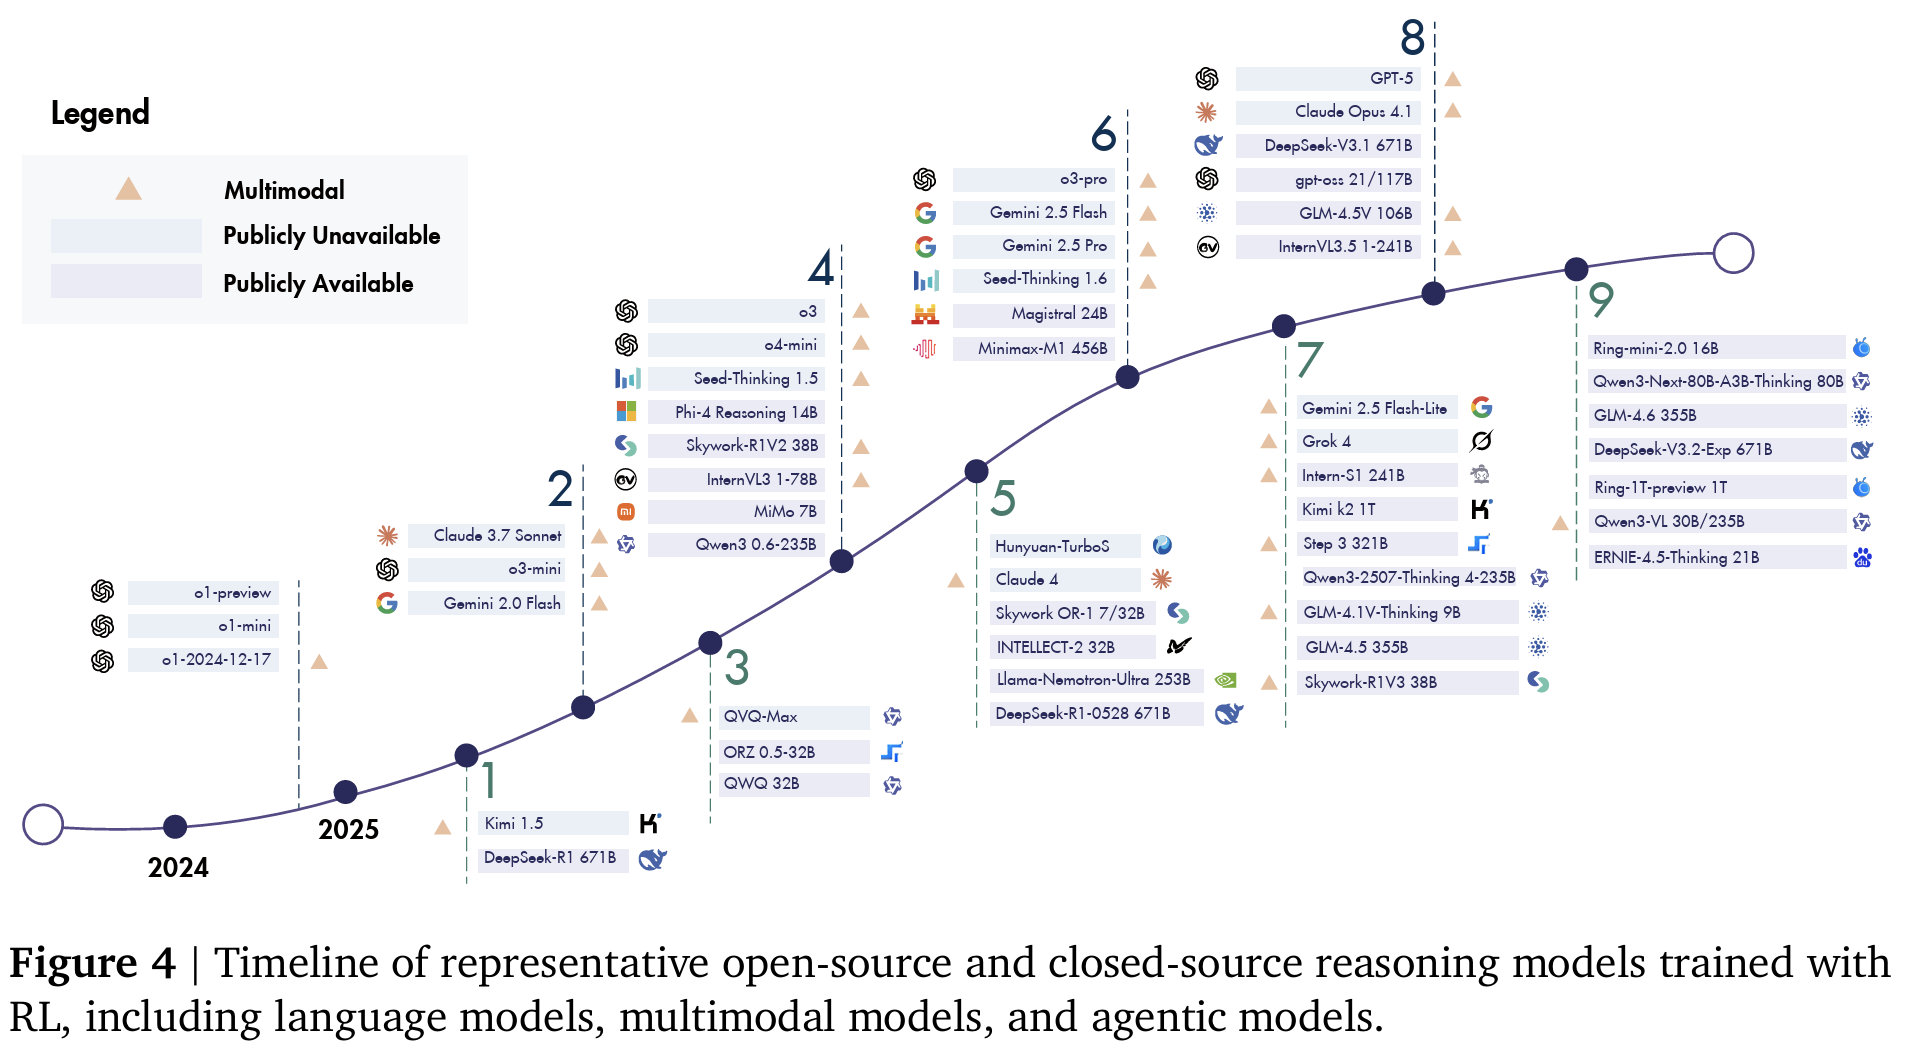
論文強調,RL驅動嘅里程碑模型例如OpenAI o1(閉源,RLVR+推理時計算擴展,喺數學推理上SOTA)、DeepSeek‑R1(開源,GRPO+可驗證獎勵,編程能力媲美o1)、Claude‑3.7‑Sonnet(多模態RL,擅長工具調用)、Gemini 2.0(動態采樣,視覺推理領先)同Qwen3(RL+SFT融合,多任務泛化強),證明RL能夠激發「長鏈推理」(Long Chain‑of‑Thought, Long CoT)同自我糾正機制。相比只優化「說話方式」嘅RLHF(Reinforcement Learning from Human Feedback),RLVR(Verifiable Rewards)直接針對推理正確性,提供更可靠嘅梯度信號。
然而,RL並非萬能:訓練不穩定、獎勵被破解(reward hacking)同計算開銷大都係痛點。論文透過對比RL同SFT/DPO(Direct Preference Optimization),指出RL喺分布外泛化上有優勢,但需要混合策略去平衡效率。呢篇綜述填補咗現有文獻嘅空白,系統梳理RL向通用人工智能(Artificial Superintelligence, ASI)嘅貢獻。
Reinforcement Learning from Verifiable Rewards | Label Studio
預備知識:RL喺LRMs中嘅數學框架
RL嘅核心係MDP元組(S, A, P, R, γ),當中S係狀態空間(提示+生成序列)、A係動作空間(下一個token)、P係轉移動態(LLM生成概率)、R係獎勵函數(正確性分數)、γ係折扣因子(0<γ<1,平衡短期/長期獎勵)。喺LRMs中,LLM策略π(θ)透過策略梯度最大化期望回報J(θ)=E[∑γ^t r_t],梯度∇J(θ)≈E[∇logπ(a|s) A(s,a)],當中A係優勢函數。
論文回顧前沿模型時間線:由RLHF(2022年InstructGPT)到RLVR(2025年o1),開源如DeepSeek‑R1採用弱先驗(由零開始學CoT),閉源如Claude強調強先驗(注入預訓練知識)。同SFT嘅靜態標籤唔同,RL係動態生成數據,解決咗「數據饑餓」問題。但RL需要大量計算資源:o1訓練耗費數萬H100 GPU小時。
基礎組件:獎勵設計、策略優化與采樣策略
獎勵設計:RL嘅「指南針」
獎勵函數R決定優化方向,論文將獎勵分成五類:可驗證獎勵(規則檢查,例如DeepSeek‑R1嘅數學求解器,r=1若正確否則0,可靠但對主觀任務弱);生成型獎勵(模型回饋,例如基於評分表嘅Rubric,成本高但靈活);密集獎勵(步級反饋,例如PRM令牌級熵,緩解信用分配問題);無監督獎勵(內部一致性,例如ZeroGUI);獎勵整形(將稀疏獎勵轉為密集,例如優化Pass@k)。
創新之處在於混合機制:DeepSeek‑R1融合規則同人類偏好,減少被破解風險。數學上,獎勵整形用基線b(s)規範化A(s,a)=r+γV(s')‑b(s),令梯度更穩定。
Reinforcement Learning from Verifiable Rewards | Label Studio
策略優化:由PPO到GRPO嘅演進
策略優化係強化學習驅動大型推理模型(LRMs)嘅核心,目標係最大化期望累積獎勵 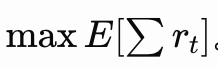 。PPO(Proximal Policy Optimization)透過裁剪比率
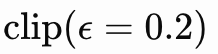 去限制策略更新幅度,避免破壞性大步,確保訓練穩定,但計算密集。REINFORCE 作為基礎蒙特卡洛梯度,易受高方差影響。VCPPO 引入價值評論器作為基線,明顯降噪。
無評論器嘅演算法中,GRPO(Group Relative Policy Optimization)透過組內相對排名構造優勢函數,大幅降低方差,適合資源受限場景。CISPO/GSPO 融入對比學習理念,以 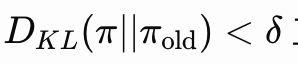 正則化,兼顧探索與保守更新。
論文對比顯示:PPO雖然穩定但需頻繁嘅價值評估;GRPO高效且無需額外網絡;離策略方法例如 PPER(Prioritized Experience Replay)優先回放高TD誤差樣本,提升效率。離策略更新公式為 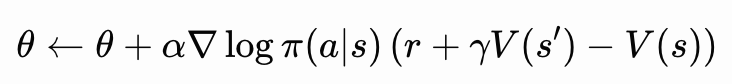 ,結合DQN處理離散動作空間,適合工具選擇等結構化任務。
采樣策略:動態探索嘅藝術
采樣策略係強化學習驅動大型推理模型(LRMs)嘅關鍵,決定探索—利用嘅權衡。PRIME 實現動態溫度自適應(τ ∝ 獎勵),高獎勵軌跡降低隨機性以強化利用,低獎勵則提升溫度鼓勵探索。TreeRL 採用樹狀搜索結構,共享公共前綴大幅減少冗餘計算,提升長鏈推理效率。DeepScaleR 通過元學習優化CoT深度超參數,平衡計算與性能。論文特別指出,ARPO(Adaptive Rejection Sampling)結合拒絕采樣與自適應閾值,顯著鼓勵工具調用(例如代碼執行器、計算器),喺長序列任務中提升生成質量與效率,避免無效探索,適用於數學求解與多步代理場景。
基礎問題:七大爭議嘅辯證剖析
論文另辟蹊徑,深入討論強化學習(RL)驅動大型推理模型(LRMs)嘅七大哲學爭議,揭示方法論本質同實踐張力:
- 「磨練」定「發現」?DeepSeek‑R1透過弱先驗由零開始訓練,展現「發現」新推理路徑嘅能力,例如隱式CoT(無需顯式提示都可以鏈式推理);而OpenAI o1依賴強監督同推理時計算,偏向「磨練」已知策略嘅高效執行。
- RL vs SFT:RL喺分布外泛化上更強,能探索未見嘅任務空間;監督微調(SFT)則記憶高效,適合知識密集型任務。UFT(Unified Fine‑Tuning)提出融合範式,先用SFT注入知識,再用RL激發推理。
- 模型先驗強度:弱先驗(例如R1)激發創新,容易產生非傳統解法;強先驗(例如Claude)確保穩定性,減少幻覺。
- 訓練配方:KL散度正則、價值裁剪等技巧提升收斂,但熵崩潰、模式崩潰等陷阱要警惕。
- 獎勵粒度:過程監督(密集獎勵)引導中間步驟,結果驗證(可驗證獎勵)確保終局正確,混合獎勵兼顧探索同精度。
6–7. 多模態與代理擴展:RL賦能視覺—語言推理同工具調用,但會放大偏見同倫理風險,需透明審計與對齊機制。
呢啲爭議凸顯RL係雙刃劍:潛力能推動突破,但風險要求建立標準化訓練協議同倫理框架。未來需要建立統一基準、開放可重現流水線,先能安全邁向通用推理智能。
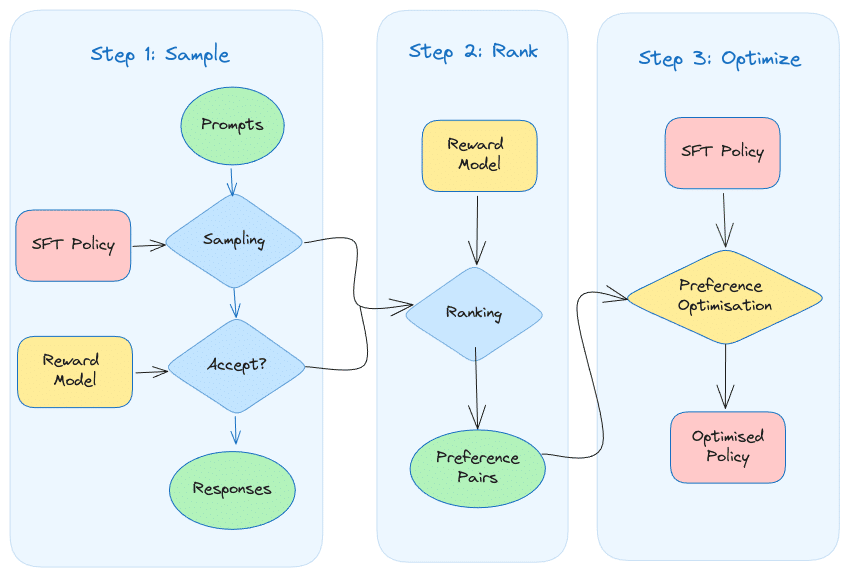
A Deep Dive into Policy Optimization Algorithms & Frameworks for ...
訓練資源:由靜態數據到動態環境
強化學習驅動大型推理模型(LRMs)依賴豐富嘅訓練資源,分為靜態語料同動態環境兩大類。
靜態語料包括:Big‑Math(10,000道數學推理題)、HumanEval(164個編程任務)、MedXpertQA(醫療診斷問答)等,提供高質量監督信號。
動態環境就支援實時交互反饋,分類為:規則基(例如SymPy數學求解器)、代碼基(線上編譯執行單元測試)、遊戲基(Minecraft構建與導航任務)、模型基(GUI模擬器驅動視覺—語言交互)。論文表4對比顯示,SWE‑bench包含超過2,000個真實GitHub倉庫,覆蓋複雜軟件工程場景。
RL基礎設施顯著降低訓練門檻:OpenRLHF支持異步策略—價值更新;TRL整合工具調用與拒絕采樣;veRL實現可中斷長序列生成;AReaL擴展到多模態RL。呢啲開源框架加速社區創新,推動由實驗室原型向工業級LRMs快速迭代。
應用場景:RL嘅多維落地
編碼與代理任務
喺編碼領域,Claude‑4.1‑Opus用單元測試獎勵優化SWE‑bench,準確率超過40%;R1‑Code‑Interpreter融合監督同RL,提升調試效果。代理任務方面,Kimi K2多輪交互、UI‑TARS GUI grounding(IoU獎勵)達到85%精度。
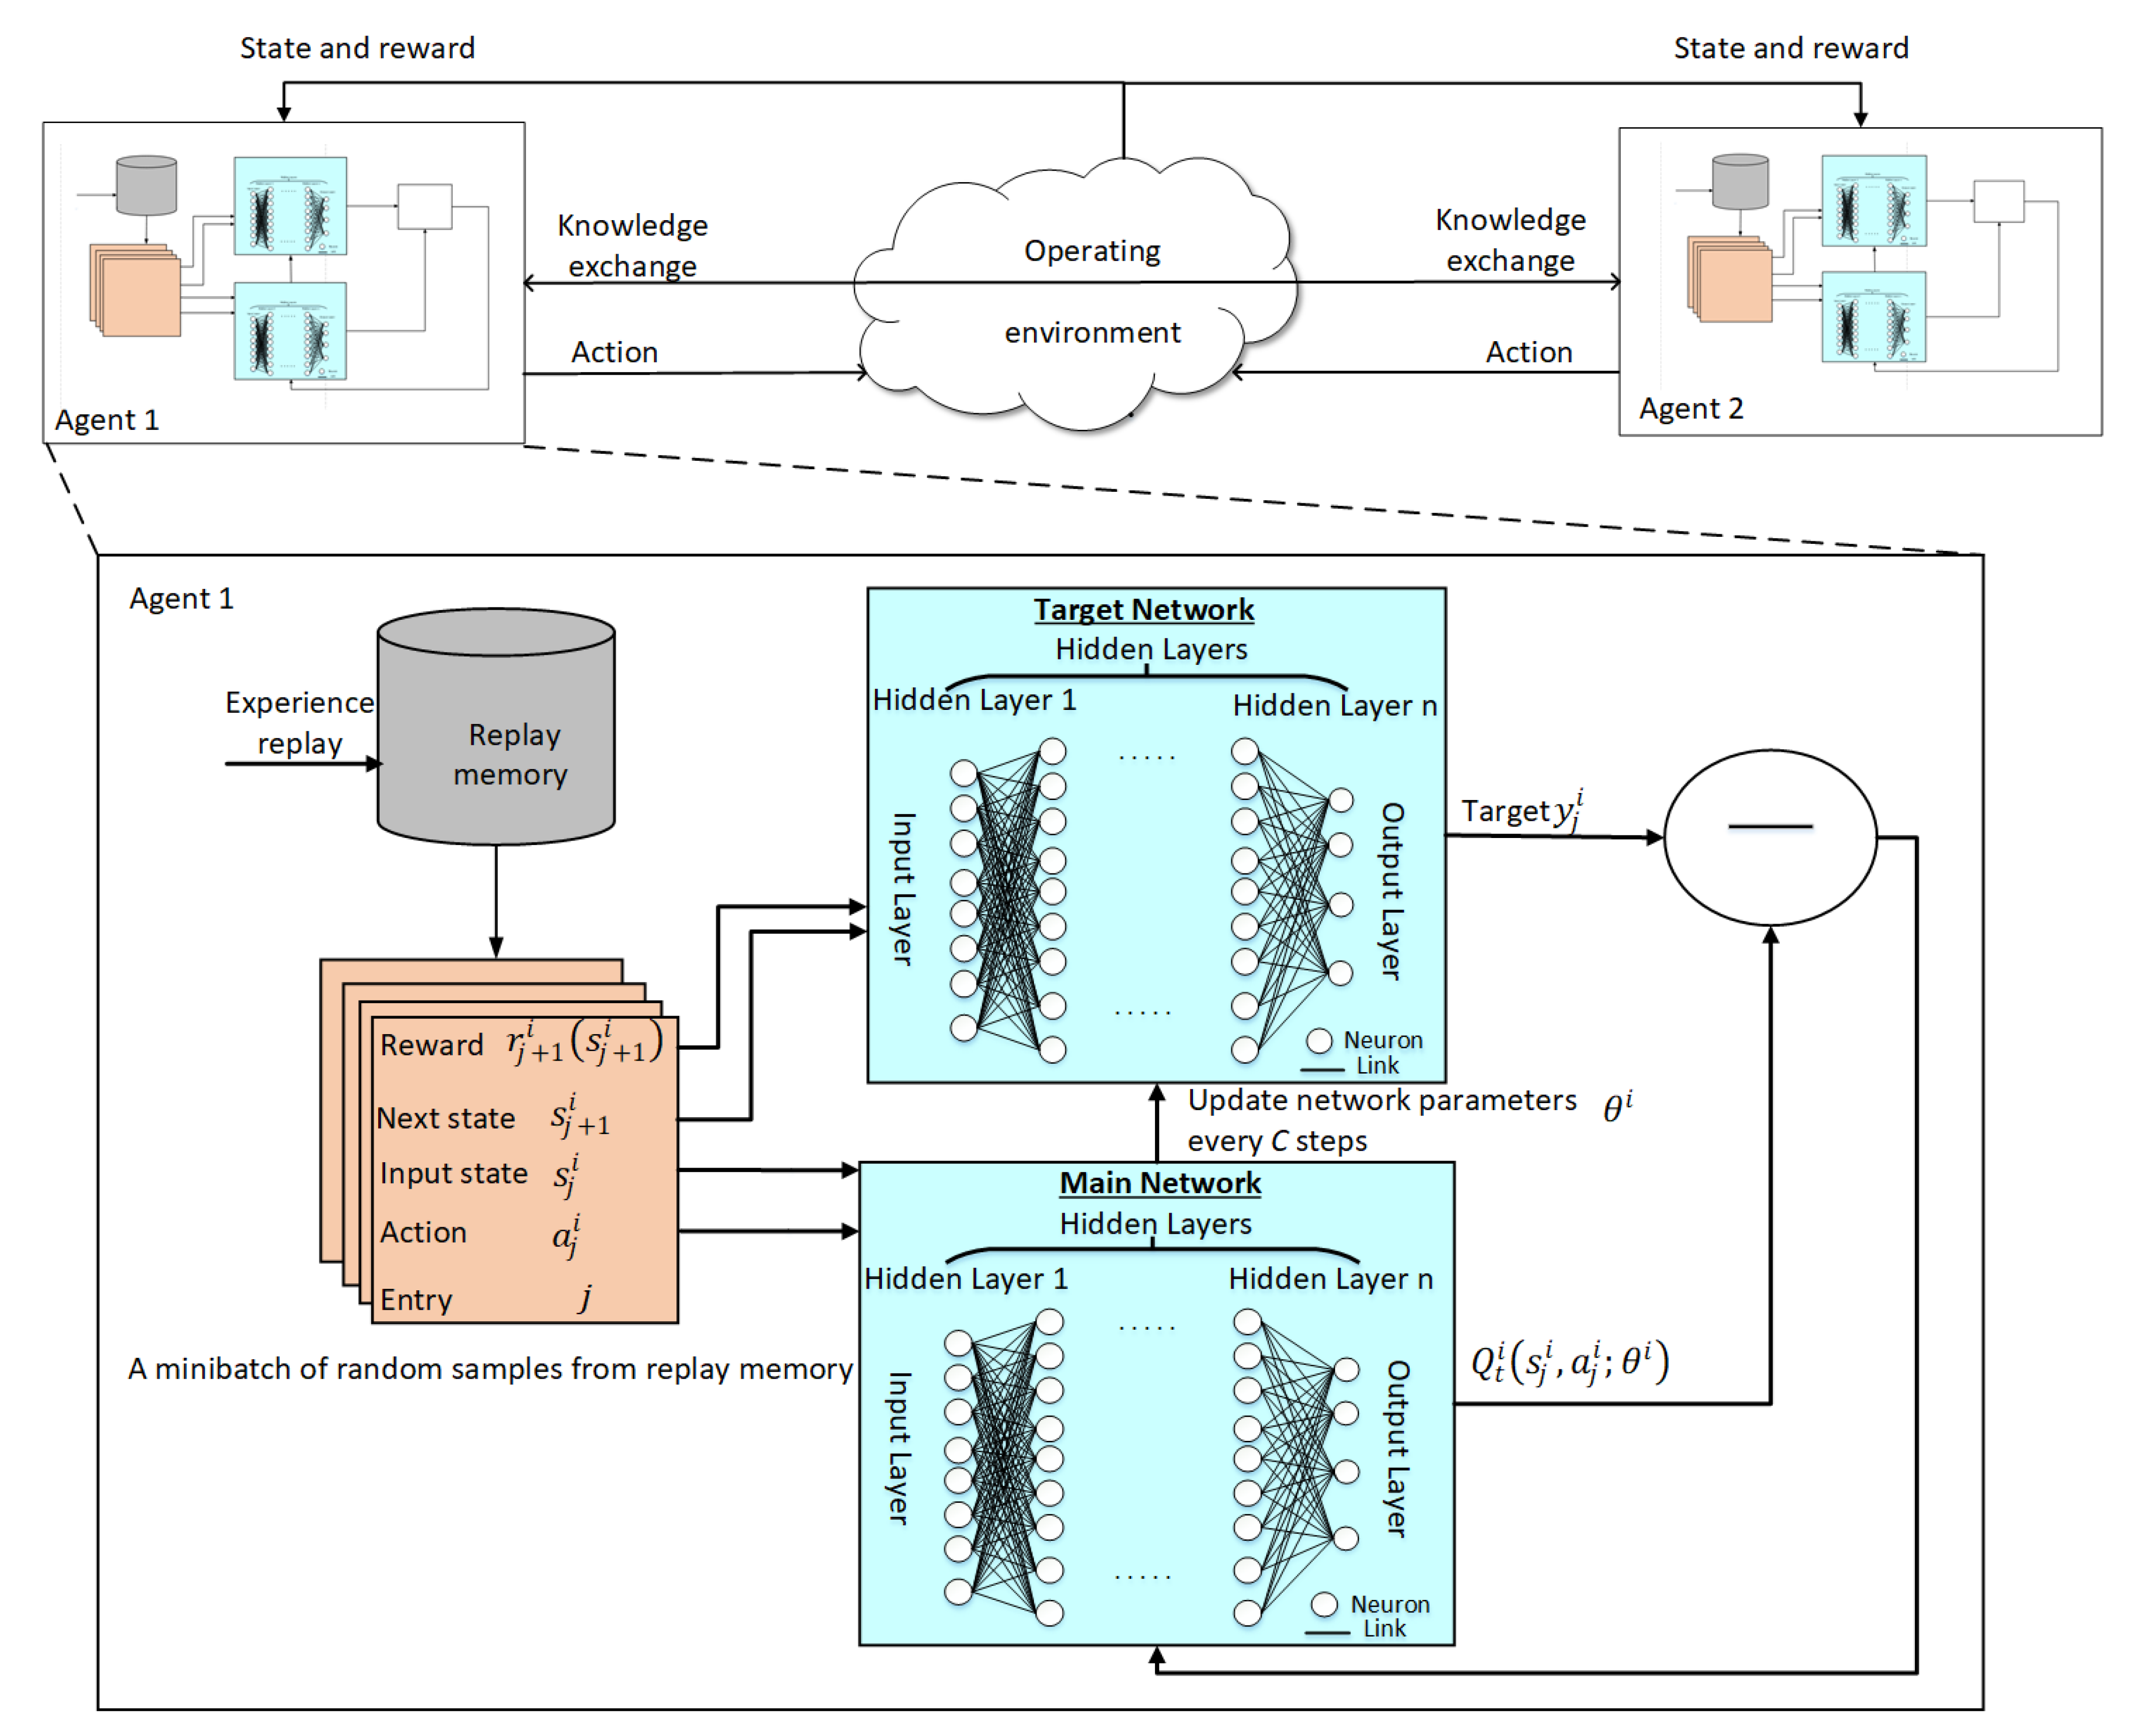
Applications of Multi‑Agent Deep Reinforcement Learning ...
多模態、機械人與醫療
強化學習喺大型推理模型(LRMs)中嘅應用擴展到多模態、機械人同醫療領域,展現跨界潛力。
- 多模態:InternVL3.5透過Cascade RL框架(離線+在線階段)喺視覺推理領域領先,提升MMM U等任務約16%性能,支持GUI交互;Video‑R1引入T‑GRPO算法,強化時序CoT,融合圖像—視頻數據,喺VSI‑Bench達到35.8%準確率,超越GPT‑4o。
- 機械人:SimpleVLA‑RL採用GRPO優化動作模型,解決數據稀缺問題,透過二元成功獎勵同探索調制,提升長時序規劃與仿真—現實遷移,喺LIBERO基準泛化超越SFT。
- 醫療:Med‑U1利用混合規則獎勵(二元+長度罰項),診斷準確率提升20%;BoxMed‑RL強調格式獎勵,確保報告結構化輸出,提升臨床一致性。
多代理例如LLaMAC採actor‑critic框架協作推理,優化大規模決策;MARTI支持自然語言反饋嘅多代理RL訓練,強化團隊決策效率,推動集體智能演進。
挑戰與未來方向:由瓶頸到突破
大型推理模型(LRMs)喺強化學習驅動下雖然展現強大潛力,但仍面臨五大核心挑戰:
- 1. 訓練不穩定,易陷入熵崩潰(entropy collapse),導致策略過早收斂至低多樣性輸出,可透過熵正則 H(π)>β H(\pi) > \beta H(π)>β 強制探索以維持策略多樣性;
- 2. 探索不足,傳統固定溫度采樣難以平衡探索—利用,ε‑greedy 或自適應溫度機制(例如PRIME)可動態調節;
- 3. 計算開銷高,長鏈推理需要海量GPU時,混合專家模型(Mixture of Experts, MoE)同並行采樣協同可顯著降本;
- 4. 泛化能力弱,喺分布外任務(例如新型數學問題)表現不佳,需透過對抗性數據增強同元學習提升魯棒性;
- 5. 可解釋性差,黑盒決策難以審計,注意力權重可視化、歸因分析同因果干預成為關鍵。
LRMs未來方向涵蓋十二大前沿突破:持續強化學習(經驗回放緩衝長時記憶);記憶增強(外部向量數據庫存儲歷史軌跡);模型基獎勵(世界模型預測未來狀態以生成內在獎勵);高效教學(自適應計算預算分配);潛在空間優化(將離散令牌映射到連續空間以加速梯度);RL預訓練(以next‑token預測為獎勵構建通用策略);擴散式RL(將ODE求解器擴展為SDE,支持圖像/視頻生成);科學發現閉環(自生成假設—驗證循環);架構協同(MoE動態路由+RL聯合訓練);自監督獎勵(Self‑Rewarding模型自我評估);測試時計強化學習(TTRL,喺推理階段在線微調);多代理鏈式推理(Chain‑of‑Agents,子代理分工協作)。呢啲方向共同指向自我進化、長程規劃與世界理解嘅超智能LRMs。
結論:RL通往ASI嘅橋樑
本綜述聚焦強化學習驅動嘅大型推理模型(LRMs)前沿進展,透過可驗證獎勵強化學習(RLVR),成功將大型語言模型由「識講」升級為「識推理」。有別於RLHF等人類對齊方法,RLVR以結果正確性為導向,系統梳理咗獎勵設計、策略優化、采樣策略等核心機制,剖析訓練爭議,匯總靜態/動態資源同基礎設施,並展望編碼、代理、多模態等應用場景。未來,RL或將成為通往超智能嘅關鍵引擎,推動語言模型實現長鏈推理、自我進化同世界建模嘅突破性飛躍。