
2026年9月23日,中國嘅阿里巴巴旗下通義千問正式發佈Qwen‑Audio‑3.1系列語音大模型。今次升級唔單止係對語音識別(ASR)、語音合成(TTS)同實時語音交互(Realtime)三大核心模型做全面進化,仲全新推出音頻創作模型Qwen‑Audio‑3.1‑TTS‑Next同音頻理解模型Qwen‑Audio‑3.1‑ASR‑Next。五款新模型同步亮相,構成覆蓋「理解—生成—交互—創作」嘅完整音頻能力棧。為咗進一步降低使用門檻,Qwen‑Audio全線語音模型價格全部大幅下調,其中TTS降約70%、Realtime降約85%、ASR最高降幅達95%。
詳細情況與核心能力
Qwen‑Audio‑3.1‑ASR聚焦於更強嘅上下文理解同轉寫潤色。模型進一步加強多語種、方言識別能力,新增原生轉寫潤色功能,可自動去除語氣詞同重複表達並重組語義,令輸出文本更順暢、更有邏輯。支援端到端分角色轉寫,聯合輸出說話人標籤、時間戳同文本。單一模型覆蓋30種語言同16種中文方言,串流識別首字響應時間約160毫秒。實測喺開源方言測試集上平均字符錯誤率(CER)為4.55%,中文方言自建集平均CER為10.38%,方言轉普通話平均語義句準確率達82.10%。
Qwen‑Audio‑3.1‑ASR‑Next係基於下一代架構嘅音頻理解模型,將能力由「語音入面嘅文字」擴展到完整嘅音頻信息。佢可以識別人物情緒、環境聲同機械聲,支援聲音描述、事件定位、音頻問答同推理。面對包含人物對話、背景音樂同環境聲嘅複雜音頻,模型唔單只可以輸出對話文字,仲可以描述聲音構成、事件發生時間,並回答相關問題。
Qwen‑Audio‑3.1‑TTS強化自然跨語言音色合成。支援多語種及方言合成,同一音色可以實現自然嘅跨語言遷移。用戶可透過簡單文本指令控制情緒、語速同風格,例如「用尖銳、命令式嘅語氣朗讀,要求權威感」。
Qwen‑Audio‑3.1‑TTS‑Next面向音頻創作,採用語言模型同擴散方法結合嘅架構,一次性生成人聲、音效同背景音頻。支援多角色音色復刻、細粒度時間戳控制同48kHz輸出,適用於播客、有聲書、影視同遊戲音頻製作等場景。
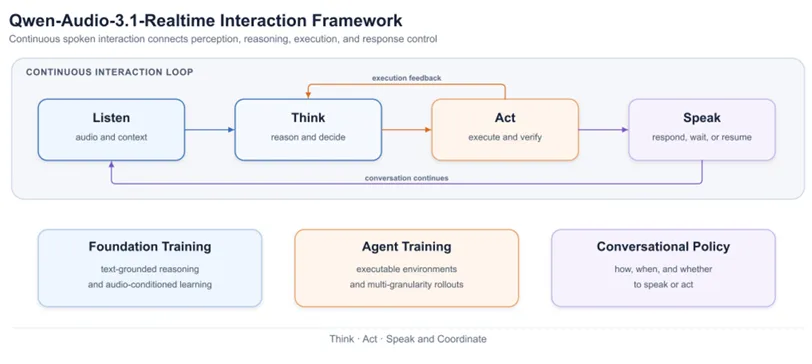
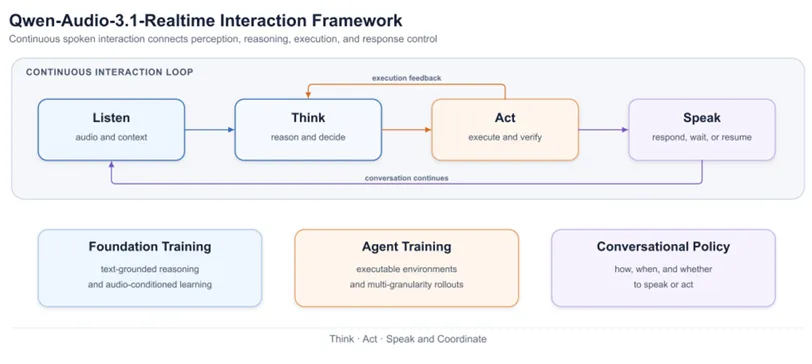
Qwen‑Audio‑3.1‑Realtime實現全雙工實時交互,支援邊講邊聽同隨時打斷。模型基於多教師蒸餾架構,可以感知情緒並調整回應節奏(例如檢測到低落情緒時放慢語速並更顯共情),同時支援多語言實時切換及會話中嘅工具調用。部分版本提供長達262K上下文,並支援函數調用同聲音克隆。
目前,ASR同Realtime等模型已上架千問AI平台(阿里雲Model Studio),ASR‑Next同TTS‑Next嘅API即將開放。部分TTS相關嘅開源權重亦以Apache 2.0協議發佈。
價格調整與獲取方式
今次全線降價力度顯著:TTS約降70%、Realtime約降85%、ASR最高降95%。大幅降價直接降低咗開發者同企業嘅使用門檻,有利推動語音能力喺客服、內容創作、智能硬件同Agent場景中嘅規模化落地。
可能影響
呢次發佈進一步完善咗通義千問喺音頻領域嘅能力矩陣,從傳統語音識別同合成擴展到理解環境聲、創作完整聲景以及全雙工智能交互,形成更完整嘅閉環。對國內開發者嚟講,大幅降價同多方言支援顯著提升可及性,特別有利於中小團隊同內容創作者快啲落地多語種、多方言應用。
喺行業層面,Qwen‑Audio‑3.1同同期嘅Google Gemini 3.8 Flash TTS等產品形成直接競爭,加速咗語音大模型由「能用」向「好用、平、可創作」嘅演進。實時交互同情緒感知能力嘅增強,都進一步推動語音成為人機交互嘅自然入口,並同千問辦公、Qoder等Agent以及AI眼鏡等硬件形成聯動。
長遠睇,完整嘅音頻能力棧同激進嘅定價策略,有望提升通義喺語音賽道嘅市場份額,並促使更多企業將語音功能由輔助工具升級為核心交互層。與此同時,複雜音頻理解同創作場景嘅實際表現,以及API穩定性同延遲表現,仍然係後續驗證嘅關鍵。
總體而言,Qwen‑Audio‑3.1系列透過能力升級同大幅降價,既補強咗技術棧,亦主動降低咗行業使用成本,標誌住國內語音大模型進入更注重實用同規模化落地嘅新階段。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請瀏覽: https://www.airosetta.com