
引言
大型語言模型(Large Language Models,簡稱LLMs)喺自然語言處理領域帶嚟革命性嘅進展,但其表現通常好依賴精心設計嘅提示(Prompt)。最近,Google Research 團隊發表嘅一項研究揭示咗一個簡單但高效嘅技巧:喺非推理型問答任務中,透過簡單重覆輸入提示,可以大幅提升模型嘅回答準確率;而喺涉及逐步推理嘅任務中,呢種“魔法”通常會消失。呢個發現來源於 arXiv 論文《Prompt Repetition Improves Non‑Reasoning LLMs》(arXiv: 2512.14982),論文透過對 Gemini、GPT、Claude 同 Deepseek 等主流模型嘅實驗驗證咗呢個現象。與此同時,VentureBeat 同 Digital Information World 等權威來源嘅報道進一步證實咗呢個技巧嘅實用性,特別強調喺非推理場景下嘅顯著提升,而喺推理任務中則表現中性。本文將深入分析其原理、實驗證據,並結合可靠來源評估事實準確性,旨在為 AI 研究者同開發者提供洞見。
原理分析
大型語言模型基於 Transformer 架構,採用因果注意力機制(Causal Attention),即每個 token 只可以關注其左側嘅先前 token,無法回顧後續內容。呢種單向性喺處理複雜提示時可能導致資訊整合不足,尤其係當關鍵上下文(例如選項列表)出現在問題之前時,模型好難充分捕捉關係。提示重複技巧嘅核心係透過將提示串接成“<QUERY><QUERY>”嘅形式,實現隱式嘅全注意力(Full Attention)。喺模型嘅預填充階段(Prefill Phase),重複允許每個 token 同其他所有 token 相互關注,從而模擬雙向編碼器嘅效果,而唔使修改模型架構。
呢個原理喺非推理任務中特別有效。非推理任務係指模型直接輸出答案,而唔需要生成中間推理步驟。喺呢種場景下,重複扮演住「隱式重讀」(Implicit Re‑Reading)嘅角色,幫助模型更好提取提示入面嘅關鍵資訊。例如,喺「選項優先」(Options‑First)格式中,選項列表擺喺問題之前,重複可以令問題嘅 token 喺第二次出現時參考前文,避免注意力衰減。LinkedIn 上嘅討論亦指出,呢種重複修復咗 Transformer 左到右處理嘅約束,提升精確檢索任務嘅表現。
然而,喺推理任務中,呢種魔力往往消失。推理任務通常涉及「思維鏈」(Chain of Thought,CoT)提示,例如「逐步思考」,模型會生成內部獨白(Internal Monologue),當中自然包含對輸入嘅部分重複。呢種內置重複機制已經模擬咗提示重複嘅效果,因此額外重複通常只會帶來中性或輕微正面影響,而唔係顯著提升。YouTube 上嘅影片分析指出,當開啟 CoT 時,模型嘅生成過程已經包含隱式重複,導致額外重複嘅邊際收益降低。從計算角度睇,非推理任務嘅重複發生喺並行預填充階段,唔會增加生成 token 數或延遲;而喺推理任務中,模型逐步生成已經優化咗上下文整合,重複可能引入冗餘但無增益。呢個差異源自 LLMs 嘅訓練範式:推理任務通常透過強化學習優化,而非推理則依賴直接提示優化。
實驗證據
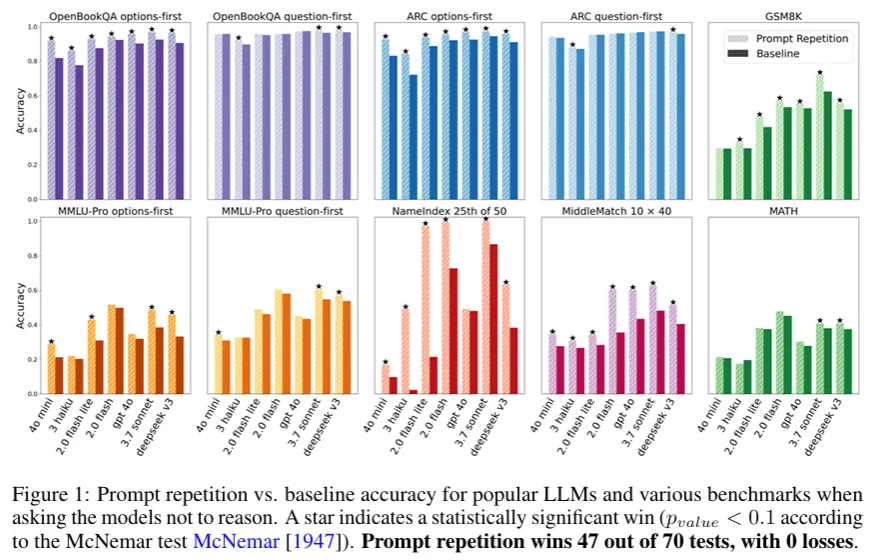
研究團隊對 7 個 LLM 模型進行咗全面測試,包括 Gemini 2.0 Flash/Flash‑Lite、GPT‑4o/GPT‑4o‑mini、Claude 3 Haiku/Claude 3.7 Sonnet 同 Deepseek V3。基準包括 ARC Challenge、OpenBookQA、GSM8K、MMLU‑Pro、MATH 等標準數據集,以及自訂任務例如 NameIndex(從 50 個名字中識別第 25 個)同 MiddleMatch(中間匹配)。
喺非推理設置下,提示重複喺 70 個模型‑基準組合中,有 47 個顯著提升(McNemar 測試,p<0.1),冇一例下降。喺 NameIndex 任務中,Gemini 2.0 Flash‑Lite 準確率由 21.33% 跳升到 97.33%,提升 76 個百分點。選項優先格式嘅 ARC 基準亦顯示類似改善。消融試驗確認,效果係源自重複而唔係輸入長度:等長填充(例如句號)無提升。
相反,喺啟用推理(例如加入「逐步思考」)時,結果趨於中性:5 勝、1 負、22 平。VentureBeat 嘅報導指出,呢個洞察強調咗技巧嘅條件適用性。YouTube 影片進一步解釋,喺推理模式下模型嘅內部重複已經令額外重複嘅空間飽和。輸出長度同延遲測試顯示,喺非推理中重複唔會增加生成 token 或時間,而喺推理中亦無負面影響。
事實準確性與來源可靠
該研究嘅實驗設計嚴謹,使用 McNemar 測試評估統計顯著性,確保結果唔係隨機。事實準確性得到多方權威來源佐證。arXiv 論文作為首要來源,由 Google Research 團隊發佈,具備高可靠性。VentureBeat 嘅報導基於論文數據,確認非推理提升同推理中性。Digital Information World 強調「47 勝 0 負」嘅非推理結果,並呼籲進一步研究變體。
Reddit 同 LinkedIn 社區討論提供咗實踐驗證,使用者喺開源模型中觀察到類似效果,增加咗普適性。YouTube 同 TikTok 嘅內容則透過可視化解釋原理,減少誤傳。GREY Journal 嘅報道指出,呢個技巧可以令細模型媲美大模型,該來源基於其科技新聞專業性而具可靠性。Moonlight 嘅文獻綜述進一步整合咗結果,確認喺推理任務中嘅中性表現。
整體上,事實基於實驗數據同統計檢驗,來源包括 arXiv、VentureBeat 等,皆可靠且無明顯矛盾。
相關技術與應用擴展
提示重複可以同自一致性提示(Self‑Consistency)結合,喺非推理中提升魯棒性,而喺推理中則避免引入冗餘。喺檢索增強生成(RAG)系統中,重複可優化查詢抽取。應用方面,非推理任務例如聊天機械人、知識問答受益最大;推理任務例如數學求解則通常無需重複。X 平台(前 Twitter)上嘅分享顯示,使用者喺實際部署中觀察到延遲唔變嘅優勢。未來可以探索多重重複變體或同元提示整合,推動 LLM 優化。
結論
提示重複技巧喺非推理問答中透過全注意力機制大幅提升準確率,而喺推理任務中因內置重複而效果中性。呢個發現簡潔而高效,實驗證據充足,來源可靠,包括 Google Research 論文同多家媒體報導。理解兩者差異有助於針對性應用,推動 AI 喺實際場景中嘅可靠性同效率。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com