
2026年9月22日,就喺Anthropic啱啱發佈Opus 5.5之後,OpenAI正式推出GPT‑6 Sol同GPT‑6 Luna,進一步擴充GPT‑6系列。此前本月已發佈旗艦模型GPT‑6 Astra,今次兩款新模型將Astra喺推理、事實性、編碼、電腦使用與對齊等方面嘅改進下沉到更快、更平嘅層級,並對應GPT‑5.6相應型號實現約50%嘅API價格下調。發佈時機緊隨Anthropic Claude Opus 5.5之後約90分鐘,體現咗當前前沿模型競賽嘅高強度。
詳細情況
定位與能力
- GPT‑6 Sol:面向日常複雜任務與軟件開發,適合編碼、調試、重構、多步驟工作流及跨工具協作。官方稱其喺內部事實性評估中錯誤率約為前代GPT‑5.6 Sol嘅一半,達到接近Astra級別嘅可靠性,同時喺編碼與電腦使用能力上有提升。
- GPT‑6 Luna:系列中最高效嘅模型,針對高並發、目標明確嘅輕量任務,如摘要、資訊抽取、分類與路由。支援可調節推理力度,以平衡質量、速度與成本。
兩款模型均繼承Astra嘅訓練方法改進,支援約100萬token上下文窗口,並喺ChatGPT Work、Codex及API中可用。Plus、Pro、Business、Enterprise與Edu用戶可使用Sol與Luna;Free與Go用戶可喺桌面端體驗Luna。普通Chat介面初期未同步開放。
定價
官方公布嘅API價格(每百萬token)為:
- GPT‑6 Sol:輸入2美元、輸出10美元(較GPT‑5.6 Sol促銷價下降50%)
- GPT‑6 Luna:輸入0.10美元、輸出0.50美元(輸入下降50%,輸出下降約58%)
緩存讀取享受大幅折扣(約輸入價嘅10%)。OpenAI表示,緩存與推理效率提升令其得以將成本節省直接回饋用戶。更高用量限額與更低單價,旨在支持更大規模迭代與Agent工作流。
基準表現
OpenAI公布嘅對比顯示,Sol喺AutomationBench等業務工作流測試中,以明顯更低嘅單任務成本達到或超過部分更高價競品(包括前代Anthropic模型)嘅表現;喺DeepSWE等軟件工程任務上接近頂級分數且成本顯著更低。獨立評測指出,價格腰斬令兩款模型喺「智能‑成本」帕累托前沿上佔據有利位置,幻覺率亦有下降,但綜合智能指數與前代大致持平,部分編碼Agent指標互有漲跌。需注意,多數數據仍以廠商報告與初步第三方結果為主。
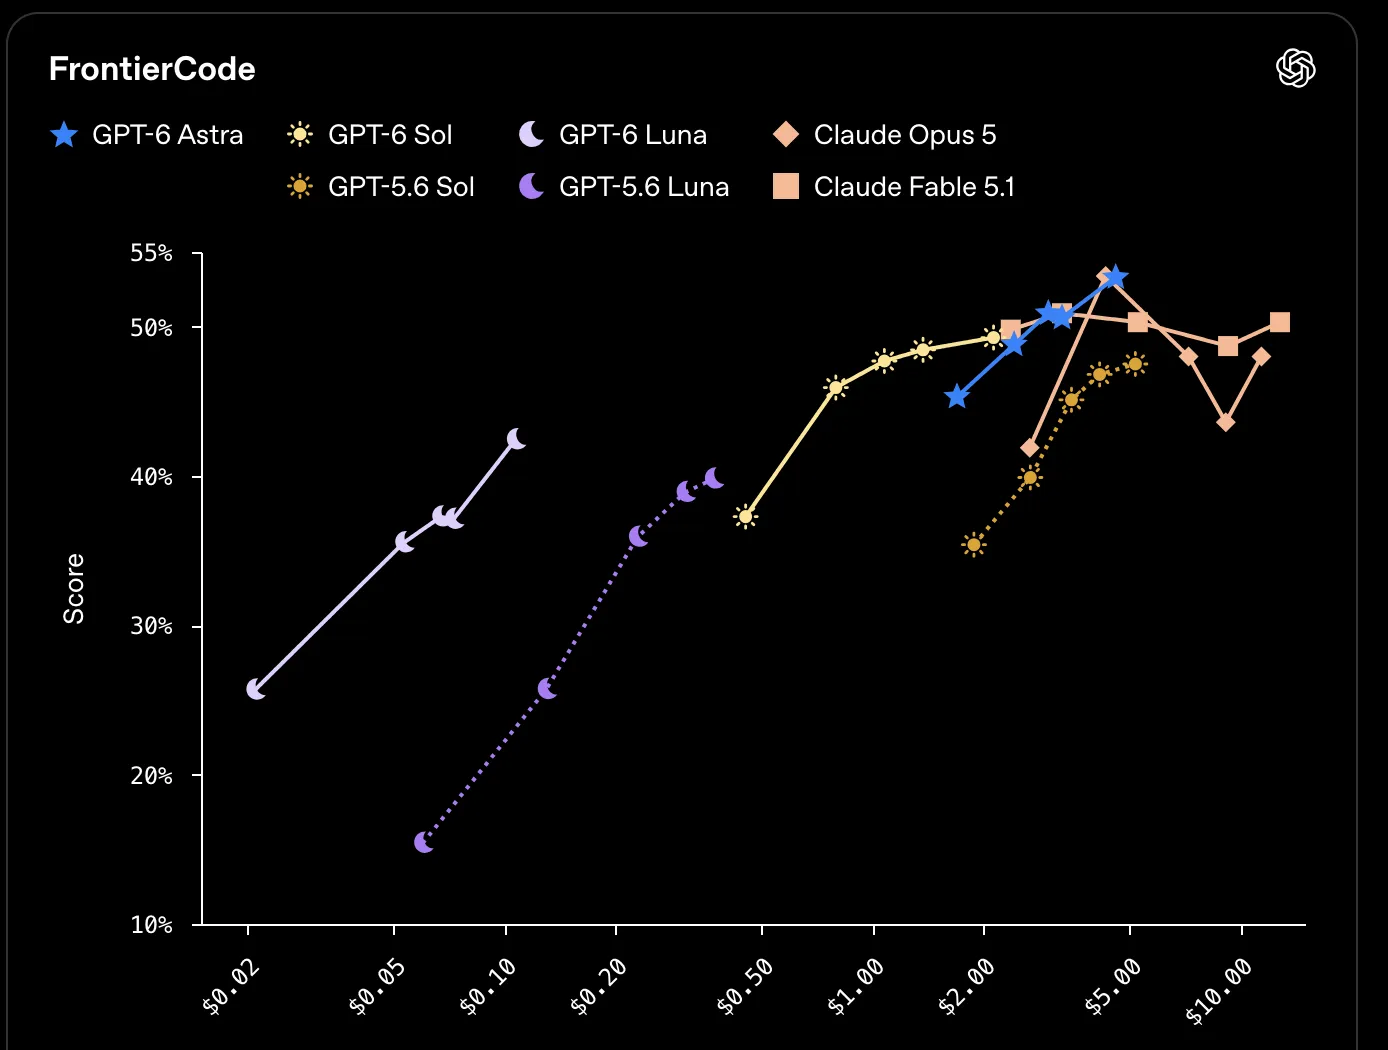
Cost per task
可能影響
1. 中端與高性價比市場競爭加劇
Sol與Luna嘅半價策略,直接回應咗Anthropic同日發佈嘅Opus 5.5(亦大幅降價)。兩者共同將「能力接近旗艦、價格顯著更低」變成行業標配,迫使開發者與企業重新評估模型選型:旗艦用於最難任務,中端用於規模化生產。Terra層級喺今次更新中未同步出現,產品線進一步向Sol/Luna聚焦。
2. Agent與規模化應用門檻下降
更低單價與更高限額,令長週期Agent循環、大規模代碼處理與高並發分類/抽取任務喺經濟上更可行。結合緩存優化,實際單任務成本可進一步壓縮,有利於推動AI由試點走向日常生產。
3. 事實性與可靠性成為賣點
OpenAI特別強調錯誤率減半與對齊改進,反映行業喺追求能力嘅同時,正將「更少幻覺、更可靠輸出」作為差異化重點。對專業工作與自動化場景,呢點比單純刷榜更具實際價值。
4. 發佈節奏與競爭格局
與Anthropic幾乎同步嘅降價與能力更新,顯示頭部實驗室正以周為單位爭奪中高端市場份額。用戶將受惠於更快迭代與更低價格,但亦需面對型號快速更迭帶來嘅遷移與評測成本。後續獨立復現與真實工作流數據,將決定Sol/Luna能否真正取代部分更高價調用。
結語
GPT‑6 Sol與Luna嘅發佈,標誌住OpenAI喺旗艦Astra之外,系統性地將前沿進展下沉到可規模化使用嘅層級,並以半價策略強化性價比優勢。佢哋並非追求絕對最強,而係喺速度、成本與足夠智能之間取得平衡,適合編碼Agent、知識工作與高流量任務。結合同日Anthropic嘅動作,2026年下半年嘅模型競爭已由「邊個更強」進一步轉向「邊個能喺可接受成本下提供夠強且可靠嘅能力」。真正檢驗其價值嘅,仍然係開發者喺生產環境中嘅長期使用反饋。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請瀏覽:https://www.airosetta.com