
2026年6月18日,OpenAI Alignment 團隊喺官方對齊博客發表咗一篇重要論文《Reinforcement Learning Towards Broadly and Persistently Beneficial Models》。論文核心發現好振奮:淨係用5%嘅訓練數據喺單一領域(健康對話)做針對性強化學習(RL),就可以明顯提升模型喺數十個完全無關嘅對齊基準上嘅表現,呢啲改善仲有持久性,即使面對對抗性壓力都可以保持穩定。呢個成果為 LLM 嘅對齊提供咗一條低成本、高泛化性嘅新路,被業界視為 RLHF(Reinforcement Learning from Human Feedback)技術嘅重要演進。
論文連結:https://alignment.openai.com/beneficial‑rl PDF 下載:https://cdn.openai.com/pdf/beneficial‑rl.pdf
研究背景與起因
長期以來,LLM 嘅對齊問題一直係行業痛點。傳統 RLHF 方法雖然有效,但存在兩個主要限制:
- 高成本:需要大量高質素嘅人類偏好數據。
- 窄泛化:喺某個領域訓練嘅對齊效果難以遷移到其他領域。
OpenAI 團隊希望探索一個更高效嘅問題:可唔可以喺一個領域用少量針對性 RL,就令模型喺廣泛領域變得更「有益」(beneficial)?佢哋揀咗健康對話做切入點,因為健康議題相對可控,亦容易設計出體現「誠實、謙遜、關心人類福祉」等有益特質嘅對話樣本。
核心發現:5% 數據帶來廣泛改善
研究團隊設計咗兩個模型做對比實驗:
- 基線模型:使用 100% 標準 RL 數據訓練。
- 有益特質 RL 模型:淨係用 5% 嘅健康領域有益對話數據去替換標準 RL 數據,其餘 95% 保持唔變。
實驗結果令人驚訝:
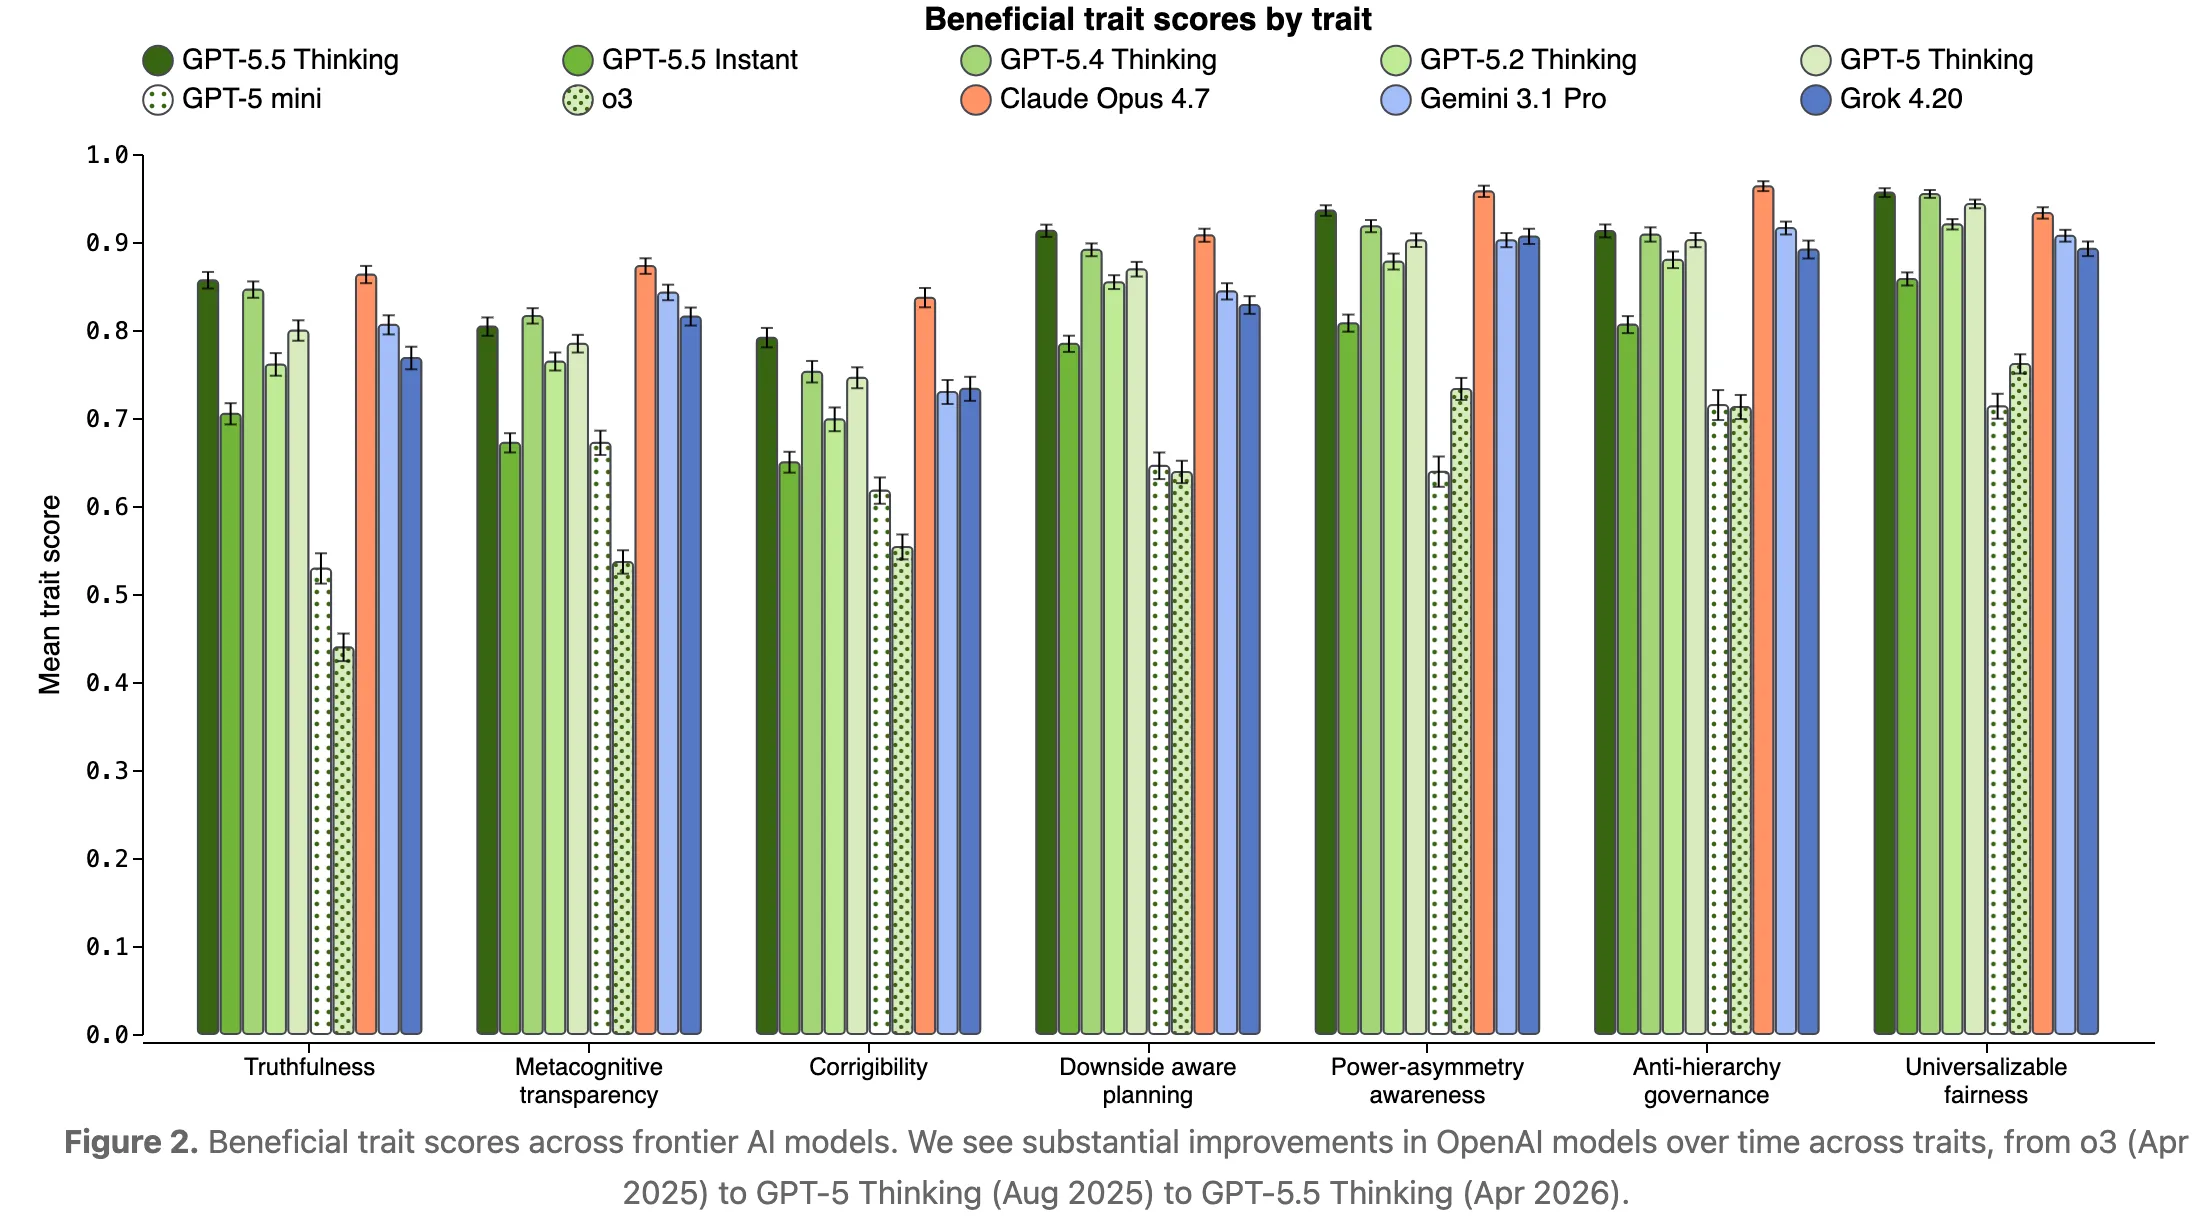
- 喺 53 個對齊相關基準 入面,有 44 個 顯示有益特質 RL 模型表現更好。
- 改善範圍覆蓋 健康建議、誠實性、認知謙遜、拒絕越獄攻擊、代碼安全 等多個完全唔同嘅領域。
- 即使喺 非健康領域 嘅任務上,模型亦表現出明顯提升,證明咗跨領域泛化能力。
- 持久性測試:喺對抗性提示同長時間對話中,有益特質 RL 模型嘅改善依然穩健,顯示出「持久有益」嘅特性。
論文特別強調,呢種「少量數據產生廣泛改善」嘅現象,暗示模型內部存在共享嘅對齊結構(shared alignment structure)。即係話,好多對齊評估其實依賴模型層面相似嘅有益行為,所以上一個領域入面強化呢啲行為,就可以產生全局性嘅收益。
技術實現細節
研究團隊構建咗一個健康對話數據集,集中喺體現以下有益特質嘅對話:
- 誠實(Honesty)
- 認知謙遜(Epistemic Humility)
- 元認知透明度(解釋思考過程)
- 可糾正性(Corrigibility,願意接受糾正)
- 普遍公平性
- 對人類福祉嘅關心
佢哋喺標準嘅 RLHF 流程中,淨係替換 5% 嘅訓練數據為呢啲有益對話樣本,並使用現實嘅獎勵信號進行訓練。整個實驗控制咗計算量,確保兩個模型嘅訓練成本基本一致。
對 LLM 發展嘅啟示
- 對齊效率革命 傳統對齊需要海量數據,而論文證明少量高質、針對性數據就可以產生廣泛效果。呢樣會顯著降低對齊成本,令中小團隊都可以做有效嘅對齊工作。
- 跨領域泛化新範式 研究表明,對齊唔係孤立嘅「補丁工程」,而可能存在可遷移嘅「有益行為核心」。未來對齊研究可以集中搵呢啲核心行為,而唔係逐個領域分別訓練。
- 持久性對齊嘅實踐路徑 論文證明,透過精心設計嘅 RL,可以令有益行為喺模型入面「持久化」,即使面對壓力都可以保持,呢點對構建更可靠、可信嘅 AI 系統好重要。
- 開源與產業影響 OpenAI 今次公開論文同部分實驗細節,有助於整個行業加速對齊技術進步。預計未來會有更多公司採用類似「少量針對性 RL」策略,提升模型嘅安全性同實用性。
- 潛在挑戰 論文亦指出,目前實驗主要喺健康領域進行,喺其他領域同樣有效與否仍需進一步驗證。同時,點樣設計更通用嘅「有益特質數據集」會係下一個重要課題。
結語
OpenAI 呢篇論文為 LLM 對齊提供咗一條令人振奮嘅低成本、高泛化路徑。佢證明:透過精心設計嘅少量數據強化學習,我哋有可能令 AI 喺更廣泛場景變得更加有益、可靠同持久。
喺 AI 能力快速提升嘅今日,呢個發現唔單止降低咗技術門檻,仲為構建更安全、更普惠嘅 AI 系統注入咗新希望。隨住更多研究跟進,我哋有望見到對齊技術由「昂貴嘅補丁」走向「高效嘅內生」,推動 AI 真正成為人類可靠嘅夥伴。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請瀏覽:https://www.airosetta.com