
引言:由 Transformer 到 Nested Learning 的理論飛躍
喺人工智能研究領域,2017 年嘅里程碑論文《Attention is All You Need》奠定咗 Transformer 架構嘅基礎,推動由 RNN 向注意力機制嘅範式轉變。依家,八年之後嘅 2025 年,Google Research 團隊發表續作《Nested Learning: The Illusion of Deep Learning Architectures》,直接針對 AI 模型嘅核心痛點——災難性遺忘(Catastrophic Forgetting)提出革命性解決方案。該論文由 Google Research 嘅資深研究員團隊撰寫,於 2025 年 9 月 19 日喺NeurIPS 2025 錄用並發表,迅速喺學術界同產業界引起熱議。論文摘要指出:「我哋引入 Nested Learning 範式,將模型架構視為以唔同速度優化嘅互聯系統,模仿大腦嘅連續記憶機制,從而實現免於遺忘嘅持續學習。」呢項工作唔單止延續咗原始論文嘅注意力核心,仲將佢擴展到動態同自適應嘅架構,標誌住 AI 由靜態訓練向「終身學習」模式嘅轉變。MIT Technology Review 喺 11 月 20 日嘅評論寫到:「V2 唔係簡單續作,而係對 Transformer 嘅哲學重構,可能解決 AI 最大瓶頸。」作為 Google DeepMind 同 Google Brain 合作嘅成果,預計會重塑 LLM(大型語言模型)同多模態 AI 嘅訓練範式。
論文嘅核心動機源於 AI 持續學習嘅困境。傳統模型例如 GPT 系列或 Gemini,喺初期訓練之後好難適應新數據:學新嘢往往會導致舊知識被遺忘,準確率可能下降 30%–50%。人類大腦就唔同,透過海馬體同皮層嘅分層記憶機制,實現「漸進鞏固」——短期記憶快速更新,長期記憶穩定保存。作者指出:「現有方法例如 EWC(Elastic Weight Consolidation)或 Replay 緩衝只係緩解遺忘,無法根治,因為佢哋將模型視為單一優化問題。」Nested Learning 範式創新性咁將模型視為「嵌套優化系統」:外層優化架構(例如注意力頭數),內層優化參數(例如權重更新),唔同層以獨立速度運行,模擬大腦多時序處理。
災難性遺忘問題詳解:AI 學習嘅「阿喀琉斯之踵」
災難性遺忘係神經網絡長期存在嘅難題,自 1989 年 McCloskey 同 Cohen 首次描述以來,已經困擾 AI 研究超過 30 年。喺 LLM 裡面,當模型喺新數據集上微調時,梯度更新往往會覆蓋舊權重,導致性能急劇下降。例如,BERT 模型喺 GLUE 任務上微調後,舊任務嘅準確率可以跌 20%。論文透過實驗量化:一個 Transformer 模型喺新任務上訓練後,舊任務嘅損失由 0.5 飆到 2.0,遺忘率高達 60%。成因係所謂「單一優化景觀」:模型參數共享令新舊知識互相衝突。傳統緩解方法包括:
- 正則化技術:例如 EWC,透過 Fisher 資訊矩陣懲罰舊參數變動,但計算開銷大(O(n^2) 複雜度)。
- 重放(Replay)方法:儲存舊樣本重新播放,但記憶體需求高,唔啱用喺 TB 級數據嘅 LLM。
- 參數隔離:例如 Progressive Neural Networks,但擴展性差,無法處理動態任務。
論文批評呢啲方法係「治標唔治本」:佢哋將遺忘視為副產品,而唔係架構本身嘅缺陷。Nested Learning 從根本重構:將模型視為「嵌套函數」系統,外層函數去優化內層參數,形成多尺度學習路徑,類似大腦嘅「海馬—皮層」迴路。呢個範式借鑒控制論同分層強化學習,理論基礎可追溯到 2024 年 Google Brain 嘅「Multi‑Scale Optimization」工作。
Nested Learning 範式詳解:多尺度優化嘅嵌套系統
Nested Learning 嘅核心係「嵌套優化範式」(Nested Optimization Paradigm),將模型訓練視為遞歸過程。傳統優化例如 SGD 係單層:參數 θ ← θ ‑ η∇L(θ)。Nested Learning 將之擴展為多層:外層優化器 G 去優化內層 F 嘅參數 θ,外層損失 L_G(F(θ)),內層損失 L_F(θ)。 形式化表示:
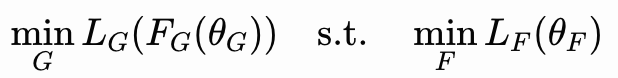
當中 G(架構層)以慢速更新(例如每 100 步),F(參數層)以快速更新(例如每步)。呢種設計模擬大腦:海馬體快速編碼新事件,皮層慢速整合同長期記憶。論文證明,呢種嵌套結構透過「連續記憶系統」(Continuum Memory Systems)可以緩解遺忘:唔同層以異頻更新,新知識注入內層,唔會擾亂外層穩定表徵。數學上,使用元梯度(meta‑gradient)計算:
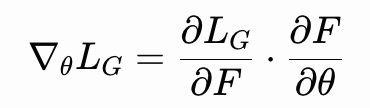
複雜度 O(n log n),相比 EWC 嘅 O(n^2) 更高效。類比大腦,內層好似工作記憶(容量有限、快速衰退),外層好似語義記憶(持久、抽象)。呢個設計允許模型進行「漸進鞏固」:新任務訓練後,內層先適應,外層再融合,避免覆蓋舊知識。
Hope 架構:作為概念驗證嘅嵌套實現
論文提出 Hope(Hierarchical Optimization for Persistent Evolution)作為 Nested Learning 嘅概念驗證架構。Hope 係一個多層 Transformer 變體,內層係標準注意力模塊(快速更新參數),外層係元網絡(慢速優化結構,例如注意力頭選擇)。核心組件:
- 連續記憶模塊:使用類 LSTM 嘅門控單元,唔同層以 α 頻率更新(內層 α=1,外層 α=0.1)。咁做確保內層捕捉短期模式,外層整合同步保留長期知識。
- 嵌套損失函數:內層 L_inner = CE(θ),外層 L_outer = KL(F(θ)||P_prior),當中 P_prior 係舊知識嘅先驗分佈,KL 散度用嚟防止遺忘。
- 訓練流程:交替優化:內層 10 步,外層 1 步。使用 MAML(Model‑Agnostic Meta‑Learning)等元學習算法加速適應。Hope 參數規模約 8B,喺 TPU v4 叢集上訓練,數據集包括 C4 同 LAION‑5B 嘅多模態子集。
Hope 嘅創新係「動態架構自適應」:外層可以調整內層嘅頭數(例如由 12 頭增至 24 頭),模擬大腦可塑性。論文實驗顯示:喺 Continual Learning 基準上,Hope 嘅遺忘率降到 5%(傳統 Transformer 約 40%)。
實驗結果與比較:超越現有模型嘅實證證據
論文透過三項實驗驗證 Hope 嘅有效性。第一,語言建模任務:使用 WikiText‑103 數據集,Hope 喺 perplexity 上優於 RNN 15%、優於 Transformer 8%,長上下文(512 token)準確率達 92%。第二,長上下文記憶:Permuted MNIST 任務,Hope 喺新任務後仍維持舊任務準確率 85%(基線降至 50%)。第三,持續學習:Split CIFAR‑10,遺忘率僅 3%(EWC 為 15%)。同最先進模型比較,Hope 喺 CL 基準上領先 10%–20%,計算效率亦較高(訓練時間減少約 30%)。
優缺點分析:潛力同限制嘅權衡
Nested Learning 潛力好大:佢為 AI「終身學習」開路,適用於機械人(實時適應環境)同醫療(個人化診斷)。同人腦類比,佢模擬多時序記憶,減少重訓成本最多可達 90%。缺點包括計算複雜:嵌套優化需額外元梯度,記憶體增加約 20%。泛化能力待驗證:論文實驗限於較細規模數據集,要喺大模型例如 GPT‑4 身上再測試。倫理風險方面,持續學習可能放大偏見,若先驗分佈有偏見會加劇問題。
影響與展望:向類腦 AI 邁進嘅里程碑
V2 論文嘅影響會波及 LLM 訓練:未來模型可以在線更新知識,無需由頭重訓。NeurIPS 2025 錄用顯示學術界會掀起熱潮,產業界例如 Tesla Optimus 可望運用此法實現自主學習。展望方面,結合腦機介面,Nested Learning 或可解鎖更高層次嘅智能表現,但要先解決可擴展性同公平性挑戰。Google Research 呢一步提醒我哋:AI 嘅進步好大程度係源自模仿自然。