
2024年底,獨立研究員 Keller Jordan 提出咗一款新型神經網絡優化器——Muon(全名 MomentUm Orthogonalized by Newton‑Schulz)。呢款優化器專為神經網絡入面嘅二維權重矩陣(hidden layers 嘅 weight matrices)設計,透過將 Nesterov 動量同 Newton‑Schulz 正交化迭代結合,實現對權重矩陣幾何結構嘅精準優化。2025–2026 年間,Muon 喺 AI 社群迅速流行,尤其喺安德烈·卡帕西(Andrej Karpathy)嘅 nanoGPT、nanochat、autoresearch 等極簡項目廣泛採用,成為現時「速度紀錄」(speedrun)訓練方案嘅核心組件。PyTorch 2.11 已經將佢正式收錄入 torch.optim.Muon,標誌住呢款優化器踏入主流框架。
Muon 出現嘅背景係傳統優化器(例如 AdamW)喺處理大型 Transformer 模型時存在嘅結構性缺陷。AdamW 等優化器通常會將權重矩陣視為一堆獨立嘅標量做元素級更新,忽略咗矩陣作為一個幾何對象嘅內在結構,導致梯度喺唔同方向上互相干擾較大。Muon 則係把權重矩陣當成整體去優化,透過先做動量更新、再立即正交化,令更新方向保持較好嘅幾何性質,從而提升訓練穩定性同收斂速度。
Muon 嘅 PyTorch 實現代碼同核心機制解析
Muon 嘅官方實現好簡潔高效。Keller Jordan 嘅 GitHub 倉庫(https://github.com/KellerJordan/Muon)提供完整代碼,PyTorch 官方亦已集成。核心思想係「先動量更新,然後正交化」。
以下係簡化後嘅核心實現(基於官方代碼,PyTorch 風格):
Python
import torch
from torch.optim import Optimizer
def newtonschulz5(G, steps=5, eps=1e-7):
    """Newton‑Schulz 迭代實現矩陣正交化"""
    assert G.ndim == 2
    a, b, c = (3.4445, -4.7750, 2.0315)  # Keller Jordan 優選多項式係數
    X = G.bfloat16()
    X = X / (X.norm() + eps)
    if G.size(0) > G.size(1):
        X = X.T
    for _ in range(steps):
        A = X @ X.T
        B = b * A + c * A @ A
        X = a * X + B @ X
    if G.size(0) > G.size(1):
        X = X.T
    return X
class Muon(Optimizer):
    def __init__(self, params, lr=0.1, momentum=0.95, nesterov=True, steps=5):
        defaults = dict(lr=lr, momentum=momentum, nesterov=nesterov, steps=steps)
        super().__init__(params, defaults)
@torch.no_grad()
    def step(self, closure=None):
        loss = None
        if closure is not None:
            loss = closure()
for group in self.param_groups:
            for p in group['params']:
                if p.grad is None:
                    continue
                g = p.grad
                if g.ndim != 2:  # 只對 2D 權重矩陣應用 Muon
                    continue
                state = self.state[p]
                if len(state) == 0:
                    state['momentum'] = torch.zeros_like(g)
# Nesterov 動量更新
                state['momentum'].mul_(group['momentum']).add_(g, alpha=1 - group['momentum'])
                g = state['momentum'] if group['nesterov'] else g
# Newton‑Schulz 正交化
                g_ortho = newtonschulz5(g, steps=group['steps'])
# 應用更新
                p.data.add_(g_ortho, alpha=-group['lr'])
return loss
關鍵解析:
- Newton‑Schulz 迭代:透過 5 次迭代快速將更新矩陣逼近正交矩陣(operator norm 接近 1),避免梯度爆炸或消失。
- 混合使用:實際項目入面通常採用 Muon + AdamW 混合策略——對二維權重矩陣(attention 同 FFN 層)用 Muon,對 bias、embedding 等一維參數用 AdamW。
- 超參數:學習率通常設喺 0.1 左右(遠高於 AdamW 嘅 0.001),動量 0.95,Newton‑Schulz 步數 5 步已經可以收斂。
Muon 同 AdamW 嘅詳細對比
AdamW 係目前 LLM 訓練嘅事實標準優化器,核心係元素級自適應學習率(基於梯度一階同二階矩)。Muon 則係一種矩陣感知(matrix‑aware)優化器,兩者喺以下維度形成鮮明對比:
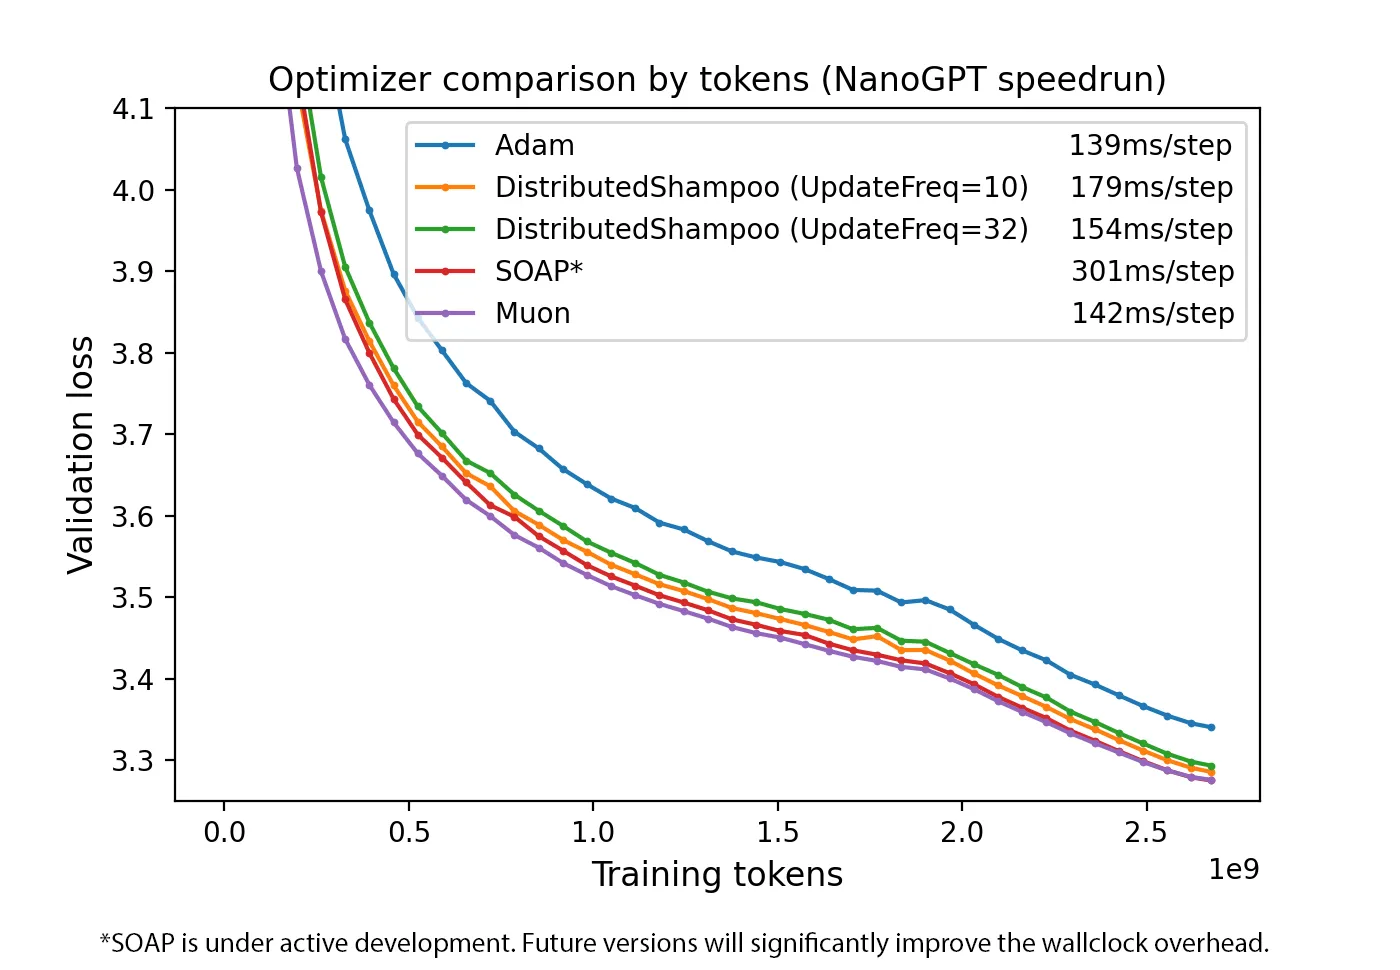
圖 1. 按樣本效率嘅優化器比較。[可重現日誌]
1、優化對象:
- AdamW:將權重視為一堆獨立標量,元素級更新。
- Muon:把 2D 權重矩陣視為幾何整體,先動量更新再正交化。
2、收斂速度:
- 實驗顯示,Muon 喺 nanoGPT、CIFAR‑10 speedrun 等任務中可將訓練速度提升 1.35x~2x。
- 喺 LLM 訓練中,Muon + AdamW 混合方案通常可以用更少步數達到相同 loss,部分場景下節省約 50% 計算成本。
3、記憶體佔用:
- Muon 只維護一個動量狀態,記憶體開銷比 AdamW 低約 33%。
- 混合方案喺保持性能嘅同時,進一步降低峰值記憶體。
4、穩定性與泛化:
- Muon 透過正交化減少咗譜偏差(spectral bias),令更新更均勻,尤其喺重尾分佈(heavy‑tailed)任務中表現更好。
- AdamW 喺長時間訓練中容易出現梯度尖峰,而 Muon 嘅更新較為平滑。
5、適用範圍:
- AdamW 通用性強,適合所有參數。
- Muon 專為 2D 權重設計,與 AdamW 混合使用效果最佳(embedding/bias 用 AdamW,hidden weights 用 Muon)。
喺具體項目入面嘅使用方式
1、Karpathy 嘅 autoresearch 項目:
- 喺 train.py 入面,Muon 被用作預設優化器之一。
- 使用者可以自主修改優化器配置(Muon 或 AdamW),喺固定 5 分鐘預算內運行實驗,透過 val_bpb 指標判斷改善效果。
- 典型代碼片段:
Python
from muon import Muon
optimizer = Muon(model.parameters(), lr=0.1, momentum=0.95)
2、nanoGPT / nanochat:
- 喺 Karpathy 嘅極簡 GPT 訓練項目中,Muon + AdamW 混合優化器幫助打破多項速度紀錄。
- 通常對 QKV 同 FFN 權重矩陣單獨應用 Muon,對 embedding 同 bias 使用 AdamW。
3、大規模 LLM 訓練:
- Moonshot、Kimi 等團隊已經喺千億參數模型中驗證 Muon 嘅可擴展性。
- 混合方案已成為當前最優實踐:Muon 負責隱藏層幾何優化,AdamW 負責其餘參數嘅自適應調整。
實際效果與社群反饋
喺 nanoGPT speedrun 中,轉用 Muon 後訓練速度提升約 35%。喺 CIFAR‑10 等基準上,Muon 亦展現出顯著優勢。社群普遍認為,Muon 係自 Adam 以來優化器領域最重要嘅創新之一,尤其適合 Transformer 架構嘅 LLM 訓練。
總結與展望
Muon 優化器以其矩陣感知設計同高效正交化機制,為 LLM 訓練提供咗一個新選擇。佢唔係要完全取代 AdamW,而係同佢形成高效互補。透過喺 Karpathy 等極簡項目嘅落地,Muon 已證明咗喺實際訓練中嘅價值。隨住 PyTorch 官方集成同更多大規模驗證,Muon 有望成為下一代 AI 訓練嘅標準組件之一。
由元素級優化到矩陣級幾何優化,Muon 代表住優化器由「通用」向「結構感知」演進嘅方向。喺 AI 訓練成本居高唔下嘅今日,呢項創新唔單止加速研究迭代,亦為更高效、更綠色嘅 AI 基礎設施打好基礎。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請瀏覽:
https://www.airosetta.com