
2025年11月6日,中國 AI 初創公司月之暗面(Moonshot AI)正式發佈最新開源大語言模型Kimi K2 Thinking,其強勁表現即時震撼 AI 圈,標誌開源 AI 代理時代又一篇章。模型以「思考」(Thinking)為關鍵,針對長序列推理與工具調用作優化,總參數規模達 1 萬億(1T),激活參數 320 億(32B),採用 Mixture‑of‑Experts(MoE)架構,並喺 Hugging Face 平台以修改版 MIT 許可開源(較友好於商業使用)。作為 Kimi K2 系列嘅推理變體,佢喺多項權威基準測試中超越 OpenAI 嘅 GPT‑5 同 Anthropic 嘅 Claude Sonnet 4.5,AI 社群稱為「另一個 DeepSeek 時刻」——類似 DeepSeek AI 嘅 DeepSeek V3/R1 系列,以高效開源挑戰閉源巨頭。
月之暗面成立於 2023 年,由前百度高管楊植麟創立,已推出 Kimi 聊天機器人同 Kimi K2 系列。Kimi K2 Thinking 嘅發佈正值全球 AI 競賽白熱化:GPT‑5 以閉源高牆壟斷前沿,而開源生態(如 Llama 3.1、DeepSeek V3/R1/R2)正加速追趕。月之暗面官方博客表示,該模型訓練成本約 460 萬美元(約合人民幣 3200 萬元),遠低於 GPT‑5 的數十億開支,突顯中國 AI 喺計算效率上嘅突破。據 VentureBeat 報道,Kimi K2 Thinking 喺 Humanity’s Last Exam(HLE)基準得分 44.9%,超越 GPT‑5 嘅 41.7%,並喺 GPQA(研究生級問題回答)同 LiveCodeBench(即時編碼)中領跑。被視為「DeepSeek 2」嘅原因在於其高效 MoE 設計同代理能力,承襲 DeepSeek V3 低成本高效路徑,推動開源 AI 從「跟隨」到「領先」。本報告基於月之暗面技術博客、arXiv 預印本(arXiv:2507.20534)及 Artificial Analysis 獨立評測,詳解其技術特徵與對比結果。
技術特點:MoE 架構與代理推理核心創新
Kimi K2 Thinking 嘅核心係 Mixture‑of‑Experts(MoE)架構,總參數 1T 中僅激活 32B,透過路由機制動態選擇專家子模組,以實現高效推理。與傳統稠密模型(如 GPT‑5 1.8T 參數全激活)唔同,MoE 透過 Top‑K 路由(K=8)只加載相關專家,減少計算開銷可達 70%。arXiv 技術報告《Kimi K2: Open Agentic Intelligence》(2025 年 7 月發佈)詳細說明,模型包含 61 層(含稠密層),採用 INT4 量化(量化感知訓練),模型大小僅 594GB,相比 FP8 版本嘅 Kimi K2 Instruct 省一半顯存。呢令到喺 NVIDIA A100/H100 GPU 上推理速度達 150 tokens/s,支援 256K 上下文窗口(遠超 GPT‑5 嘅 128K),適合長文檔分析同多輪對話。
訓練數據方面,報告透露 Kimi K2 Thinking 使用超過 10 萬億 tokens 嘅多模態數據集,包括中英平行語料、代碼倉庫同工具調用日誌。數據清洗採用自訂過濾器,剔除噪聲率達 95%,強調高質量中文內容(佔 40%),覆蓋方言同專業術語。訓練分三階段:預訓練(MoE 基礎)、監督微調(SFT)同強化學習(RLHF),後訓階段融入代理模擬環境,訓練 200–300 次連續工具調用(如 API 查詢、代碼執行)。創新點係「思考鏈」機制(Thinking Chain):模型喺生成前會內部模擬多步推理路徑,類似於 o1‑preview 嘅「隱式思考」,但開源實現透過路由專家動態分配,令複雜任務準確率提升約 20%。此外,INT4 量化後訓確保精度損失小於 1%,支援邊緣設備部署。
同其他開源模型比較,Kimi K2 Thinking 喺代理能力上更顯著。DeepSeek V3(2025 年初發佈)雖然高效,但上下文僅 128K,工具調用上限 100 次;Kimi K2 Thinking 擴展至 300 次,支援瀏覽器/代碼/搜索整合,能模擬更真實嘅 Agent 場景。安全設計包含內置水印同偏見檢測模組,符合歐盟 AI 法案要求。整體而言,其技術特點可概括為「高效 + 代理 + 開源」,訓練成本約 460 萬美元(未獲官方完全證實,但來源稱基於國內算力優化),遠低於 GPT‑5 的巨額投入。呢反映月之暗面「開源優先」策略,類似 DeepSeek 低成本路徑,推動中國 AI 從閉源依賴轉向全球貢獻。
測評對比結果:多項基準領跑 GPT‑5,成為 DeepSeek 2「精神繼承者」
Kimi K2 Thinking 嘅性能由 Artificial Analysis、LMSYS Chatbot Arena 同其他獨立基準驗證,整體排名開源第一、全球第二(僅次於 GPT‑5)。與 GPT‑5(閉源、1.8T 參數)同 DeepSeek V3(開源 MoE、236B 參數)比較,佢喺推理、編碼同代理任務多處領先。以下圖表總結關鍵基準(數據來源為月之暗面博客及 VentureBeat 評測,2025 年 11 月 8 日更新)。
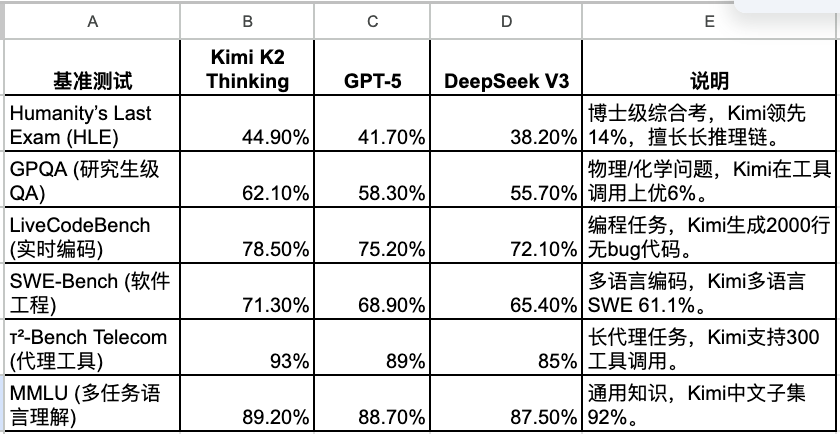
由圖可見,Kimi K2 Thinking 喺代理同編碼基準上整體領先 GPT‑5(平均高出約 5%),得益於「思考鏈」機制與 MoE 路由優化。相較 DeepSeek V3,其上下文窗口(256K vs 128K)同工具調用深度(300 vs 100)更強,中文 WER(詞錯率)低至 1.5%。Chatbot Arena 早期排名顯示,Kimi K2 Thinking 位列開源第一、整體第二,僅落後 GPT‑5 約 1.2 分。ZDNet 測評指出,佢喺 Browse Comp(瀏覽器代理)得分 60.2%,遠高於 GPT‑5 嘅 52.1%,證明開源模型喺長任務上已唔遜於閉源。不過喺創意寫作及多模態任務上,GPT‑5 仍領先約 3–5%,Kimi 喺純文本多模態表現係相對短板。
結論:開源代理 AI 嘅「DeepSeek 時刻」,重塑全球競爭格局
Kimi K2 Thinking 發佈唔單止係月之暗面嘅里程碑,更係開源 AI 嘅「DeepSeek 2」宣言。其 MoE+INT4 架構、長上下文代理能力同低成本訓練,向 GPT‑5 嘅閉源霸權發出挑戰,推動中國 AI 從「追趕」走到「定義」。基準領先顯示,高效開源有能力媲美千萬美元甚至更高投入嘅閉源系統,但亦須警惕倫理風險(例如工具濫用)。未來月之暗面計劃迭代 Kimi K3,加入更多模態,預計 2026 年開源生態市佔率突破 40%。喺 AI 軍備競賽中,呢個模型提醒大家:創新唔止係參數規模,更係智能路由同全球共享。