
2026年3月16日,Moonshot AI(月之暗面)旗下Kimi團隊喺GitHub正式開源《Attention Residuals》(注意力殘差,簡稱AttnRes)嘅技術報告同代碼倉庫。呢項創新喺業界被快手形容為「將注意力旋轉90度」嘅突破性設計:佢徹底重構咗Transformer架構入面最基礎但長期被忽視嘅殘差連接(Residual Connection),將傳統「簡單相加」升級為「深度注意力選擇性聚合」。實驗數據顯示,喺相同計算量下,AttnRes可實現1.25倍計算優勢(相當於慳約20%算力就可達到基準性能),喺MMLU、GPQA‑Diamond等關鍵基準上都有顯著提升。呢項成果唔單止直接應用喺Kimi Linear系列模型,仲被OpenAI前研究員Jerry Tworek稱為「深度學習2.0」時代嘅開端。
殘差連接嘅先天難題:由ResNet到Transformer嘅共同痛點
殘差連接最早由ResNet(2015年何恺明團隊提出)引入CNN,用來解決深層網絡嘅梯度消失問題,公式簡潔為 y = x + f(x)。Transformer延續咗呢個設計,但喺百億甚至萬億參數規模下暴露出致命缺陷:信息稀釋同隱藏狀態爆炸。
傳統殘差係「無條件累加」——每一層平均疊加前一層輸出。隨住深度增加(L層),淺層特徵會被後期層「稀釋」,早期關鍵信息(例如長序列中嘅關鍵 token)逐步被淹沒。同時,為咗維持訊號強度,模型不得不提升隱藏狀態嘅激活值,導致訓練唔穩定、記憶體開銷暴增。呢啲正係深層MoE模型(例如Kimi Linear、DeepSeek‑V3風格)喺長上下文、複雜推理任務入面表現受限嘅核心原因。
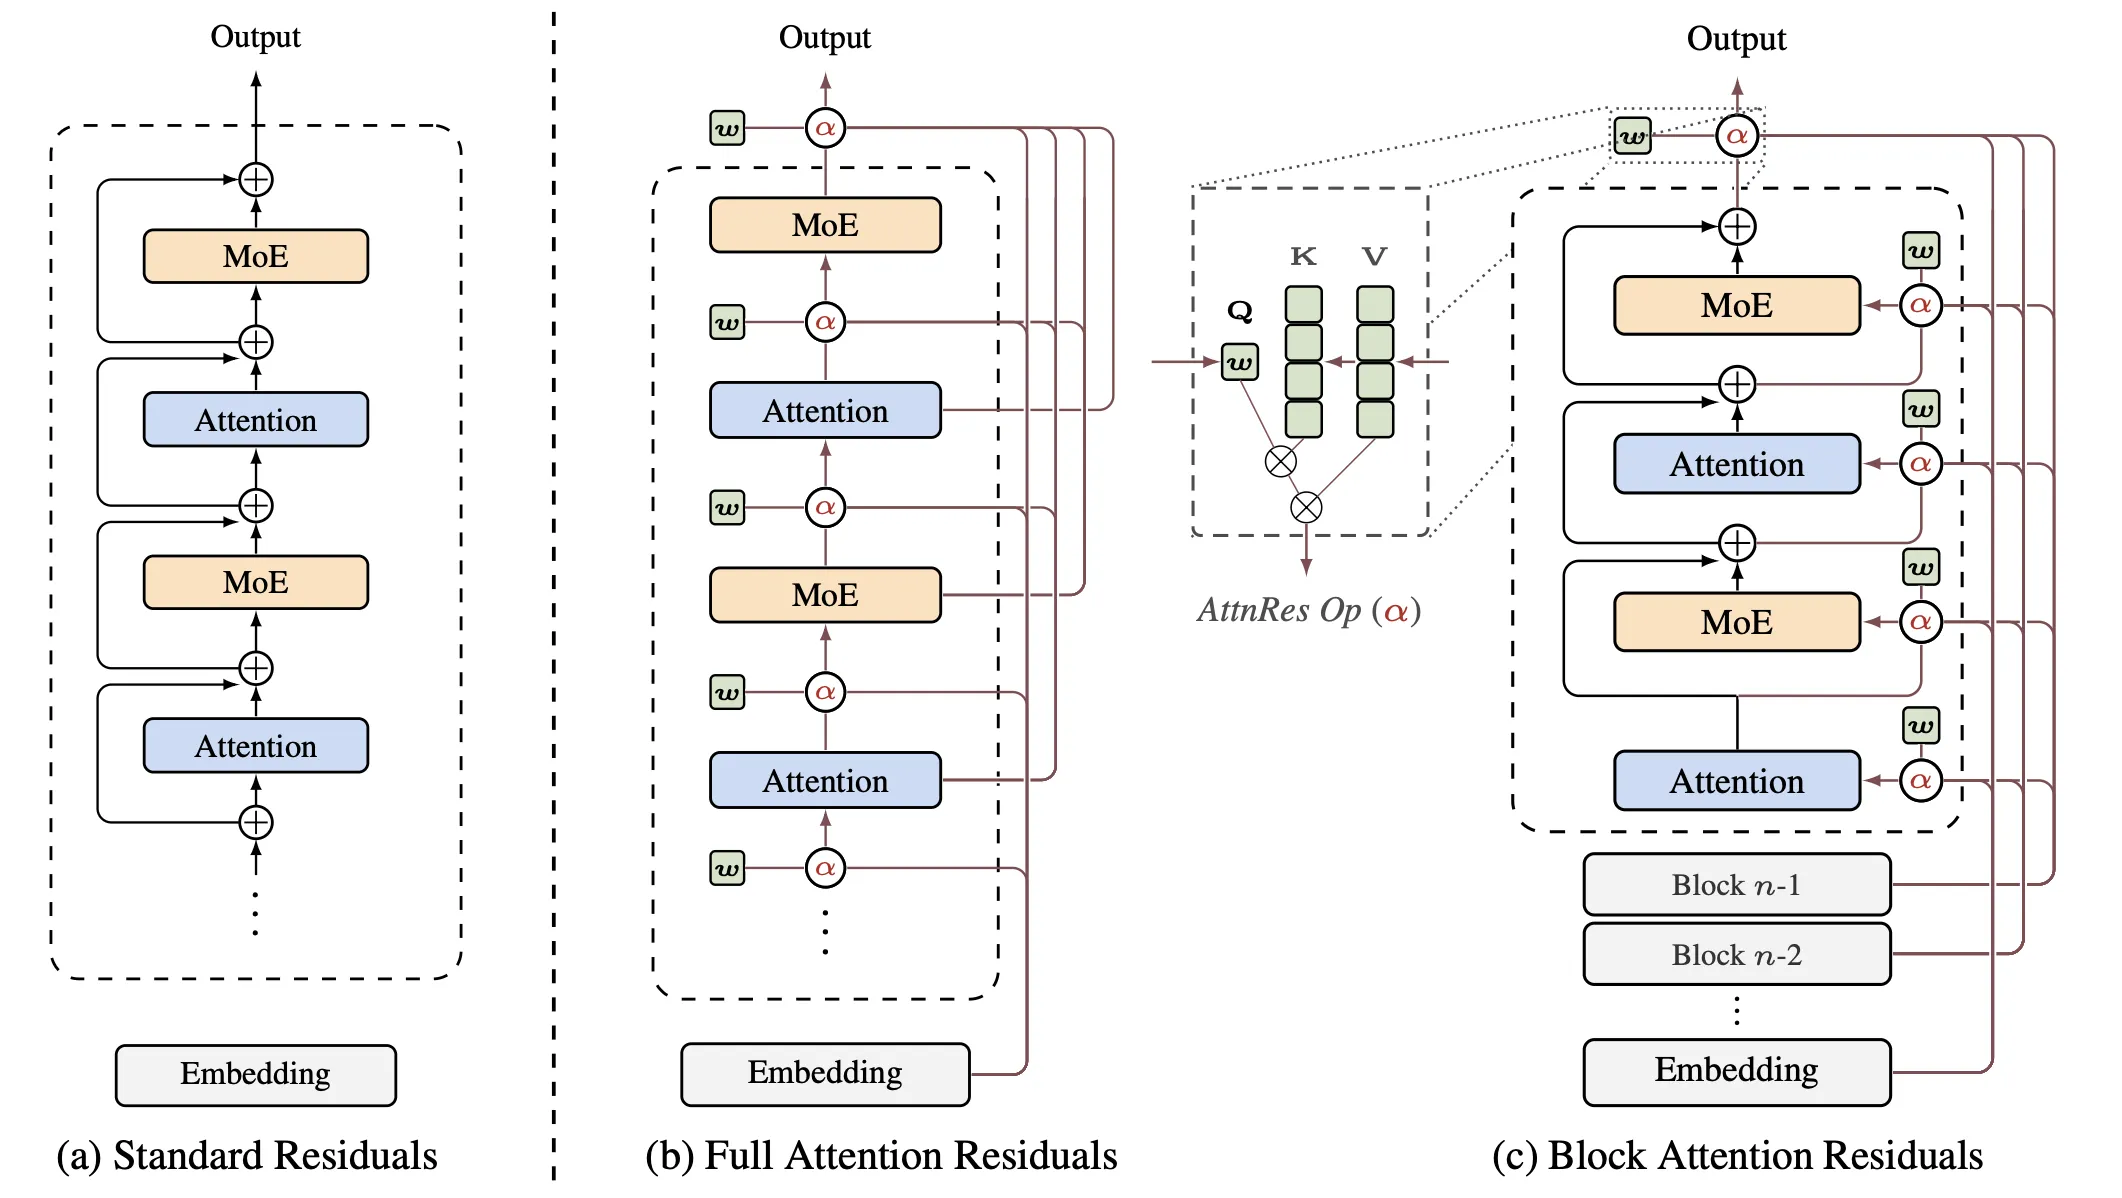
Kimi團隊嘅AttnRes徹底顛覆咗呢個機制:每一層唔再盲目相加,而係發射一個可學習嘅Query,對所有先前層嘅Key做注意力匹配,透過Softmax權重動態揀選並聚合「有用」嘅歷史表示。論文形象咁形容為「將注意力機制旋轉90度」——原本注意力係序列維度(時間),而家擴展到深度維度(層級)。咁樣第50層可以直接用0.8嘅權重關注第2層,而唔係經過層層衰減先傳開去。
技術核心:AttnRes同Block AttnRes嘅雙重設計
AttnRes嘅核心係「輸入依賴嘅深度注意力聚合」:
- 每層產生Query,與之前所有層嘅Key計算注意力。
- Softmax權重決定聚合比例,實現「智能過濾」。
- 完全兼容現有Transformer/MoE框架,可作為drop‑in替換,唔需要改動其他組件。
為咗解決全注意力帶嚟嘅記憶體複雜度 O(L·d)(L為層數,d為維度),團隊提出咗Block AttnRes:將模型分成 N≈8 個塊,每塊內部使用 AttnRes,塊與塊之間保留傳統殘差。實驗證明,N=8 已可捕捉到超過95%嘅增益,記憶體複雜度降到 O(N·d),推理延遲增加唔到2%。
呢個設計喺Kimi Linear(混合專家MoE Transformer,激活參數規模3B–48B)上驗證:訓練1T token之後,AttnRes變體嘅驗證損失曲線全程低過基準,梯度分佈更均勻,隱藏狀態增長被「周期性」而唔係「單調爆炸」控制。
實測數據:1.25倍計算槓桿同全面性能躍升
論文喺5種唔同規模模型上對比三種變體(PreNorm基準、Full AttnRes、Block AttnRes):
- 計算效率:喺5.6 PFLOP/s‑days計算量下,Block AttnRes損失1.692(基準1.714),擬合曲線顯示1.25倍計算優勢。達到相同性能,AttnRes只需約80%算力。
- 基準提升(相同計算預算):
- MMLU:+1.1
- TriviaQA:+1.9
- GPQA‑Diamond(高難度科學推理):+7.5
- Minerva Math:+3.6
- HumanEval(代碼生成):+3.1
- 長序列同多步推理任務表現尤其突出,證明 AttnRes 有效紓緩信息稀釋。
隨住模型規模增大,Full 同 Block 變體差距收窄,Block AttnRes 成為工程上嘅最佳方案。團隊強調:「即使係上百層模型,都只需要分成8個塊,就可以得到絕大部分收益。」
開源落地與行業影響:由Kimi到全行業
Moonshot AI已將AttnRes整合到Kimi Linear系列,並開源完整代碼與論文(GitHub: MoonshotAI/Attention‑Residuals)。開發者可零成本替換現有Transformer殘差,即刻獲得效率同性能雙重提升。
呢項創新引發全球熱議:
- OpenAI前研究員Jerry Tworek喺X平台評論:「深度學習2.0嘅時代即將到嚟——我哋需要重新思考一切。」
- 社群認為 AttnRes 係「Transformer後殘差時代嘅開端」,同早前嘅Kimi Linear(線性注意力混合架構)、Mooncake KV緩存系統組成Moonshot嘅「三駕馬車」,一齊推高推理效率。
- 相比同期嘅架構創新(如DeepSeek mHC、Meta等),AttnRes 最大亮點係「極簡但普適」——唔需要改動MoE路由或注意力內核,只改殘差就有得益。
對AI訓練與推理嘅深遠意義
AttnRes直接解決深層網絡兩大頑疾,為萬億參數模型開闢新路:
- 訓練側:梯度更穩定、損失更低、算力需求更少,降低訓練成本。
- 推理側:配合Mooncake KV緩存,可進一步壓縮記憶體、提升吞吐,尤其適合長上下文嘅Agentic任務。
- 未來方向:論文暗示 AttnRes 可同線性注意力、MoE 更深入融合,或者催生「原生深度注意力」嘅新架構。
行業分析師指出,呢個標誌住中國AI團隊由「跟隨算力軍備」轉向「架構創新降維打擊」。喺2026年算力成本仍然高企嘅背景下,1.25倍效率優勢意味住用相同預算模型性能可以提升一個世代。
結語:殘差連接嘅涅槃同AI架構革命
Kimi嘅注意力殘差唔係簡單優化,而係對Transformer最基礎模塊嘅哲學級重構。佢證明:就算喺後Transformer時代,依然有被忽視嘅「低垂果實」。隨住代碼開源同Kimi模型迭代,呢項技術有望迅速普及到全行業。
Moonshot AI再次以AttnRes證明,中國AI唔單止喺參數規模上追趕,亦喺底層架構創新上領跑潮流。2026年,或許正係「深度學習2.0」由概念走向現實嘅起點。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請到訪:https://www.airosetta.com