
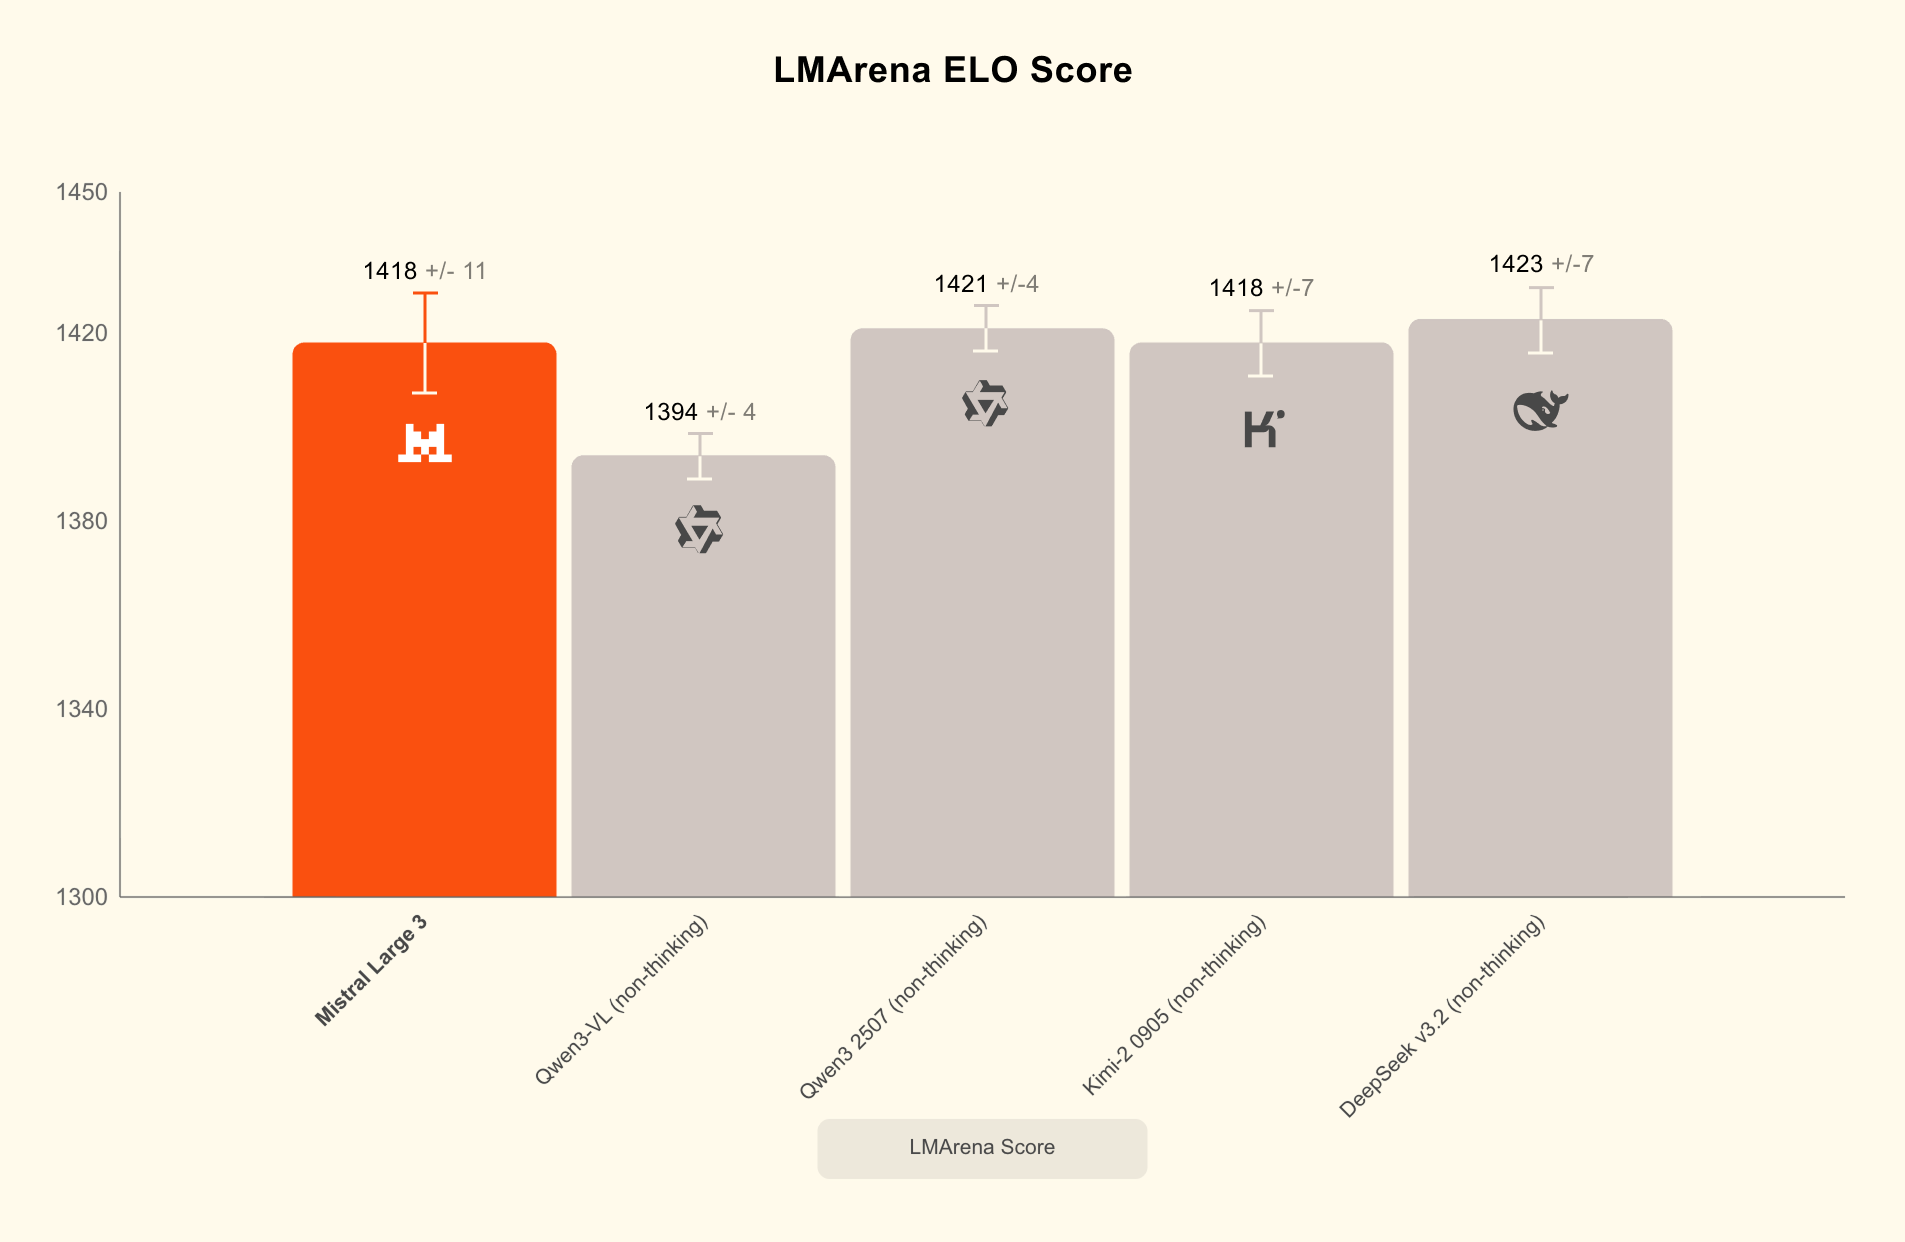
喺 2025 年底,當中美兩大語言模型巨頭發布版本更新時,法國 AI 新創 Mistral AI 於 12 月 2 日重磅推出 Mistral 3 家族。今次發佈包括旗艦 Mistral Large 3——一款總參數達 6750 億嘅稀疏混合專家(MoE)模型,仲有九款高效嘅 Ministral 3 細型模型,覆蓋 3B、8B 同 14B 參數規模。呢啲模型以 Apache 2.0 許可免費開源,支援多模態(文字+視覺)同多語言,目標係填補開源 AI 喺企業級同邊緣部署之間嘅空白。Mistral 表示,Large 3 喺 LMArena 排行榜上係開源非推理模型第 2 位(整體第 6 位),性能接近 OpenAI 嘅 GPT‑4o 同 Google 嘅 Gemini 2,但成本只係佢哋嘅 80%。呢個舉動唔單止凸顯歐洲 AI 嘅獨立野心,亦可能顛覆依賴閉源 API 嘅行業格局,引起 VentureBeat 同 CNBC 等媒體廣泛討論。
Mistral 呢一步係追求「規模與效率」。公司 2023 年成立,由前 DeepMind 同 Meta 研究員創辦,兩年內籌集 27 億美元,估值升到 137 億美元——雖然唔及 OpenAI 嘅 5000 億,但已係歐洲科網獨角獸。唔同於美國巨頭,Mistral 強調「開源優先」,避免黑箱依賴。Mistral 3 家族係呢個戰略嘅高峰:Large 3 採用細粒度 MoE 架構,總參數 6750 億、活躍參數 410 億,支援 256K 上下文窗口同視覺理解,專為文件分析、編碼、內容生成同代理工作流優化。訓練用咗 3000 張 NVIDIA H200 GPU,聚焦非英語/中文多語言數據,確保全球適用——公司話,呢樣令「數十億非英語母語者」第一次接觸前沿 AI。Ministral 3 就針對邊緣計算,提供 Base(預訓練)、Instruct(聊天優化)同 Reasoning(邏輯優化)三種變體,可喺單張 GPU、手提電腦、機械人或無人機上離線運行,上下文窗口達 128K–256K。呢啲細模型雖然初始基準落後閉源對手,但 Mistral 強調,經微調後可以喺企業場景中「匹配或超越」GPT‑4o 嘅效率。
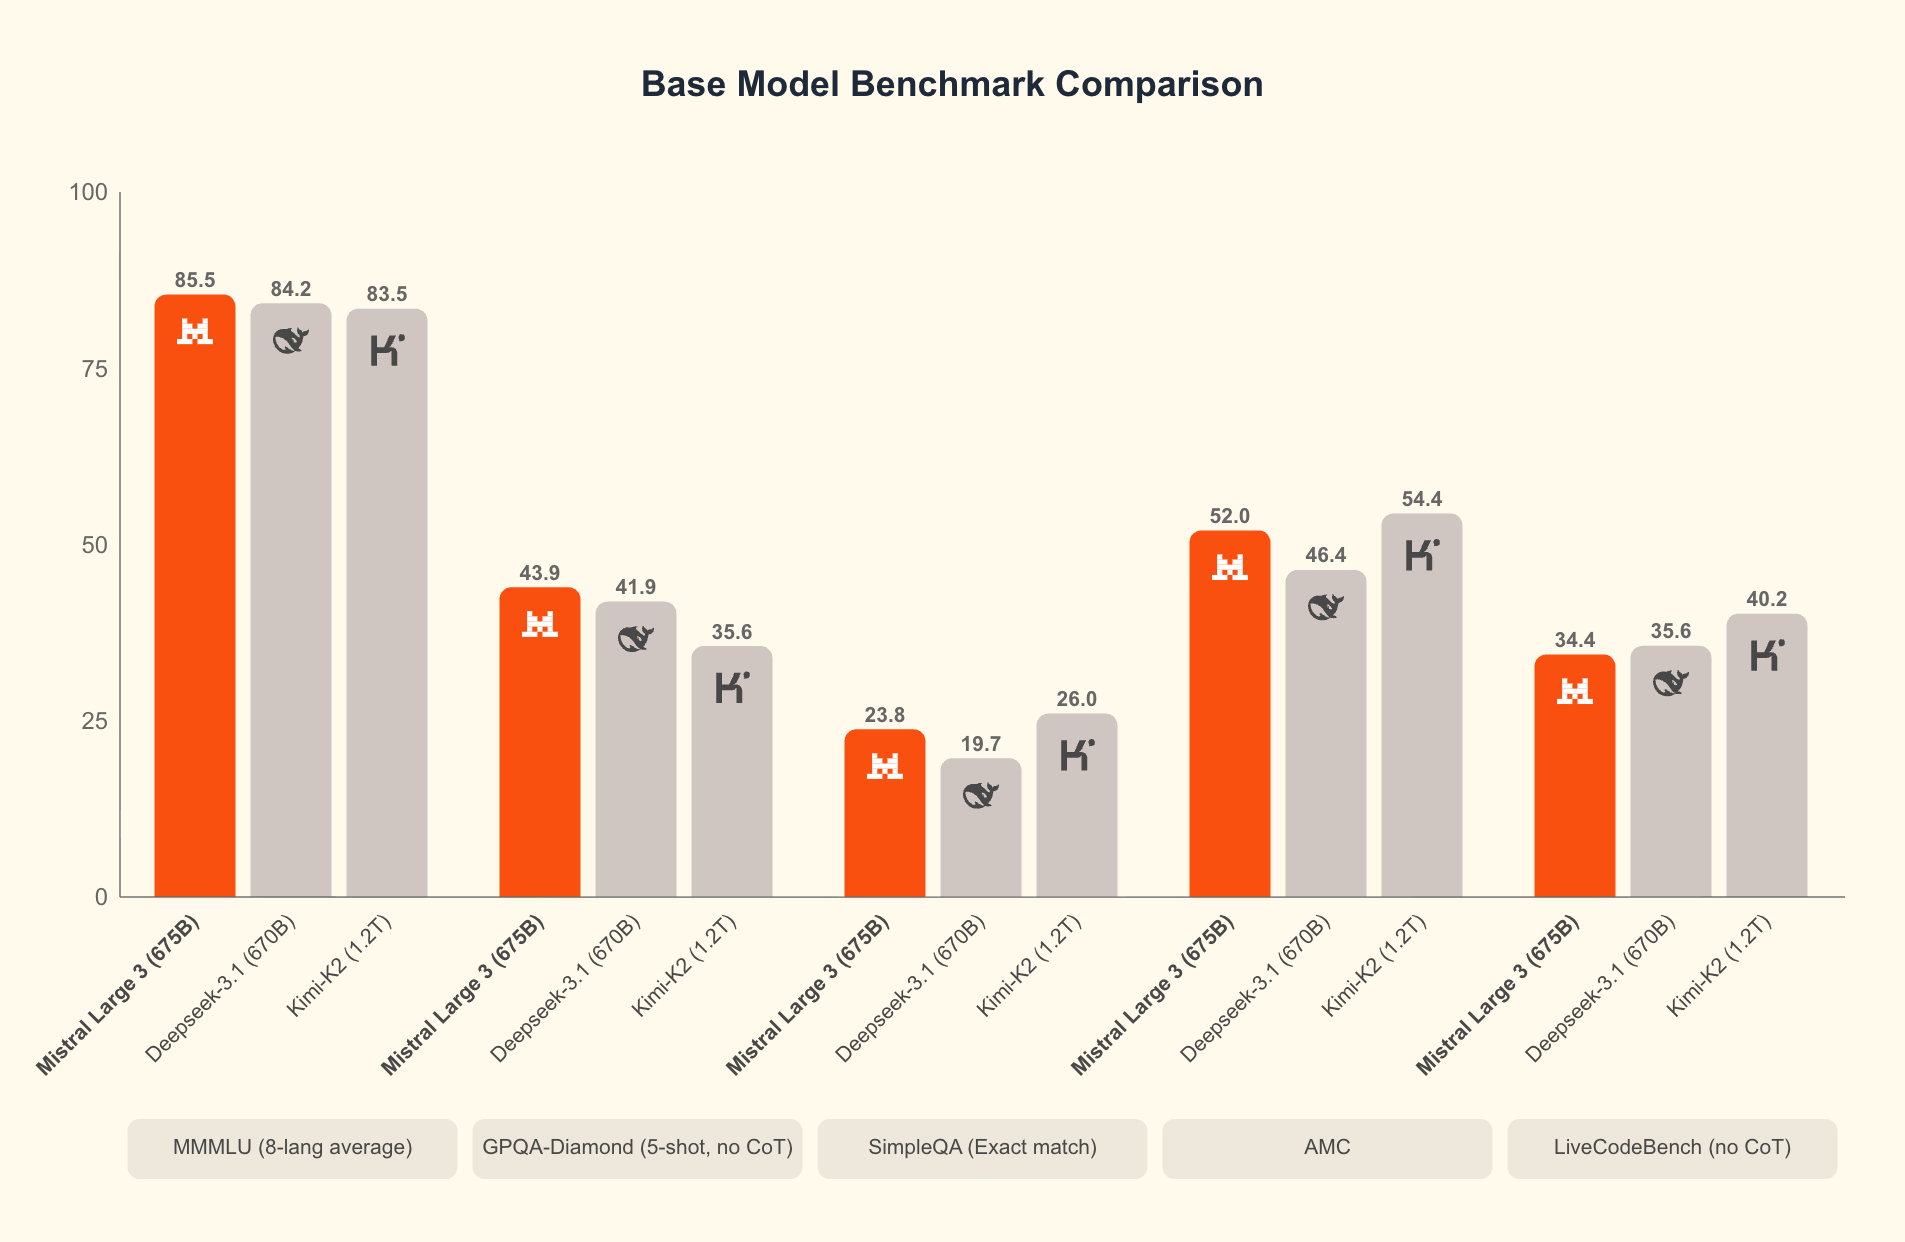
性能基準數據印證咗 Mistral 嘅雄心。官方 blog 顯示,Large 3 喺通用提示上同頂級開源指令模型不相上下,喺圖像理解同多語言對話表現突出。喺 Artificial Analysis 嘅比較中,Large 3 同 GPT‑5.1 Codex mini(高配)喺智能、價格、速度同上下文能力上交鋒,前者以更低成本勝出(輸入 0.50 美元/百萬 token,輸出 1.50 美元/百萬 token)。Medium 分析指出,Ministral 14B Reasoning 變體喺 AIME 2025 數學競賽達到 85% 正確率,領先同規模開源模型。比起 Meta 嘅 Llama 3 同阿里巴巴嘅 Qwen3‑Omni,Large 3 喺多模態整合上有優勢,而 Ministral 3 嘅 token 生成效率更高,減少約 20–30% 嘅計算開銷。GetBind 博客評估顯示,喺複雜推理同編碼負載下,Mistral 3 家族仍需更多測試,但已適合混合基礎設施嘅企業部署。Hacker News 用戶討論中有人話佢「喺實際應用中超越基準」,但亦指出喺重負載下穩定性要觀察。NVIDIA 開發者博客補充,Large 3 喺 GB200 NVL72 上優化後,性能提升 10 倍,每兆瓦處理超過 500 萬 token/秒。
今次發佈嘅技術創新唔止於規模。Mistral Large 3 引入「後訓練優化」,包括指令微調同強化學習,確保喺代理任務(例如檢索增強生成 RAG)同科學工作流上高效。Ministral 3 嘅視覺支援擴展到文件解析同圖表分析,適用於機械人(例如與新加坡 Home Team Science 合作嘅消防模型)同無人機(與 Helsing 嘅視覺‑語言‑行動整合)。CNBC 報道,Mistral 視此為「全球 AI 可用性新標準」,解鎖無網場景嘅潛力。與閉源模型嘅「API 依賴」唔同,開源權重容許開發者本地運行,避免 OpenAI 每兩星期半小時宕機嘅風險。聯合創始人兼首席科學家 Guillaume Lample 喺 TechCrunch 訪問中直言:「客戶一開始鍾意無需微調嘅大型閉源模型,但部署後發現佢哋昂貴又慢,於是轉向我哋嘅細模型——往往可以匹配甚至超越閉源表現。」佢強調,開源使命係要「確保 AI 唔會被少數大型實驗室壟斷,特別係對冇網絡用家」。
對行業而言,Mistral 3 加劇咗「開源 vs 閉源」嘅拉鋸。2025 年,開源模型由「實驗品」轉向「生產力工具」:DeepSeek V3.2 同 Llama 3 已經蠶食市場份額,但 Mistral 以歐洲視角突出多語言同私隱,避開中美數據壁壘。喺 X 平台,用户 @PaternalPath 貼文話:「開源前沿升級咗,Mistral 3 解鎖設備端智能同多語言代理。」另一則 @NowadAIs 分享:「由 3B 到 675B,支援 40+ 語言,成本低 80%。」Reddit r/LocalLLaMA 子版熱烈討論比較圖表,獲數百個讚。然而,挑戰仍然存在:Medium 指出,Large 3 喺絕對智能上仍落後 GPT‑4o 同 Claude 3.5,尤其喺複雜推理方面。VentureBeat 警告,呢次新發布需要真實世界基準驗證,以免「宣傳大過實際」。
業務影響深遠。Mistral 同 Stellantis 合作車載 AI、同 Home Team 嘅機械人項目,擴展到實體 AI。CNBC 分析話,呢個家族「為企業代理工作流同邊緣應用開啟新可能」,估計 2026 年開源市場份額超過 40%。X 用戶 @heardof_ai 總結:「開源 MoE 進入生產,代理可以喺自家基礎設施運行。」對開發者嚟講,模型已經可以喺 Hugging Face 下載,支援 vLLM、llama.cpp 同 Ollama 部署。未來,Mistral 計劃發布 Large 3 嘅專用推理變體,進一步縮窄同閉源嘅差距。
Mistral 3 面世唔單止係技術躍進,仲係開源精神嘅勝利。佢證明咗細型歐洲團隊可以以效率挑戰巨頭,令 democratize AI(普及化 AI)由口號變成現實。開發者蜂擁測試,呢個「675B 魔盒」可唔可以真係「追平」GPT‑4o?答案要喺社區評測入面搵。但無論點,AI 嘅「歐洲時刻」已經到來。
資料來源: