
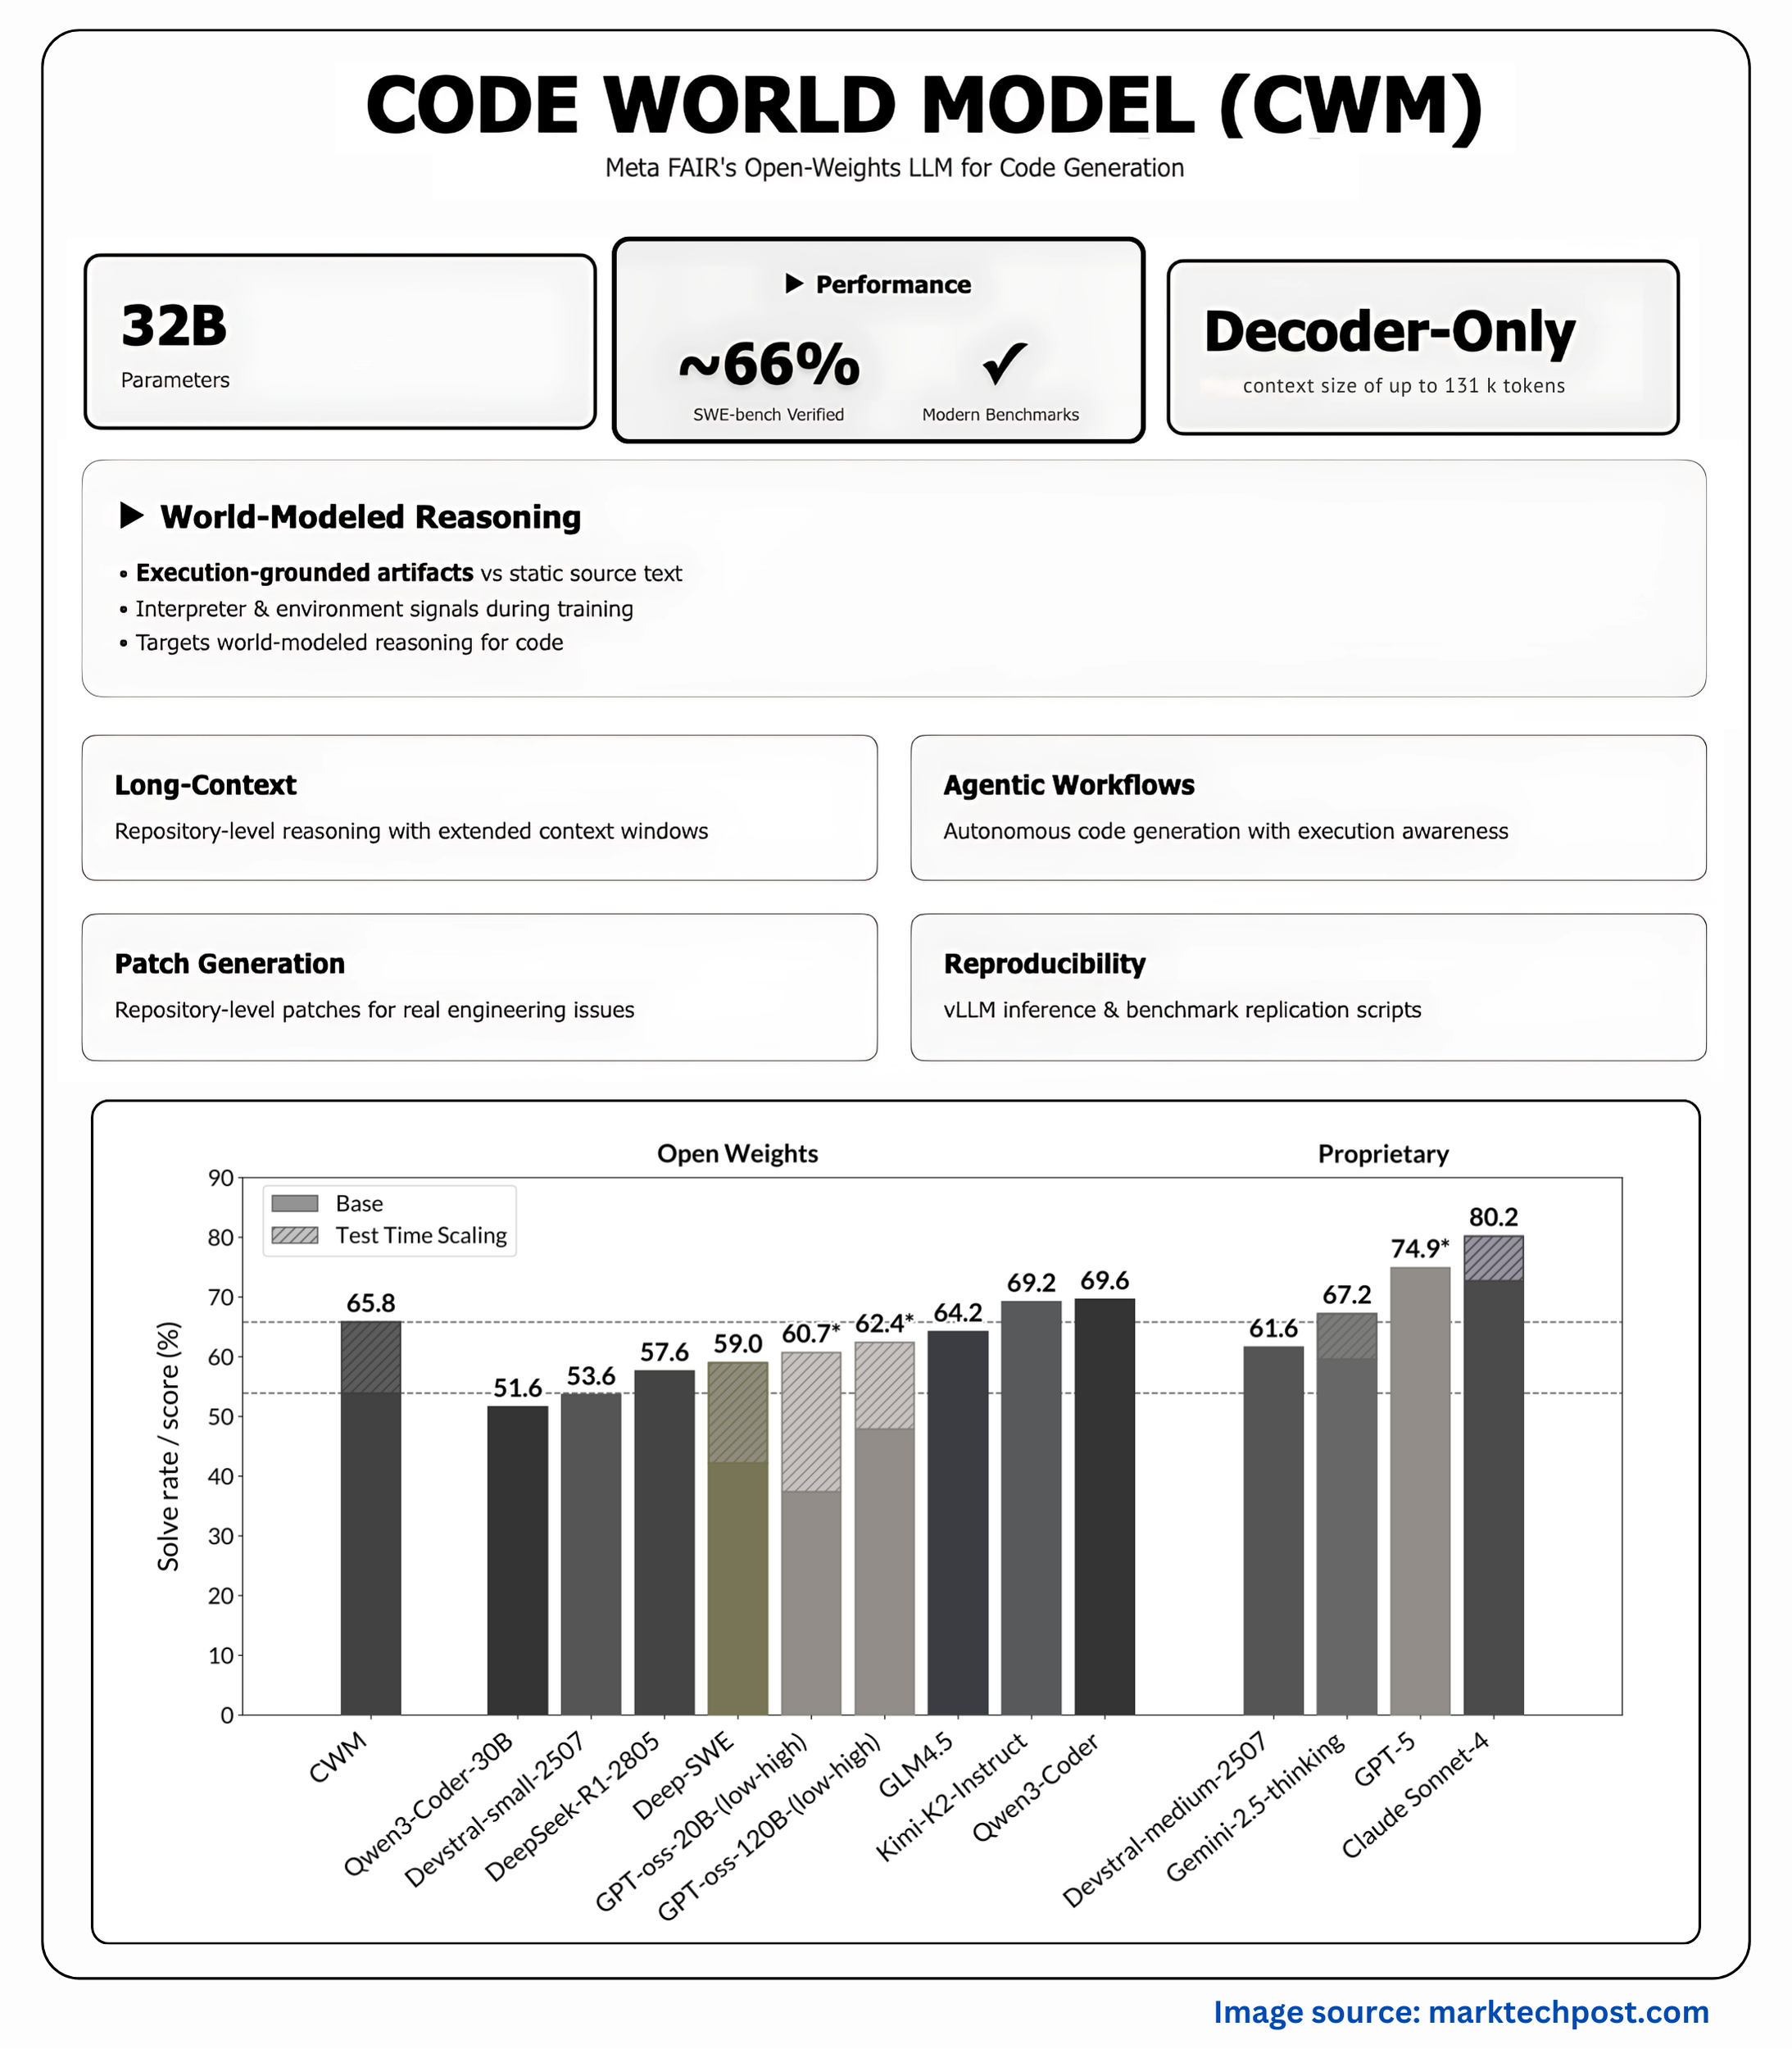
Meta AI 基礎研究實驗室 (FAIR) 於2025年9月24日正式發佈 Code World Model (CWM),一個32億參數嘅開源大型語言模型 (LLM),專為推進代碼生成中嘅世界模型 (world models) 研究而設計。呢個發佈標誌住 Meta 喺代理式編碼 (agentic coding) 領域嘅重大突破,模型透過模擬「代碼世界」環境,幫助 AI 更好規劃同執行複雜嘅編程任務。Meta 研究科學家 Gabriel Synnaeve 喺 X 平台表示:「CWM 係我哋探索世界模型喺代碼生成中潛力嘅起點,佢會加速由簡單補全向智能代理嘅轉型。」發佈包括完整權重、技術報告、模型卡同啟動代碼,全數開源於 GitHub 同 Hugging Face,採用 Meta 嘅自訂研究許可,鼓勵社群貢獻。MarkTechPost 報道稱,CWM 開源將推動全球開發者探索 AI 喺代碼規劃上嘅新範式,潛在影響由軟件開發擴展到自動化運維。
CWM 嘅發佈源於 Meta 對世界模型嘅長期研究,呢種架構靈感來自機器人學同遊戲 AI,目標係令模型可以「預演」環境動態,而唔係單純靜態生成。與傳統 LLM(例如專注序列預測嘅 Llama 3.1)唔同,CWM 整合咗模擬器,允許 AI 喺虛擬「代碼世界」中測試假設,提升代理式任務嘅魯棒性。Meta 強調,呢唔係產品級模型,而係研究工具,旨在解決代碼生成中嘅「幻覺」問題(例如生成無效代碼)。首日下載量超過10萬,Hugging Face 榜單迅速躋身前十。
技術報告深入分析:架構、訓練與效能
Meta 嘅技術報告(詳見 ai.meta.com/research/publications)詳細闡述 CWM 嘅設計同實驗。模型採用密集型 (dense) 32億參數架構,基於 Transformer 框架,但融入世界模型元件:一個「執行模擬器」(execution simulator),模擬代碼運行環境,包括變量狀態、錯誤處理同輸出預測。報告稱,呢個靈感來自 AlphaGo 嘅蒙地卡羅樹搜索 (MCTS),但應用喺代碼上:AI 喺生成前會「腦補」多條路徑,揀出最優方案。
訓練數據規模龐大:報告透露,訓練數據包括「mutate‑fix」同「issue‑fix」變體:前者模擬代碼變異修復,後者針對 GitHub issue。模型喺預訓練階段使用咗8T tokens,中期訓練又增加咗5T tokens 嘅語料,喺後訓練階段又加入咗1000億 tokens 用於 SFT 指令同推理微調,然後再用咗1720億嘅各類程式碼進行多任務強化學習(RL)。訓練分三個階段:預訓練 (pre‑training) 以代碼語料為主、監督微調 (SFT) 針對代理任務、指令調優 (instruction tuning) 結合人類反饋。創新點係「世界狀態表示」:模型用嵌入向量模擬代碼環境,據稱可減少約20%嘅計算開銷。
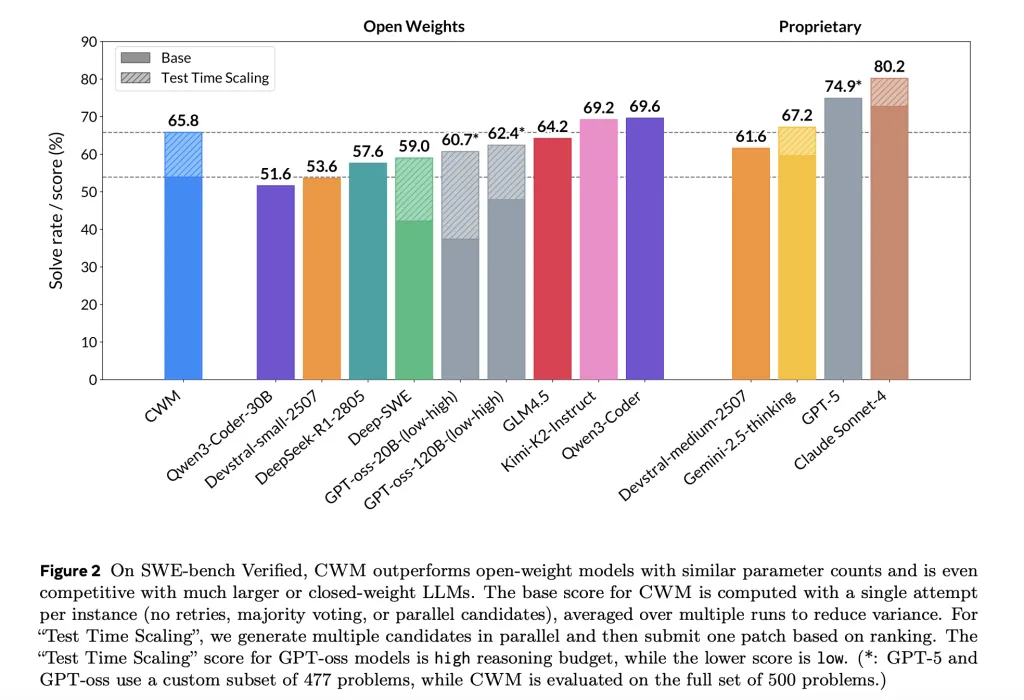
性能基準表現亮眼:HumanEval 代碼生成得分85%,接近 Claude 3.5 Sonnet 嘅87%;喺 SWE‑bench 嘅代理任務上得分42%,高於 Llama 3.1 嘅38%。報告強調,CWM 喺長鏈推理(例如多檔案除錯)方面表現優異,錯誤率下降約15%。與 Google 或 OpenAI 嘅某些模型相比,CWM 推理速度快約20%,原因係模擬器優化咗路徑搜索。局限方面:模型規模偏小(32B),處理更複雜任務可能需要更大版本;訓練數據亦偏向 Python 同 JavaScript。
報告仲討論咗倫理問題:開源許可限制軍事用途,模型卡詳細描述咗偏見測試(性別/種族中性率95%)。Meta 呼籲社群貢獻軌跡數據,推動世界模型進化。
使用方法:從安裝到應用實踐
CWM 嘅開源設計方便上手。以下步驟根據報告同 GitHub 倉庫,幫助開發者快速入門。
- 安裝與環境準備: 從 Hugging Face 下載權重(facebook/cwm):運行 pip install transformers torch。報告建議用 GPU(例如 A100),最低 16GB VRAM。代碼示例:
- python
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("facebook/cwm")
tokenizer = AutoTokenizer.from_pretrained("facebook/cwm")
```<grok-card data-id="a2a0b5" data-type="citation_card"></grok-card> 克隆 GitHub 倉庫(facebookresearch/cwm)獲取啟動腳本。<grok-card data-id="818026" data-type="citation_card"></grok-card>
- 基本使用:代碼生成與模擬 輸入提示例如「寫一個 Python 函數計算費氏數列」,模型會生成代碼並模擬執行:
- python
inputs = tokenizer("Write a Python function for Fibonacci:", return_tensors="pt")
outputs = model.generate(**inputs, max_length=200)
print(tokenizer.decode(outputs[0]))
- 報告建議用模擬器驗證:加入 simulate_execution=True 參數,模型會預演輸出,減少錯誤。適用於 VS Code 外掛:整合後可令 AI 實時除錯。
- 高級微調:代理任務優化 用 LoRA 進行微調:數據集例如 mutate‑fix(報告附 3M 軌跡)。步驟:(1) 下載數據;(2) 運行倉庫腳本 train.py ‑‑dataset mutate‑fix;(3) 訓練 1‑2 epoch,凍結約80%參數。報告稱,微調後 SWE‑bench 分數可提升約10%。示例應用:自動化修復 GitHub issue。
- 實際場景:企業與研究 企業可將其整合入類似 Copilot 嘅工具,提升代碼效率約30%。研究方面可用 CWM 測試世界模型擴展,例如加入影像輸入模擬 UI 設計。注意:許可禁止軍事用途,使用前需評估偏見風險。
CWM 嘅發佈係 Meta 喺 Llama4 開源 LLM 受到挑戰後再次嘗試開源嘅重要步驟。X 平台討論指佢有可能「重塑代碼 AI」。隨住 Meta 大舉吸納頂尖 AI 人才,顯示佢哋希望再次喺 AI 大舞台上爭取一席位。