
2026年,本地部署大模型已經成為開發者、研究人員同企業嘅剛需。推理框架嘅選擇直接決定相同硬件下嘅性能差異可達2‑6倍。近期多篇技術深度評測對主流框架做咗系統性比較,本文綜合權威測試數據同實際部署經驗,對vLLM、SGLang、llama.cpp、MLX、Ollama五大框架作全面解析,重點比較佢哋嘅基本原理、優缺點、適用範圍,並以表格形式呈現直觀對比。
一、五大框架核心原理概述
1. vLLM —— PagedAttention(分頁注意力)+ 持續批處理嘅生產級引擎
vLLM 係目前生產環境中使用最廣嘅本地/雲端推理框架。佢最大嘅創新係PagedAttention機制,呢個思想直接借鑒咗操作系統虛擬記憶體嘅分頁管理。
傳統 Transformer 喺推理時,KV Cache(鍵值緩存)會佔用大量顯存,而且所有請求必須等當前批次全部完成先開始下一個批次,導致顯存浪費嚴重(利用率通常只有60‑80%)同吞吐量成為瓶頸。vLLM 將 KV Cache 切割成固定大小嘅「頁」(pages,通常512‑2048 tokens),好似操作系統管理記憶體咁動態分配同回收。咁樣,即使唔同請求嘅序列長度差異好大,都可以高效復用顯存,顯存利用率可提升到95%以上。
同時,vLLM 引入Continuous Batching(持續批處理):當一個請求完成時,即刻將新請求插入執行隊列,唔使等成個批次結束。呢個機制大幅提高 GPU 利用率,尤其喺高併發 API 服務場景上優勢明顯。
vLLM 支援 NVIDIA、AMD、Google TPU、Intel Gaudi 等多種後端,生態成熟,集成簡單。
開源倉庫:https://github.com/vllm‑project/vllm
2. SGLang —— 以 RadixAttention(基數樹注意力緩存)為核心嘅智能體框架
SGLang 由部分 vLLM 原班人馬開發,係專為複雜交互場景設計嘅下一代推理框架。佢嘅核心創新係RadixAttention(基數樹注意力緩存)。
傳統框架喺請求結束後通常會即刻丟棄 KV Cache,而 SGLang 使用樹狀數據結構(Radix Tree)將所有歷史請求嘅前綴緩存持久化存儲。當新請求到來時,系統會智能查找最長匹配前綴,直接復用已計算嘅 KV Cache,只計算新增部分。呢種做法喺 RAG(檢索增強生成)、多輪對話、AI Agent 等場景中特別有效。
例如,喺企業知識庫問答中,多用戶查詢同一份文件嘅唔同段落時,SGLang 可以大幅減少重複計算。官方測試顯示,喺高前綴命中率場景下,SGLang 相比 vLLM 可實現 3‑6.4 倍嘅加速。此外,SGLang 喺結構化輸出(JSON 模式)同多代理協同方面亦做咗深度優化。
開源倉庫:https://github.com/sgl‑project/sglang
3. llama.cpp —— 極致輕量同跨平台嘅 GGUF 原生引擎
llama.cpp 係由 Georgi Gerganov 單人主導開發嘅經典項目,被譽為「本地大模型嘅瑞士軍刀」。佢嘅核心設計理念係極致簡潔同可移植性。
佢用純 C/C++ 實現,幾乎零外部依賴,支援由 2‑bit 到 FP16 嘅豐富量化方案。模型以 GGUF 格式存儲,通過 mmap(內存映射)技術實現極快嘅模型加載——即使係 70B 模型都可以喺幾秒內加載完成。佢唔依賴 CUDA、Metal 等特定框架,因此能夠喺由樹莓派、手機到伺服器嘅幾乎所有設備上運行。
llama.cpp 專注於單用戶、高效單流推理,喺資源受限環境下表現非常突出,但高併發能力相對較弱。
開源倉庫:https://github.com/ggerganov/llama.cpp
4. MLX —— 為 Apple Silicon 統一記憶體原生優化嘅框架
MLX 係由 Apple 相關團隊或社群開發嘅框架,專為 Apple Silicon(M 系列晶片)嘅統一記憶體架構(Unified Memory)度身訂造。
傳統框架喺 GPU 推理時,通常需要頻繁喺顯存同系統記憶體之間拷貝數據,而 MLX 直接令 CPU 同 GPU 共享同一物理記憶體池,避免拷貝開銷。同時,MLX 深度優化咗 AMX 矩陣加速指令集,並採用 Lazy Evaluation(惰性計算)等技術,最大化帶寬利用率。
喺 M4 Max / M4 Ultra 等大記憶體設備上,MLX 嘅性能通常可以領先其他框架 1.5‑3 倍,特別適合本地大模型實驗同長時間運行嘅 Agent 場景。
開源倉庫:https://github.com/ml‑explore/mlx
5. Ollama —— 最易用嘅本地大模型運行平台
Ollama 本身唔係底層推理引擎,而係一個高度封裝嘅本地運行時平臺,底層主要基於 llama.cpp 實現。
佢嘅核心價值係極致易用:一行命令即可下載、運行同管理模型(例如:ollama run llama3.1),同時提供 Web UI、兼容 OpenAI API、本地模型管理、Modelfile 自定義等功能。佢大大降低咗本地部署門檻,令非專業開發者亦可以輕鬆喺個人電腦上運行 70B 級模型。
Ollama 仲支持自定義 Modelfile 去創建專屬模型,並可切換唔同後端(如 llama.cpp、MLX 等)。佢更似一個「本地大模型嘅操作系統」,適合快速實驗同日常使用。
開源倉庫:https://github.com/ollama/ollama
二、性能與特性詳細對比
vLLM:喺 NVIDIA H100 上運行 Llama 3.1 70B 時,吞吐量領先,適合高併發生產環境。
SGLang:喺多輪對話同 RAG 場景下性能最強,前綴命中率高。
llama.cpp:單卡推理效率極高,特別喺低資源設備上表現突出。
MLX:喺 M4 Max/M4 Ultra 上性能碾壓其他框架。
Ollama:易用性第一,但高併發吞吐量明顯弱於 vLLM 同 SGLang,更適合個人同小型團隊使用。
三、五大框架對比表
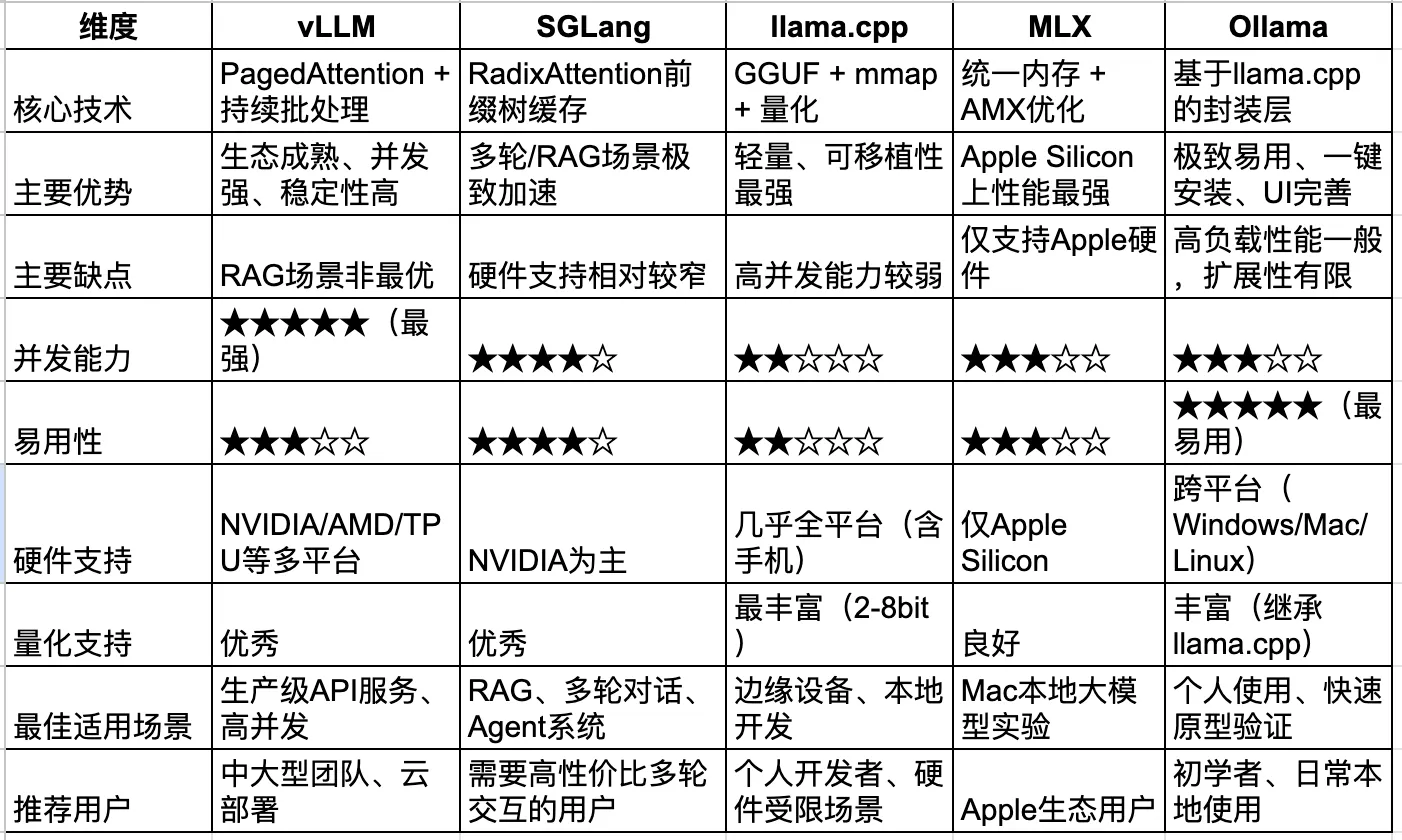
四、選型決策指南
- 生產環境、追求最高吞吐量同穩定性:優先選擇 vLLM,佢係目前最可靠嘅生產級方案。
- RAG、多輪對話、AI Agent 系統:SGLang 係最佳選擇,能帶來顯著嘅成本同速度優勢。
- Apple Mac 用戶:MLX 幾乎冇競品,特別適合 M3/M4 系列大記憶體設備。
- 邊緣設備、智能硬件、極致輕量部署:llama.cpp 係首選。
- 初學者、快速驗證、日常本地使用:Ollama 係最友好嘅入口,可作為其他底層引擎嘅前端。
推薦混合策略:好多野成熟團隊會採用 Ollama(本地開發/測試) + vLLM(生產通用服務) + SGLang(高價值 RAG/Agent 接口) 嘅組合方案。
五、未來發展趨勢
2026年,本地推理框架競爭重點已經由單純速度轉向場景適配度同工程智能。未來可能會出現更多融合型框架,例如將 SGLang 嘅 RadixAttention 同 vLLM 嘅生產穩定性結合,或者 Ollama 進一步整合 MLX/vLLM 做為後端。
隨住量化技術(FP8、INT4)、新硬件(Blackwell、Apple M5、昇騰等)同統一多後端接口嘅成熟,開發者會有更多靈活選擇。最終,冇絕對最好嘅框架,只有最適合當前硬件、負載類型同業務場景嘅方案。
總結建議:
- 新手/個人用戶:由 Ollama 開始;
- 追求極致性能:根據硬件選 SGLang(NVIDIA) 或 MLX(Apple);
- 生產部署:以 vLLM 為主,輔以 SGLang 處理複雜場景;
- 跨平台邊緣部署:llama.cpp 仍係底線保證。
本地大模型推理已進入「百花齊放」階段,正確理解每個框架嘅定位同邊界,先可以喺2026年嘅 AI 實踐中實現性能、成本同易用性嘅最佳平衡。
信息來源:
1. 官方項目倉庫(最權威來源)
- vLLM:https://github.com/vllm‑project/vllm
- SGLang:https://github.com/sgl‑project/sglang
- llama.cpp:https://github.com/ggerganov/llama.cpp
- MLX:https://github.com/ml‑explore/mlx
- Ollama:https://github.com/ollama/ollama
2. 官方文檔與技術報告
- vLLM 官方文檔(PagedAttention 原理):https://docs.vllm.ai/
- SGLang 官方文檔(RadixAttention):https://sgl‑project.github.io/sglang/
- llama.cpp GGUF 格式規範:https://github.com/ggerganov/llama.cpp/blob/master/gguf‑spec.md
- MLX 官方文檔:https://ml‑explore.github.io/mlx/
- Ollama 官方文檔:https://github.com/ollama/ollama/blob/main/docs/README.md
3. 2026年技術評測與深度文章
- 飛揚觀察:《2026本地大模型推理框架四強爭霸》 https://mp.weixin.qq.com/s/cV6nUgEh7Tm16‑7DOkpX‑A
- Java轉AI手記:《2026實測:Ollama / vLLM / SGLang / llama.cpp / MLX 全面對比報告》 https://mp.weixin.qq.com/s/5NjrfOoru8a_9k46E8S‑Hg
- 量子位:2026本地推理框架性能評測專題 https://www.qbitai.com/(搜索“2026 本地推理框架”)
- 機器之心:SGLang vs vLLM 實戰對比 https://www.jiqizhixin.com/(搜索“SGLang RadixAttention”)
4. 其他權威基準與報告
- Artificial Analysis 推理性能排行榜(2026):https://artificialanalysis.ai/
- Hugging Face vLLM & SGLang 優化案例:https://huggingface.co/blog
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請訪問:https://www.airosetta.com