
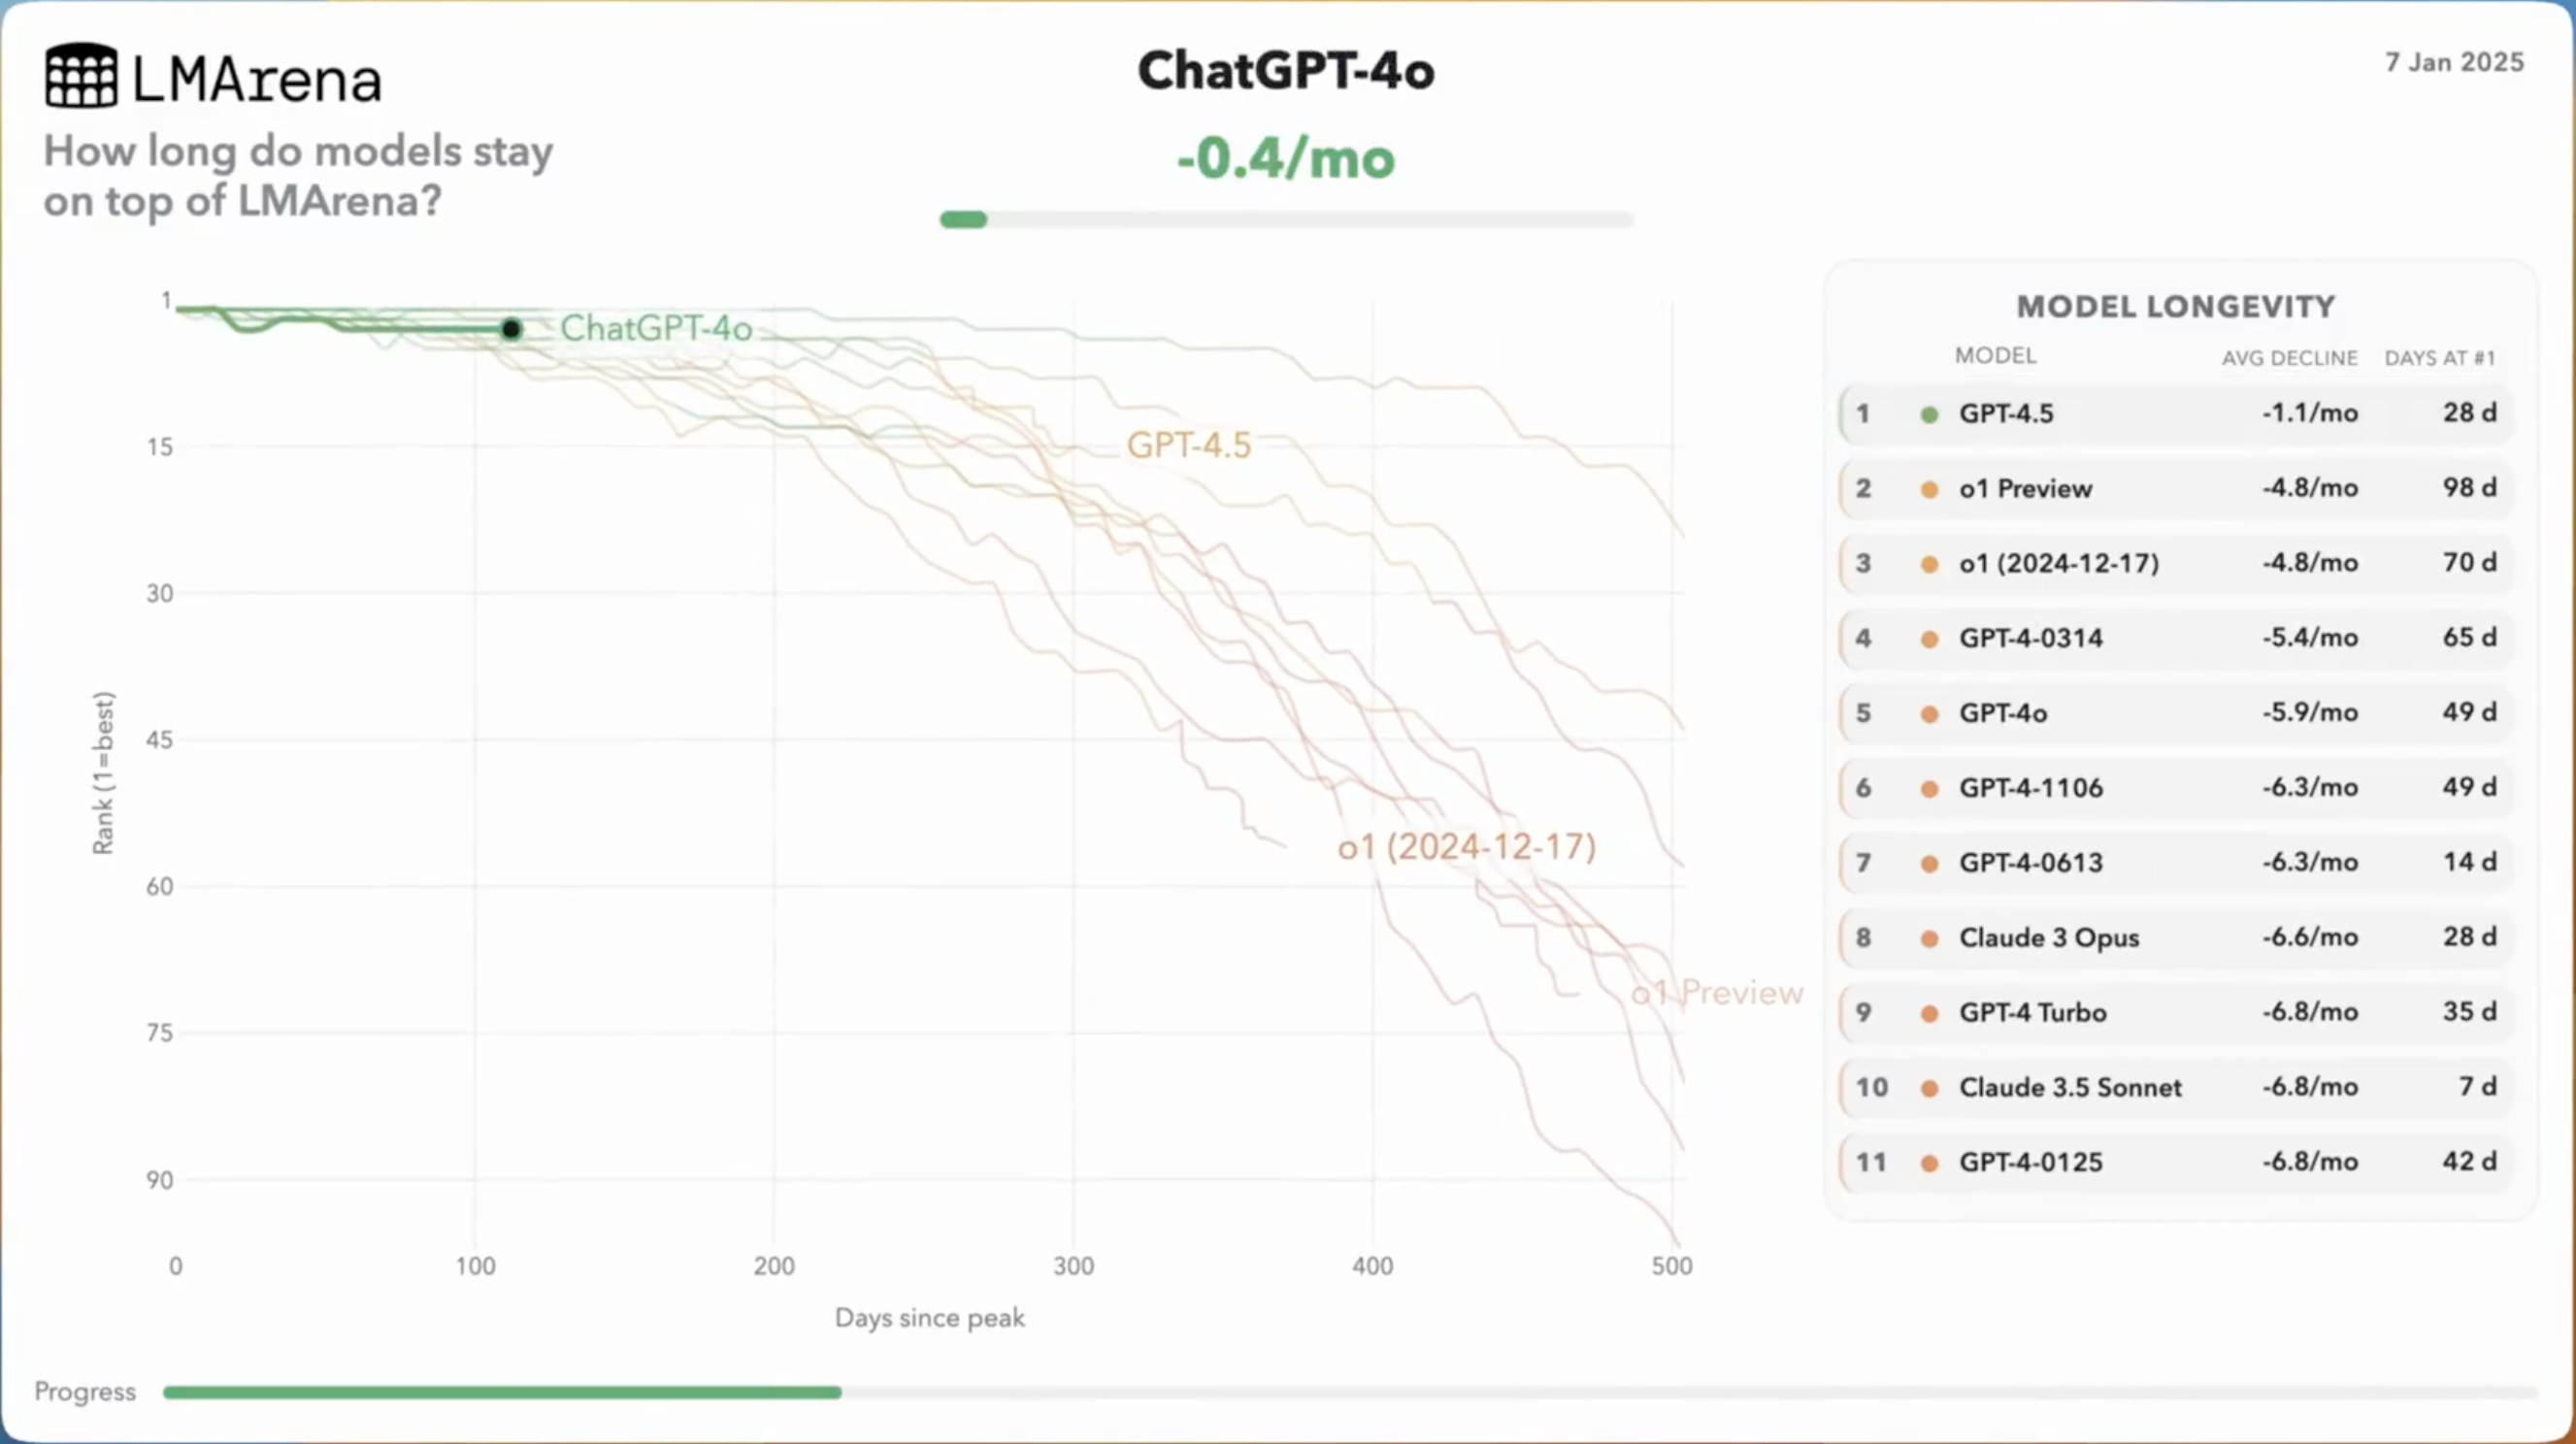
在人工智能領域,大語言模型(LLM)嘅表現評估已經成為開發者、研究員同企業關注嘅焦點。其中特別係由加州大學伯克利分校LMSYS團隊維護、又稱LM Arena或lmarena嘅開源競技榜,透過群眾投票同Elo評分制,對唔同大模型做即時排名。該榜自2023年推出以來,已成為衡量模型能力嘅「黃金標準」,影響住OpenAI到Anthropic等巨頭嘅研發方向。近期分析顯示,自2023年中GPT‑4登頂開始,模型喺榜首嘅平均停留時間僅約35日,代表AI領域嘅領導地位正以驚人速度更替。呢個現象唔單止反映技術進步加快,亦對產品開發同商業應用造成深遠衝擊。本文基於LM Arena嘅歷史數據同其他權威來源,探討呢一趨勢嘅成因、案例同啟示。
LM Arena榜單嘅演變同統計洞察
LM Arena由加州大學伯克利分校嘅LMSYS團隊維護,透過匿名隨機對戰方式收集用戶偏好數據,生成Elo分數(類似國際象棋排名系統)。自2023年5月正式上線以來,該榜已累計處理數百萬次投票,涵蓋數百款模型。由2023年中開始計算,當時OpenAI嘅GPT‑4以其強大嘅多模態能力同推理表現穩居榜首,但呢個霸主地位好快就受到挑戰。
據LMSYS官方分析,自GPT‑4時代起,所有曾登頂嘅模型平均喺No.1位置只維持大約35日。呢個數字遠低於早期預期——唔係半年或一年,而係以「月」為單位。更令人震驚嘅係,唔少模型喺登頂後約五個月就會跌出Top 5,七個月後甚至難以保住Top 10。斯坦福大學人類中心人工智能研究所(HAI)喺2025年AI指數報告入面亦印證咗呢個趨勢:封閉模型(例如GPT系列)同開放模型(例如Llama系列)喺榜單上嘅表現波動劇烈,2023至2025年間,Top模型嘅更替頻率由季度級加速至月級。
回顧歷史,GPT‑4喺2023年3月發布後迅速登頂,並喺一段時間內保持領先,但到2024年初已被Anthropic嘅Claude 3 Opus短暫超越。其後,OpenAI嘅GPT‑4o(2024年5月版)以約78日嘅領先時長成為停留較長嘅模型之一。2024年中,Anthropic嘅Claude 3.5 Sonnet同OpenAI嘅o1‑preview相繼上位,前者強調高效推理,後者引入「思考鏈」機制,一度被譽為「最強推理模型」。踏入2025年,模型迭代進一步加速:Google嘅Gemini 1.5 Pro、Meta嘅Llama 3.1‑405B,同後續嘅GPT‑5同Claude 4系列輪番登頂。到2026年1月,榜單Top模型已更新為GPT‑5.2(Elo約1350+)、Claude Opus 4.5(緊隨其後)同Gemini 3 Pro,呢啲新晉者受惠於更大規模嘅訓練數據同優化算法。
Observable平台嘅LM Arena歷史可視化數據顯示,模型家族(例如GPT系列)累計領先天數雖然較高,但單一版本嘅「王朝」極短。例如,某啲模型嘅領先期最短僅數周,呢點與AI硬件進步(如NVIDIA H100到B200 GPU升級)同訓練範式轉變(例如MoE架構嘅普及)密切相關。TechCrunch報道指出,行業對LM Arena嘅迷戀雖然推動咗競爭,但亦暴露咗基準嘅局限:佢更注重通用聊天,而非專業任務。儘管如此,該榜單仍被視為「野生基準」,反映真實用戶體驗。
典型案例:從巔峰到隕落
具體例子可以更清晰突顯呢一趨勢帶嚟嘅衝擊力。OpenAI嘅o1模型(2024年9月發布)一度以其先進嘅推理能力同「o1思考」模式風靡全球,被視為「領先一代」嘅產品。佢迅速登頂LM Arena,討論度非常高,甚至喺Reddit同X平台引發「AI新時代」嘅熱議。不過,到2026年1月,o1已跌至第56位,被後續模型如GPT‑5同Claude 4系列遠遠拋離。類似地,Anthropic嘅Claude 3 Opus(2024年3月發布)曾短暫超越GPT‑4,成為「最強推理模型」嘅代名詞,喺複雜任務上表現備受讚譽。但而家,佢已滑落至第139位,遠低於當前Top 20。OpenLM.ai嘅擴展榜單顯示,Claude 3 Opus嘅Elo分數停留喺1265左右,而Top模型已超過1300。
呢啲案例唔係孤立事件。2024年嘅Gemini 1.5 Pro一度位列前三,但到2025年底已被其後繼者取代。Vellum AI嘅分析顯示,o1喺推理基準上雖然優於GPT‑4o同Claude 3.5 Sonnet,但整體通用性不足以抵擋新模型嘅湧現。斯坦福HAI報告亦進一步指出,2024至2025年間,封閉模型喺榜單上嘅勝率由60%下降至50%,開放模型(例如Llama系列)透過社區優化加速追趕。呢種快速更替源於計算資源嘅指數增長:訓練一個頂級模型成本雖然高企,但回報周期縮短,迫使巨頭更頻繁推出更新。
深層影響:模型能力「反向壓扁」產品層
呢一趨勢嘅核心啟示係:大模型基礎能力提升嘅速度,已超越絕大多數AI產品嘅迭代周期。傳統軟件開發周期係3至6個月,而模型更替僅35日,呢個情況意味住產品團隊可能喺集成舊模型嗰陣,新嘅王者已經出現,導致所謂「反向壓扁」——產品功能被底層模型嘅快速進步主導,而唔係相反。
例如,企業級AI應用(例如聊天機械人或代碼助手)如果基於Claude 3 Opus構建,數月後其性能就可能落後於競爭對手。Clarifai嘅2026年AI趨勢報告警告,2026年,LLM如GPT‑5、Gemini 3同Claude 4將主導市場,但企業需轉向「與模型無關」嘅架構,以適應快速換代。Medium上嘅分析亦指出,2026年AI開發趨勢會強調平台整合,而唔係單一模型依賴。此外,多模態榜單嘅興起(例如LMSYS嘅多模態Arena)進一步加速咗呢個過程,Claude 3 Opus喺多模態上嘅領先優勢亦迅速消失。
從商業角度睇,呢個趨勢壓縮咗「護城河」:OpenAI等公司雖然保持領先,但優勢窗口縮短至月級,迫使佢哋加快發佈(例如由GPT‑4到GPT‑5嘅躍進)。FelloAI嘅2026年最佳AI排名顯示,當前Top模型喺上下文窗口、定價同多模態能力上全面升級,但用戶實際使用數據顯示,排名波動已影響採用率。Deepchecks嘅基準評估強調,Claude 3 Opus雖然喺某啲子任務上仍然表現優秀,但整體落後突顯出迭代嘅殘酷性。
展望:AI發展嘅加速與挑戰
整體而言,LM Arena嘅統計揭示出AI領域呈現「摩爾定律」式嘅加速:由2023年嘅GPT‑4時代,到2026年嘅GPT‑5.2主導,模型性能似乎每半年有顯著提升。呢種加速雖然推動創新,但亦帶嚟挑戰,例如資源集中於少數巨頭同對單一基準嘅依賴風險。未來,行業需探索更全面嘅評估方法,例如結合MMLU、HumanEval等多項基準,以減低單一榜單偏差帶嚟嘅影響。
喺呢股浪潮之中,無永恆王者。開發者應該擁抱敏捷迭代,企業亦需建立靈活嘅生態,以免被「反向壓扁」。正如LMSYS所言,Arena唔單止係排名,更係AI進化嘅鏡像。展望2026年,AI嘅黃金時代先剛開始,但速度已成為決定性因素。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎追蹤我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請瀏覽:https://www.airosetta.com