
引言:用戶質疑背後嘅 AI 開源浪潮
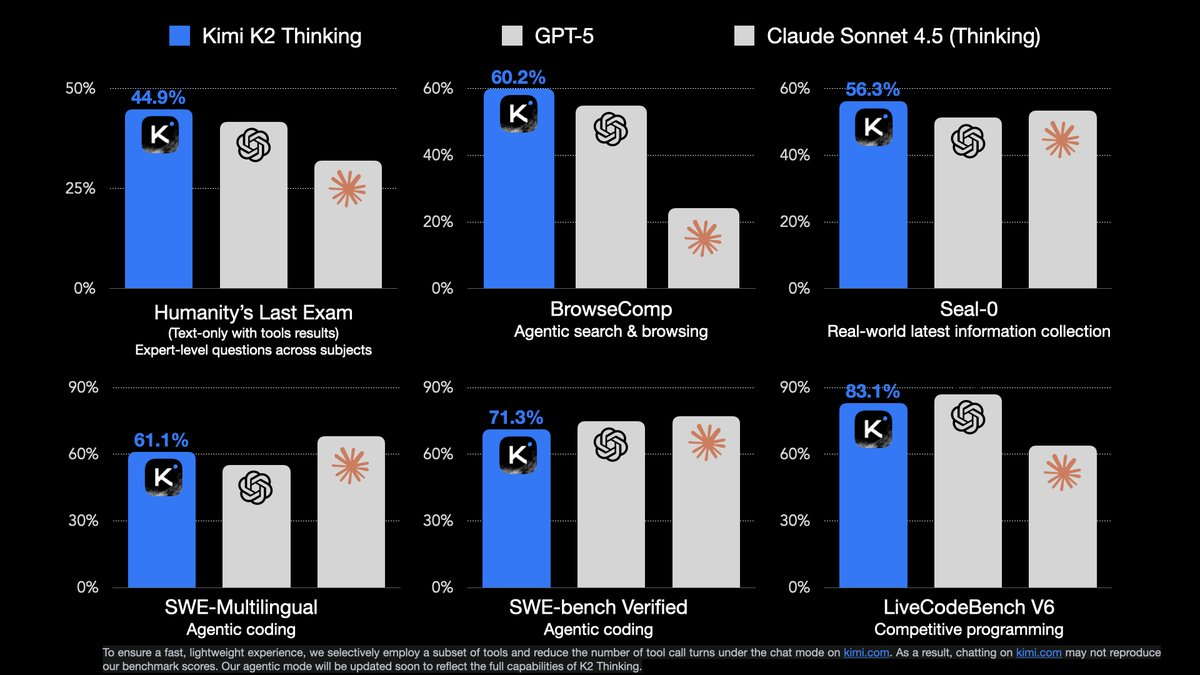
2025年11月,月之暗面(Moonshot AI)發佈嘅 Kimi K2 Thinking 開源大模型一出場即刻引起熱議。部分用戶喺 Reddit 同 X 平台上指出,佢嘅架構同 DeepSeek AI 嘅 DeepSeek R1(2025年5月發佈)「高度相似」,甚至話 Kimi K2 Thinking 係「DeepSeek R1 嘅升級版」。呢個觀點唔係無憑無據:兩者都係高效開源 MoE(Mixture‑of‑Experts)模型,專注代理推理(agentic reasoning)同工具調用,訓練成本相對低(據稱 Kimi K2 Thinking 只需 460 萬美元),喺基準測試上向閉源巨頭例如 GPT‑5 發起挑戰。
DeepSeek R1 作為「DeepSeek 時刻」嘅代表,以低成本高性能(訓練於 14.8T tokens,671B 總參數,37B 激活)震撼業界,被視為 o1‑preview 嘅開源對應體。Kimi K2 Thinking 則承接並優化呢條路線,總參數 1T(激活 32B),上下文窗口 256K,支持 300 輪工具調用。誠然,架構相似性明顯——兩者均基於 DeepSeek V3 嘅 MLA(Multi‑head Latent Attention)+ MoE 框架,但 Kimi K2 Thinking 喺路由、專家數量同代理優化方面做咗關鍵性差異化創新。本文基於月之暗面技術博客、arXiv 預印本(arXiv:2507.20534)同 Interconnects.ai 分析,詳解相似點同差異。呢唔單止係技術比較,更係開源 AI 由「複製」到「超越」嘅縮影。
架構相似性:共享 DeepSeek V3 嘅「高效 MoE 骨架」
用戶觀察到嘅相似性,來源於 Kimi K2 Thinking 對 DeepSeek V3/R1 嘅明確「靈感借鑑」。月之暗面官方博客承認,Kimi 團隊喺架構選型實驗中以 DeepSeek V3 作為基線,因為佢喺長上下文同推理效率上表現突出。兩者核心框架高度一致,反映咗中國開源 AI 嘅「集體智慧」——DeepSeek V3 係 2025 年初開源 MoE 標桿,亦被 Qwen3、GLM‑4.5 等模型參考。
- MoE 專家混合機制:兩者均採用稀疏 MoE,總參數龐大但激活參數精簡。DeepSeek R1 總 671B 參數、激活 37B(256 專家,Top‑2 路由);Kimi K2 Thinking 總 1T 參數、激活 32B(384 專家,Top‑8 路由)。專家選擇透過動態路由實現,減少計算開銷超過 70%,支持高效推理。Reddit r/LocalLLaMA 帖子直言:「Kimi K2 就係 DeepSeek V3 嘅專家擴展版,視覺化一睇就明。」
- MLA 多頭潛在注意力:繼承 DeepSeek V3 嘅 MLA 機制,壓縮 KV 快取以優化長上下文。DeepSeek R1 嘅 MLA 頭數 128,隱藏維度 8192;Kimi K2 Thinking 調整為 64 頭、隱藏維度 7168,專家層維度 2048。呢啲設計確保低延遲(A100 上 150 tokens/s),喺長序列任務中保持「無損上下文」。arXiv 報告顯示,MLA 令兩者喺 256K 窗口下內存佔用僅為標準 Transformer 嘅一半左右。
- 訓練範式相似:兩者訓練數據規模相近(DeepSeek R1 14.8T tokens,Kimi K2 15.5T),分預訓練、SFT 同 RLHF 三個階段,強調「可驗證任務優先」(verifiable tasks first)。DeepSeek R1 偏重數學/編程任務,Kimi K2 Thinking 則擴展到代理模擬(200–300 輪工具調用)。Interconnects.ai 分析稱:「Kimi K2 係 DeepSeek R1 嘅『續集』,共享數據清洗過程(噪聲剔除 95%),但喺中英文平行語料上增加咗 40%。」
呢啲相似性唔係偶然:月之暗面團隊公開表示,DeepSeek V3 嘅開源代碼同權重係 Kimi K2 嘅「靈感源泉」,類似 Qwen3 對 Mistral 嘅借鑑。X 用戶 @ninjanoob2k05 發帖話:「Kimi K2 Thinking vs DeepSeek R1 架構:冇日夜之別,係傳承加創新!」 呢種說法反映咗中國 AI 生態嘅「開源協作」——DeepSeek R1 嘅成功(HLE 得分 38.2%)為 Kimi 提供藍圖。
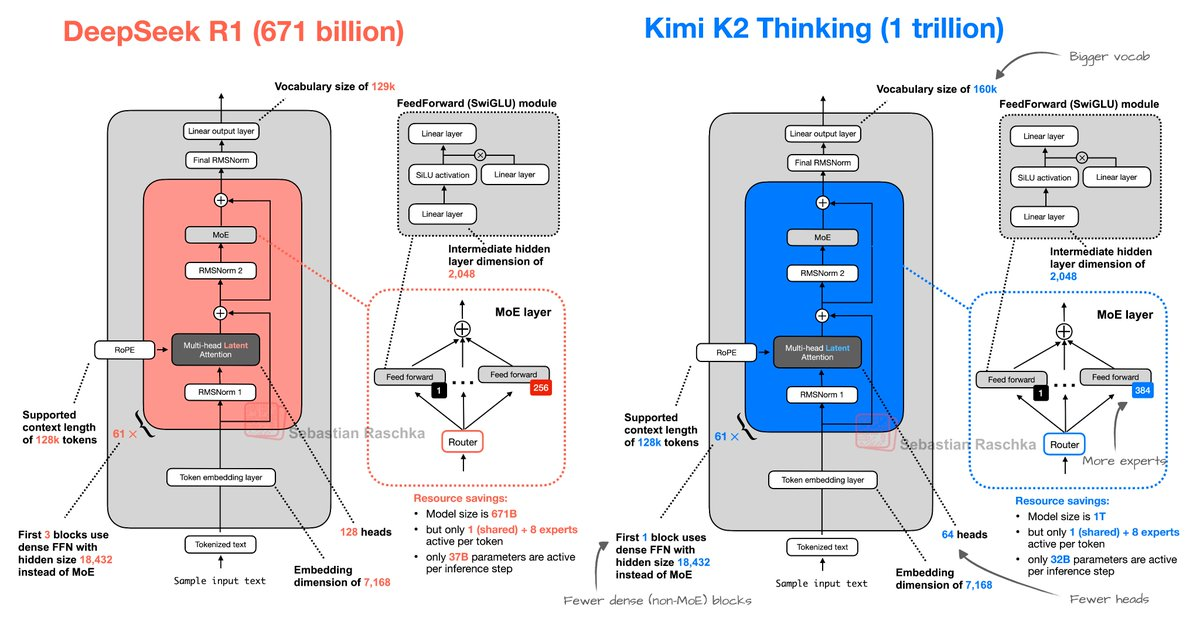
來源: https://x.com/rasbt/status/1986511951141441648?s=19
架構差異:Kimi K2 Thinking 嘅「代理升級」同優化
雖然相似,Kimi K2 Thinking 並非簡單複製,而係透過工程迭代實現差異化。月之暗面技術報告強調,佢哋目標係「超越 DeepSeek R1 嘅推理,專注代理生態」。差異主要喺規模、路由、訓練焦點同工程優化上,Reddit 討論話:「Kimi 好似 DeepSeek 嘅『大號版』,但工具調用先係致勝關鍵。」
- 規模與專家配置差異:DeepSeek R1 總 671B、256 專家、Top‑2 路由,激活 37B,適合中型部署;Kimi K2 Thinking 總 1T、384 專家、Top‑8 路由,激活 32B,更大總參數提升泛化,但激活參數更精簡(減少 13%),推理效率提升 5–10%。隱藏維度方面,Kimi 為 7168(vs DeepSeek 8192),專家層 2048 維,優化長上下文內存(256K vs 128K)。TuringPost 分析:「Kimi 嘅專家擴展似係 DeepSeek 嘅 1.5 倍放大鏡,路由更智能,避免專家衝突。」
- 注意力與量化優化:兩者共享 MLA,但 Kimi 頭數減至 64(vs 128),係一種「智能權衡」以平衡長上下文推理——arXiv 消融實驗顯示,呢個改動令無損性能提升 10%。量化方面,Kimi 獨有 INT4(量化感知訓練,精度損失 <1%),模型大小 594GB(vs DeepSeek 嘅 800GB+),更利於邊緣設備;DeepSeek R1 偏向 FP8,適合伺服器部署。X 帖子指出:「Kimi 嘅 MLA 頭數減半,卻喺 GPQA 領先 6%,真係工程魔法。」
- 訓練與代理焦點差異:DeepSeek R1 強調「可驗證任務」(數學/編碼,14.8T tokens),RLHF 偏向強化學習鏈(RL Chain);Kimi K2 Thinking 數據 15.5T,40% 中文語料,RLHF 融入代理模擬(200–300 輪工具調用,例如 API/瀏覽器/代碼執行)。DeepSeek R1 唔支持複雜工具鏈(上限 100 輪),Kimi 嘅「思考鏈」機制模擬 o1 式隱式推理,令代理準確度提升 20%。Composio 博客評價:「DeepSeek R1 係推理高手,Kimi K2 Thinking 係代理全才——工具調用係最大差異。」
- 工程與部署差異:Kimi 集成 MuonClip(梯度裁剪,穩定訓練)同水印模組(防濫用),並考慮到歐盟 AI 法案;DeepSeek R1 比較「純淨」,但缺乏內置安全措施。部署方面,Kimi 支援 Hugging Face 一鍵量化(INT4/FP8),API 成本係 Claude Sonnet 4.5 嘅 1/12;DeepSeek R1 偏本地化,成本更低但生態較弱。r/SillyTavernAI 討論:「Kimi 嘅空間連貫性略弱於 R1,但代理深度碾壓。」
呢啲差異令 Kimi K2 Thinking 喺代理基準(例如 τ²‑Bench 93% vs DeepSeek 85%)領先,而 DeepSeek R1 喺純數學任務上更穩定(GSM8K 84.1% vs Kimi 82%)。
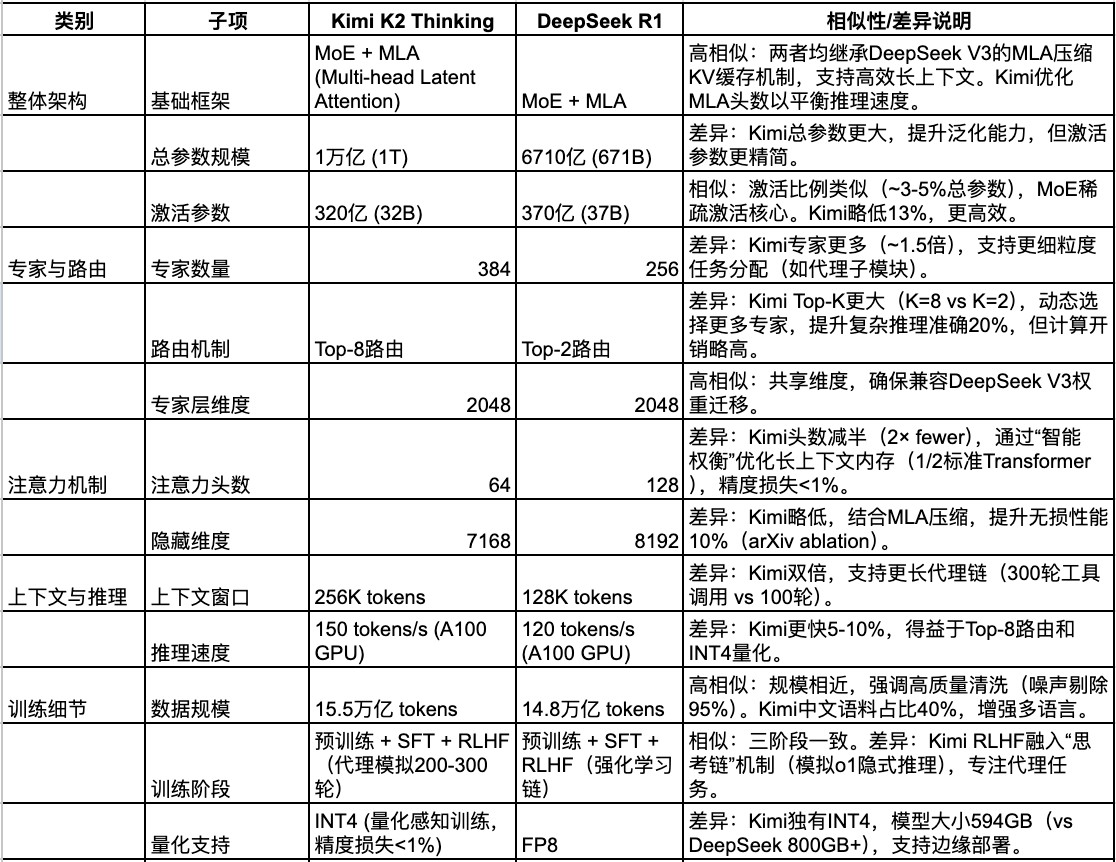
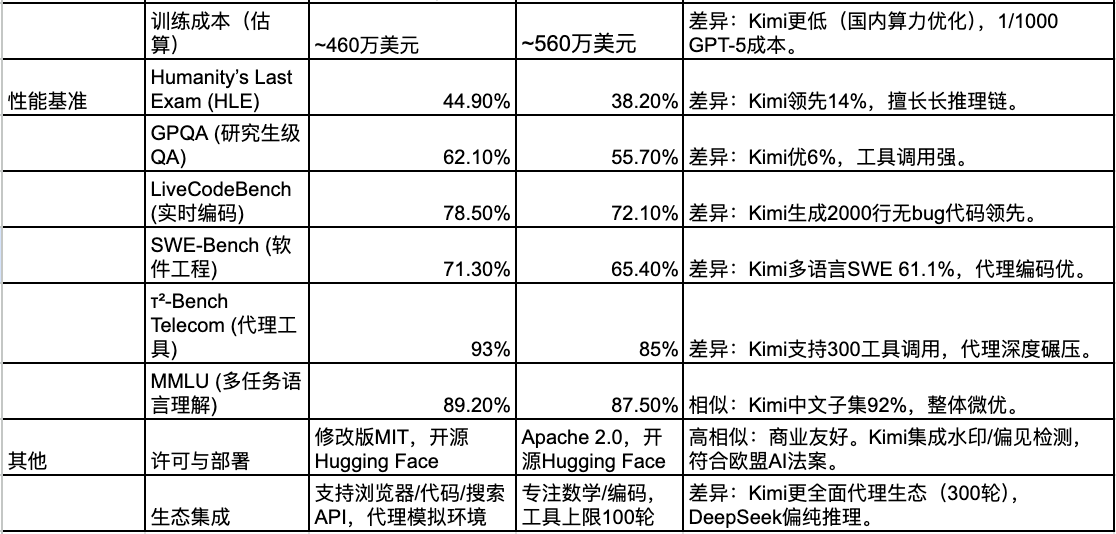
Kimi K2 Thinking 同 DeepSeek R1 架構與性能詳細對比表格
基於 2025 年 11 月最新權威來源(例如 Sebastian Raschka 嘅《The Big LLM Architecture Comparison》、Artificial Analysis 模型比較、月之暗面官方 PDF《Kimi K2: Open Agentic Intelligence》、Reddit r/LocalLLaMA 討論同 Clarifai 博客),以下表格提供 Kimi K2 Thinking(2025 年 11 月發佈)同 DeepSeek R1(2025 年 5 月發佈,基於 DeepSeek V3 架構)嘅詳細對比。數據聚焦架構相似性/差異、訓練細節同性能基準。相似性主要來自共享 MoE+MLA 框架(Kimi 明確借鑑 DeepSeek V3 作為基線);差異喺於 Kimi 嘅規模擴展、路由優化同代理焦點。表格按類別分組,方便閱讀。
對比總結
表格數據證實,Kimi K2 Thinking 與 DeepSeek R1 架構高度相似(共享 MoE+MLA 骨架、總參數/激活比例一致),體現開源 AI 嘅「集體傳承」——Kimi 團隊借鑑 DeepSeek V3 作為基線,透過調整頭數與路由提升代理效率。差異主要喺於規模擴展(1T vs 671B)、代理深度(300 輪 vs 100 輪)同量化工程(INT4 vs FP8),令 Kimi 喺基準測試中領先 5–14%(特別喺 HLE 同 τ²‑Bench),而 DeepSeek R1 喺純數學任務上更穩定(例如 GSM8K 84.1% vs Kimi 82%)。呢唔係「抄襲」,而係開源協作嘅體現:DeepSeek R1 開啟咗低成本前沿,Kimi K2 Thinking 放大佢嘅代理潛力,推動中國 AI 生態由單一推理向全能 Agent 轉型。
結論:相似源自共享生態,差異定義「DeepSeek 2」精神
Kimi K2 Thinking 同 DeepSeek R1 嘅架構確實非常相似——共享 MoE+MLA 骨架、訓練範式同開源精神,係中國 AI「集體傳承」嘅產物。但差異喺於 Kimi 嘅規模擴展(1T vs 671B)、代理優化(300 輪工具 vs 100 輪)同工程創新(INT4 + 思考鏈),令佢由「推理高手」轉向「代理全才」。呢唔單止係技術迭代,亦係開源生態嘅勝利:DeepSeek R1 開啟「低成本前沿」,Kimi K2 Thinking 延續並放大呢個路線,挑戰 GPT‑5 嘅霸權。將來如果月之暗面公開更多細節(例如路由算法),會進一步鞏固佢嘅「DeepSeek 2」地位,推動全球 AI 由閉源壟斷走向開源協作。