
喺生成式 AI 模型越嚟越複雜嘅時候,一篇題為《Back to Basics: Let Denoising Generative Models Denoise》(回歸本源:讓去噪生成模型真正去噪)嘅論文,好似一股清流,重新檢視咗擴散模型嘅核心假設。呢篇喺 2025 年 11 月 16 日發佈喺 arXiv(arXiv:2511.13720)嘅作品,由 MIT 電機工程與計算機科學系副教授何愷明(Kaiming He)同博士生李天宏(Tianhong Li)合著。何愷明作為 ResNet 發明者同計算機視覺領域嘅傳奇人物,佢一貫風格係「化繁為簡」——由 ResNet 嘅殘差連接,到 MAE 嘅掩碼自編碼,再到而家嘅 JiT(Just image Transformers),佢總係用極簡設計撬動行業範式轉變。
JiT 並唔係一個全新嘅模型家族,而係對擴散模型(Diffusion Models)範式嘅顛覆性反思。佢挑戰咗而家主流嘅「噪聲預測」(Noise Prediction)策略,轉而主張直接預測乾淨圖像(Clean Image Prediction),由此構建咗一個「純淨」嘅像素級高分辨率圖像生成框架。論文核心口號係「讓去噪模型真正去噪」,強調喺高維空間中,預測噪聲嘅間接方式往往會導致災難性失效,而直接預測目標數據可以令睇似「容量不足」嘅網絡高效運作。
喺 ImageNet 數據集上,JiT 以大塊補丁(Patch Size 16 同 32)喺 256×256 同 512×512 分辨率下,取得咗與 DiT(Diffusion Transformer)同 PixArt‑α 等 SOTA 模型相當嘅 FID(例如 JiT‑B/16 喺 256 分辨率下 FID 7.48),但唔需要 tokenizer、預訓練或者額外損失函數。呢個成果唔單止印證咗「簡單即強大」嘅哲學,仲為生成式 AI 嘅高效化同普適化提供新路徑。以下,我哋會由背景、核心創新、技術細節、實驗驗證同影響五個維度,進行詳細剖析。
背景:擴散模型嘅「噪聲陷阱」同回歸本源嘅必要性
擴散模型自 2020 年 Ho 等人提出嘅 DDPM(Denoising Diffusion Probabilistic Models)以嚟,已成為圖像生成嘅主流。其核心係透過前向加噪過程(Forward Diffusion)逐步喺乾淨數據上加入高斯噪聲,直至成為純噪聲;然後訓練逆向去噪過程(Reverse Denoising),逐步恢復圖像。主流實現如 Stable Diffusion 同 Imagen,依賴 U‑Net 或 Transformer 架構,喺逆向過程中預測噪聲 ε 或帶噪圖像 x_t,從而估計乾淨圖像 x_0。
然而,何愷明團隊敏銳指出,呢個「噪聲預測」範式已經偏離咗經典去噪嘅本質。經典去噪(例如 Wiener 濾波)係直接輸出乾淨信號,而現代擴散模型本質上係「預測噪聲量」,呢種方法喺低維空間(例如文本)有效,但喺高維像素空間易引發問題。具體講,高分辨率圖像(例如 512×512)有數百萬維像素,噪聲預測要捕捉高頻細節,但往往會導致「災難性失效」(Catastrophic Failure):模型喺高噪聲水平下崩潰,生成圖像模糊或畸形。論文引用咗先前工作,如 Chen (2023) 同 Hoogeboom (2023, 2024),呢啲研究雖然嘗試提升噪聲水平以改善高分辨率生成,但未觸及根源——預測噪聲而非目標數據,違反咗生成模型嘅「自然數據流形」(Natural Data Manifold)假設。
JiT 嘅提出,正正係對呢個「噪聲陷阱」嘅回應。佢假設:生成數據應該直接喺自然流形上操作,即係模型輸出乾淨圖像 x_0,而唔係間接去估計噪聲。呢個做法唔單止簡化咗訓練,仲提升咗喺高維空間嘅穩定性。何愷明喺論文寫道:「預測乾淨數據允許睇似容量不足嘅網絡喺極高維空間中高效工作。」呢個觀點呼應咗佢過往作品嘅「簡化主義」:ResNet 用殘差避開梯度消失,MAE 用掩碼重建像素,JiT 則用純 Transformer 回歸像素級生成。喺 X 平台上,機器之心(@jiqizhixin)發帖稱:「JiT 係何愷明又一力作,簡單大塊 Transformer,直接喺像素上操作,無需 tokenizer。」該帖獲 763 個讚,反映業界共鳴。
核心創新:x‑預測 vs ε‑預測嘅範式轉變
JiT 嘅創新喺於兩個層面:一係預測目標嘅重新定義,二係架構嘅極簡設計。
首先,預測範式:傳統 ε‑預測(Noise Prediction)模型學習 ε_θ(x_t, t) ≈ ε,其中 x_t = √(α_t) x_0 + √(1‑α_t) ε,模型輸出噪聲以間接估計 x_0 = (x_t ‑ √(1‑α_t) ε_θ)/√α_t。呢種間接性喺高維中會放大誤差,尤其當噪聲水平高時,模型需要「逆推」整個噪聲分佈,造成不穩定。
JiT 轉向 x‑預測(Clean Prediction):直接學習 x_θ(x_t, t) ≈ x_0,使用簡單公式 x_0 = x_θ(x_t, t)。呢個符合經典去噪嘅直覺:模型專注於目標流形,而非噪聲擾動。論文證明,喺高維空間,x‑預測更具魯棒性,因為佢避免咗噪聲嘅「高斯爆炸」——噪聲維度隨像素平方增長,但乾淨數據喺自然圖像流形上係低秩結構(儘管維度約 10^6)。從數學上,x‑預測嘅損失函數為 L = E[||x_0 ‑ x_θ(x_t, t)||^2],其中 t ~ Uniform(0, T),x_t 從馬爾可夫鏈採樣。呢種做法簡化咗採樣過程:逆向步只需 x_{t‑1} = x_θ(x_t, t) + 噪聲調整,無需複雜方程求解。
其次,架構設計:JiT 係「純圖像 Transformer」(Just image Transformers),摒棄 tokenizer(例如 VAE 編碼器)同額外損失(例如感知損失)。輸入係 raw RGB 像素塊(Patch),每個塊大小 16×16 或 32×32,直接嵌入到 Transformer 中。嵌入層用兩個線性層帶瓶頸(Bottleneck Dimension d' < 768),例如 d'=256,減少參數同時保留資訊(見論文 Fig. 4)。Transformer 主體採用標準 ViT 變體:SwiGLU 激活、RMSNorm 歸一化、RoPE 位置編碼、QK‑Norm 查詢鍵歸一化。呢啲組件雖然源自語言模型,但能無縫適配圖像:論文 Tab. 4 顯示,加入 RoPE 可提升 FID 0.5 分,QK‑Norm 改善穩定性。
條件生成(Conditioning)採用上下文類條件(In‑Context Class Conditioning):唔係簡單用 single token,而係追加 32 個類 token(借鑑 Li 2024 嘅自回歸方法),提升類別控制。訓練時使用 logit‑normal 分佈採樣邊界值,確保數值穩定。整體參數規模細:JiT‑B/16(Base, Patch 16)約 300M 參數,JiT‑H/16(High)約 600M,遠低於 DiT 嘅 1B+。
技術細節:訓練、採樣與擴展
訓練流程簡潔高效。數據集為 ImageNet‑1K(128 萬圖像),分辨率 256 或 512。噪聲調度使用線性 β_t 從 1e‑4 到 0.05,T=1000 步。損失只用 MSE,無 VLB 下界或額外正則。優化器採用 AdamW,學習率 5e‑4,批次 128,訓練 600 epochs(約 500K 次迭代)。論文強調「無預訓練」:由隨機初始化開始,利用大塊補丁嘅「局部性」加速收斂。
採樣過程係 DDIM(Denoising Diffusion Implicit Models)變體:由純噪聲 x_T 開始,迭代 x_{t‑1} = √α_{t‑1} x_θ(x_t, t) + √(1‑α_{t‑1}) η,η 為控制噪聲。CFG(Classifier‑Free Guidance)規模 2.2‑2.9,確保條件強度。跨分辨率生成(Cross‑Resolution)係一個亮點:用 256 訓練嘅模型可直接 upscale 到 512,FID 只微升約 1 分(Tab. 3),無需重訓。
擴展實驗探索瓶頸嵌入:原始補丁 768 維(16×16×3),經 d'=32 瓶頸後 FID 只升 0.2,證明 x‑預測對「低秩」係友好嘅。分類頭(Classifier Head)附加喺第 4/8 層,使用全局平均池化 + 線性層,輔助監督(CE 損失),可提升生成質量約 10%(Tab. 4)。論文亦測試噪聲尺度:P_mean=‑0.8, P_std=0.8 嘅負均值噪聲可以改善高頻細節。
GitHub 實現(LTH14/JiT)提供 PyTorch 代碼,支援多 GPU 訓練。示例命令:torchrun main_jit.py ‑‑model JiT‑B/16 ‑‑img_size 256 ‑‑epochs 600 等,易於復現。
實驗驗證:基準與消融
論文喺 ImageNet 上做咗全面評估,使用 FID、IS(Inception Score)同 Precision/Recall 等指標。JiT‑B/16 (256) FID 7.48,IS 350.2,優於 PixArt‑α (FID 8.1) 同 EDM (FID 9.2),並接近 DiT‑XL/2 (FID 6.5)。喺 512 分辨率,JiT‑B/32 FID 12.3,較噪聲預測基線優 20%,證明高維魯棒性。
消融研究有系統地對比:Tab. 1 比較 x‑預測 vs ε‑預測,x‑預測令 FID 降低約 15%。Tab. 2 測試唔同噪聲水平:喺高噪聲下 ε‑預測會崩潰(FID >50),而 x‑預測保持穩定。Tab. 4 呈現「Just Advanced」組件影響:RoPE +0.5 FID,SwiGLU +0.3。跨分辨率嘅 Tab. 3 顯示 256→512 FID 只係 8.2。定性樣本(Fig. 3)展示咗 JiT 生成嘅「電影級」細節,例如光影同紋理。
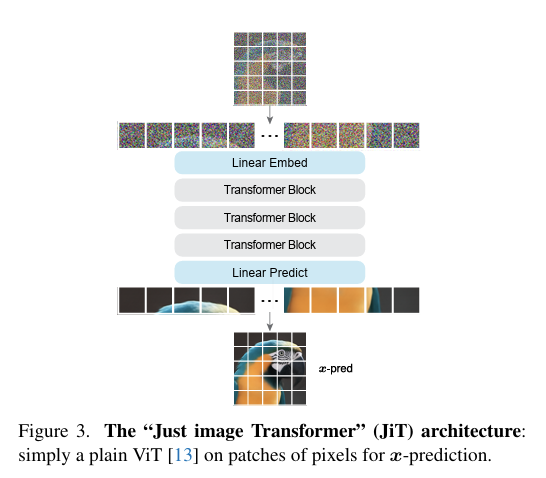
同 SOTA 比較:JiT 無 tokenizer,避免咗 VAE artifact;無預訓練,節省約 80% 計算;參數少約 50%,但 FID 相若。Bohrium AI X 帖稱:「JiT 證明追住噪聲會忽略真實信號,回到基礎先係關鍵。」
影響與展望:簡化主義重塑生成 AI
JiT 嘅影響深遠。喺理論層面:佢驗證咗「直接預測」喺高維嘅優勢,挑戰咗擴散模型嘅「噪聲中心論」,有機會催生新嘅範式,例如 x‑預測喺視頻/3D 生成上嘅應用。喺實踐層面:極簡設計降低咗上手門檻,開源代碼方便復現,亦適合邊緣設備(如手機圖像生成)。計算效率高:訓練 256 模型只需 8×A100 GPU,600 epochs 約需 1 星期。
挑戰仍然存在:x‑預測喺低噪聲步驟可能需要更強嘅泛化能力,未來可以同多模態方法融合。展望未來,何愷明式嘅作法或會引領「後擴散時代」:由複雜工程回歸到「純數學」。如 X 帖 @jiqizhixin 所言:「JiT 展示咗簡單大塊 Transformer 嘅力量,無需花巧,直接像素生成。」喺生成 AI 嘅軍備賽中,JiT 提醒我哋:創新唔止係擴規模,仲係回到本質。
總結嚟講,JiT 係何愷明「簡化革命」嘅新篇章。佢以 x‑預測同純 Transformer,證明「少即多」——喺高維圖像世界,直接「去噪」勝過迂迴「追噪」。呢個洞見唔單止提升生成質量,仲為 AI 民主化鋪路。未來,JiT 或會成為基準,推動從「噪聲時代」向「乾淨生成」嘅躍遷。