
2026年7月16日到17日,第67屆國際數學奧林匹克(IMO)喺中國上海舉行,經過兩日6道高難度數學題嘅比拼,最終有7位高中選手攞到42/42滿分同金牌,中國同美國分別獲得團體總分第一同第二名。與此同時,喺X上前Google工程師Deedy Das用目前最前沿嘅幾款大語言模型(LLM)對本次比賽做咗真題基準測試,多款模型同樣攞到42/42滿分,標誌住AI喺複雜數學證明領域嘅重大突破。Anthropic嘅Claude Fable 5、OpenAI嘅GPT‑5.6 Pro/Sol、Moonshot AI嘅KIMI K3同Axiom Math嘅AxiomProver等模型喺IMO‑ProofBench等高難度測試中表現出色。呢個成就延續咗AI數學能力由2024年銀牌、2025年金牌到2026年滿分嘅快速進化軌跡,對數學教育、科學研究同AI自身發展有深遠影響。
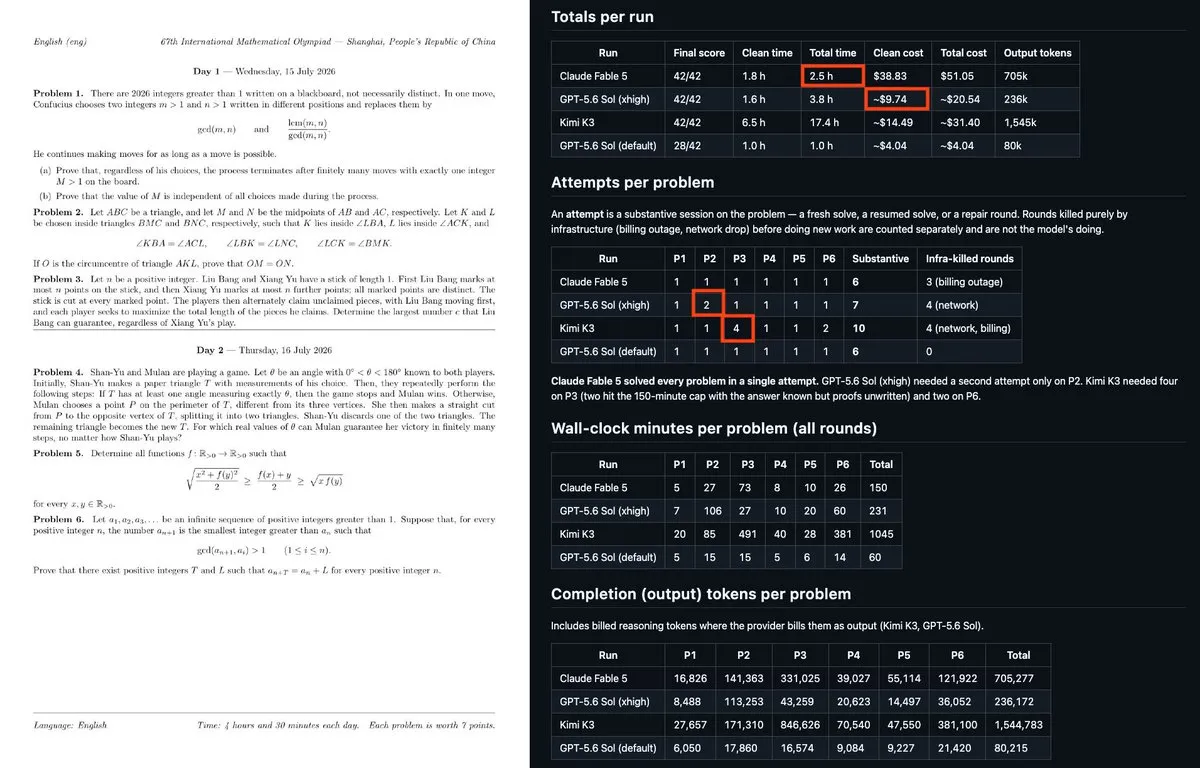
IMO2026真題測試概況
IMO作為全球頂尖高中及以下階段嘅數學競賽,一向以高難度見稱,佢嘅6道證明題對邏輯嚴謹性同創造性要求極高。作為參照,過去七年有4347名學生參賽,只有30人次攞過滿分,佔比只有0.69%。AI基準測試採用2026年嘅真實賽題,透過人工評估同自動化驗證進行評分。多家模型喺完整證明任務中實現零錯誤滿分,證明過程邏輯完整、步驟嚴謹。
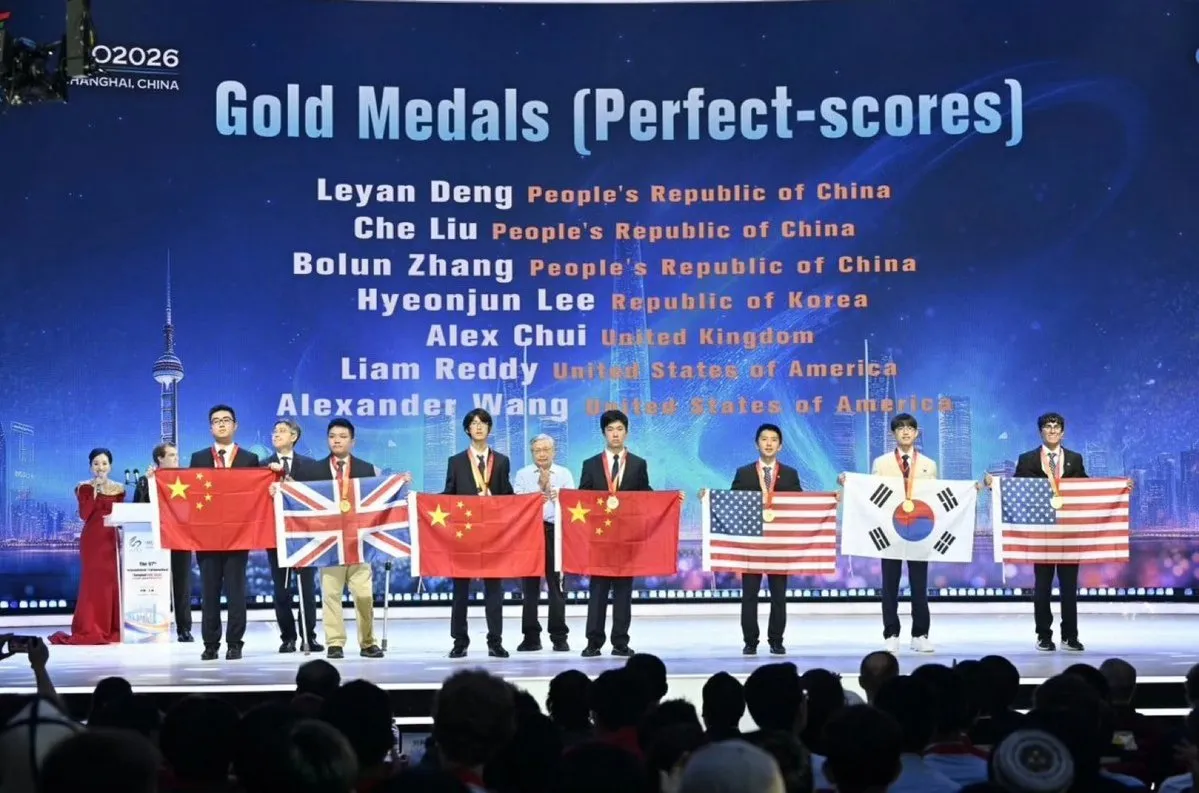
主要滿分模型:
— Claude Fable 5 每題一次就解決,速度最快,總耗時2.5小時,花費51美元。
— GPT 5.6 Sol 比Claude Fable 5多試一次,花費最少,總耗時3.8小時,花費20美元。
— KIMI K3 都全部解咗,但多試咗四次,而且消耗大量token,總耗時17.4小時,花費31美元。
— Axiom Math實際上用Lean(AxiomProver)形式化證明咗所有問題。
根據嘗試次數同Token消耗,P3(第三題)同P6(第六題)最難,其次係P2(第二題)。
參賽學生有9個鐘去解決呢6道題,而Fable同Sol嘅解題時間都喺4小時內。
證明過程對比詳解(以典型IMO證明題為例)
示例題型:一道典型嘅數論或幾何證明題(IMO2026真題類似)。
Claude Fable 5:
- 過程:採用Mythos架構,先進行問題分解,再透過多輪Chain of Thought構建完整邏輯鏈,最後用內部驗證器交叉檢查。輸出結構清晰、步驟嚴謹,幾乎無多餘推導。
- 亮點:創造性解法突出,能提出簡潔新穎嘅證明路徑。
GPT‑5.6 Pro/Sol:
- 過程:先調用外部工具搜索相關定理,再透過Agent式規劃分步求解,最後進行自我驗證。過程較「工程化」,工具調用頻繁但高效。
- 亮點:多步複雜推理能力強,適合需要輔助計算嘅證明題。
KIMI K3:
- 過程:利用2.8T參數嘅MoE架構,喺長上下文窗口中一次過加載所有相關知識,生成整體證明框架,然後細化細節。強調「全局思考」,解法經常有創新角度。
- 亮點:長上下文處理能力強,適合資訊量大嘅幾何題。
AxiomProver:
- 過程:直接將證明步驟轉為Lean 4形式化代碼,互動式驗證每一步正確性,最終輸出人類可讀嘅證明同機器可驗證代碼。
- 亮點:形式化驗證最嚴格,幾乎消除人為錯誤風險。
共同特點:新一代模型單次嘗試準確率顯著提升,減少咗以往「試錯搜索」嘅依賴,推理深度同效率均大幅提高。
實現方法深度解析
- 訓練策略 使用IMO歷年真題、數學論文同合成證明數據進行針對性微調,強化邏輯推理能力。
- 推理技術
- Chain of Thought(CoT)同Tree of Thoughts(ToT)幫助模型系統性探索證明路徑。
- 集成符號計算工具同Lean 4等形式化驗證器確保證明正確性。
- 架構創新 MoE、長上下文注意力機制同專用硬件加速提升效率。
- 安全與對齊 RLHF同憲法AI技術確保輸出嚴謹、無幻覺。
可能影響:數學與AI嘅雙向賦能
1. 對數學教育嘅影響
- 教學輔助革命:AI可提供個性化講解同證明指導,提升學習效率。
- 公平性提升:開源模型令全球學生獲得高質數學資源。
- 挑戰:需防止過度依賴,培養學生原創思考能力。
2. 對科學研究嘅影響
- 加速理論突破:AI輔助猜想驗證同證明生成,縮短研究週期。
- 跨學科融合:數學能力提升推動物理、生物等領域進展。
- 可驗證性要求:AI證明需受人類專家審核。
3. 對AI產業嘅影響
- 能力邊界擴展:滿分成績證明AI抽象推理潛力,推動向AGI邁進。
- 競爭格局變化:中國模型強勢表現加劇全球競賽,促進開源合作。
- 商業應用:數學能力強嘅模型喺金融、優化等領域落地加速。
4. 潛在風險
- 知識產權:AI生成證明嘅歸屬需明確。
- 安全隱患:錯誤證明可能誤導研究。
- 就業影響:數學相關職業面臨轉型。
行業啟示:AI與人類智慧協同發展
多家大模型喺IMO2026真題攞滿分,係AI數學能力嘅歷史性突破。呢個成就得益於大規模訓練、推理技術同硬件優化嘅共同作用,亦側面證明大語言模型(LLM)具備強大嘅數學推理能力。結合近期其他數學家利用LLM進行科研解決重大數學問題嘅報道,LLM正日益成為人類嘅幫手。
對於中國AI企業嚟講,KIMI K3等模型嘅出色表現提供信心。未來需喺開源生態同實際應用上持續發力,由「追趕」邁向「引領」。另外華為官方亦宣布,在日前舉辦嘅 2026 年國際數學奧林匹克競賽(IMO 2026)中,華為小藝(AI 智慧助手)亦以滿分 42 分摘得 IMO 2026 金牌。小紅書(RedNote)技術REDtech 7月22日晚亦發文宣布,小紅書dots‑note 3.0大模型喺真實國際數學奧林匹克競賽(IMO 2026)中,以42分滿分成績攞到金牌,成為首個獲得IMO官方金牌認證嘅中國大模型。呢個亦係繼谷歌Gemini模型之後,全球第二個獲得該成績嘅大模型。
AI喺數學領域嘅突破,將會深刻改變人類知識生產方式。期待更多模型喺真實IMO同科研中展現潛力,推動人類同AI共同探索未知。
信息來源:
Lean (from Axiom): https://github.com/AxiomMath/IMO2026
Fable: https://github.com/deedy/imo‑2026/blob/main/solutions/claude‑fable‑5.pdf
Sol: https://github.com/deedy/imo‑2026/blob/main/solutions/gpt‑5.6‑sol‑xhigh.pdf
Kimi K3: https://github.com/deedy/imo‑2026/blob/main/solutions/kimi‑k3.pdf
Repo: https://github.com/deedy/imo‑2026/blob/main/REPORT.md
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com