
喺人工智能領域,OpenAI 喺 2020 年發布嘅 GPT‑3(Generative Pre‑trained Transformer 3)無疑係一個里程碑。佢以驚人嘅 1750 億(175 billion)參數規模,展示咗大型語言模型嘅強大能力,能喺幾乎毋須額外訓練嘅情況下完成翻譯、寫作、推理等多種任務。呢篇論文《Language Models are Few‑Shot Learners》震撼全球:一個模型竟然可以「少樣本學習」(few‑shot learning),淨係靠幾句提示就有出色表現。
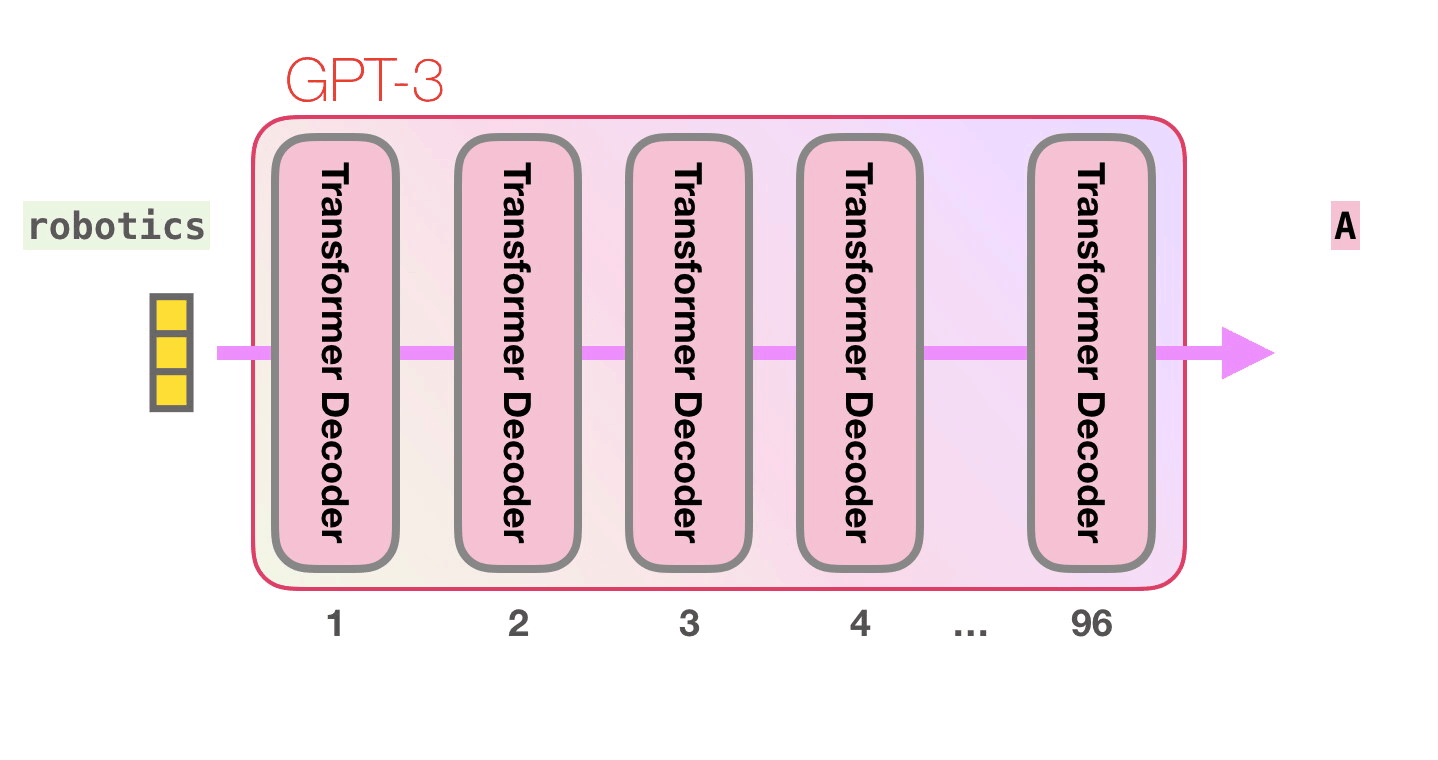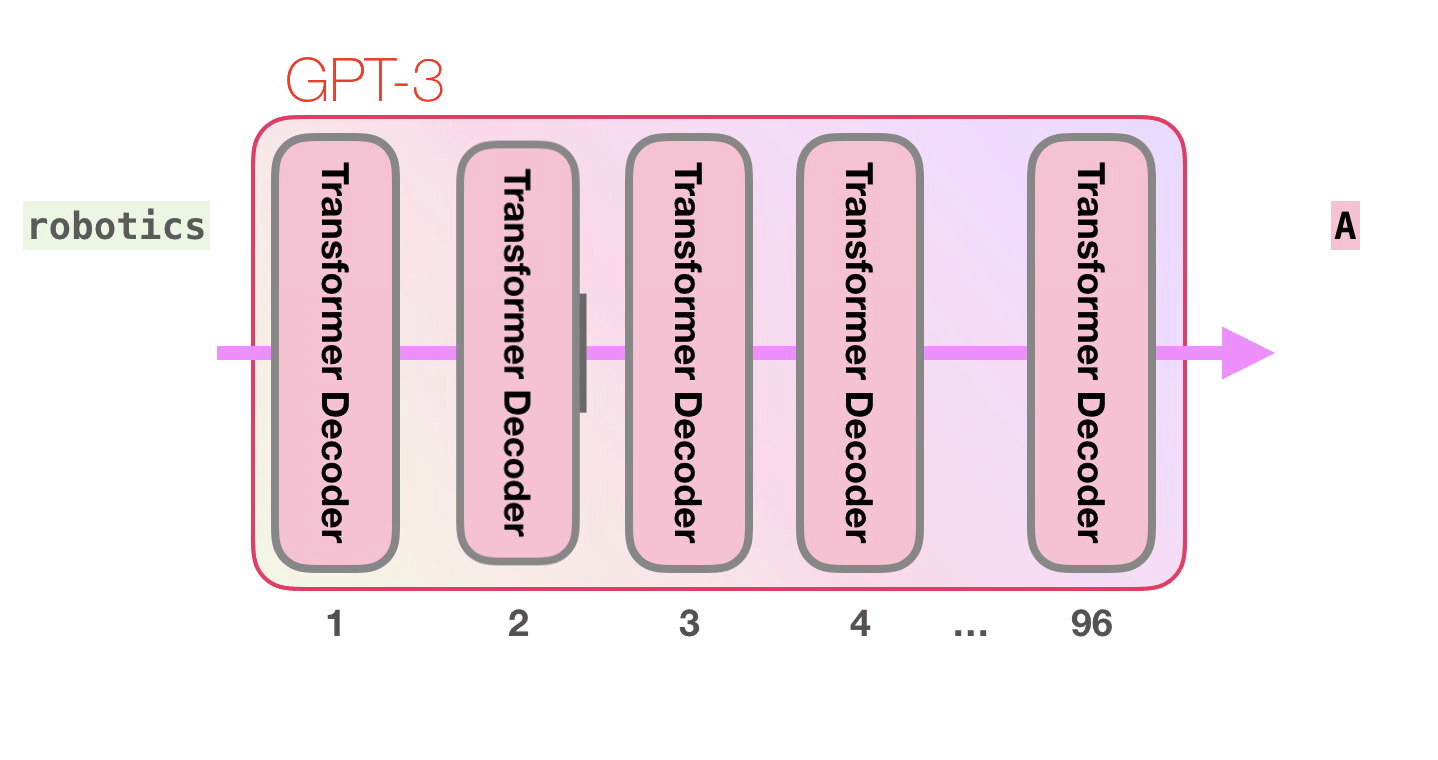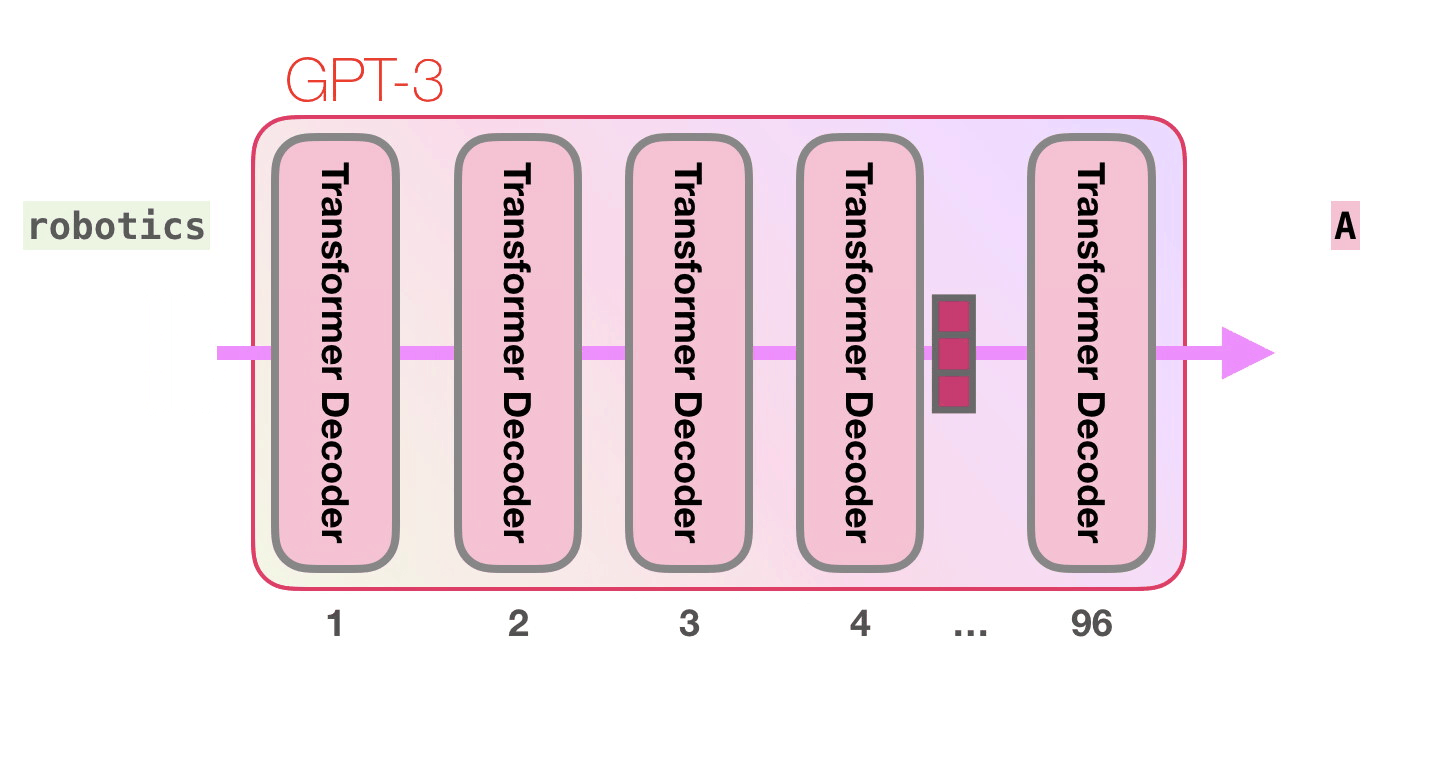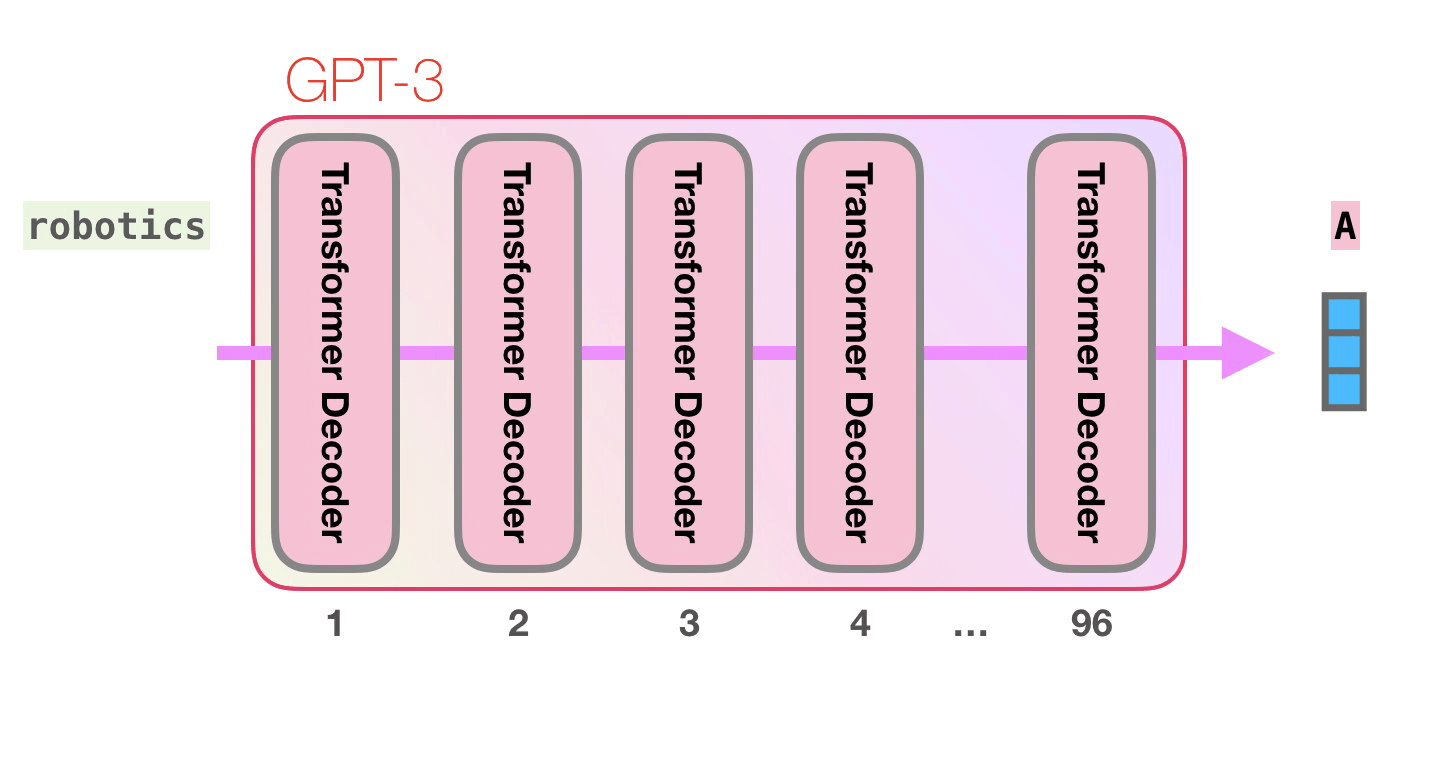
但呢個「1750 億參數」到底係咩?佢唔係神秘嘅黑箱數字,而係模型入面所有可訓練權重嘅總和。呢啲參數主要來自神經網絡嘅權重矩陣同偏置項,經過海量數據訓練優化而成。簡單一句話:1750 億參數 = Transformer 主體(多層注意力與前饋網絡) + 詞嵌入矩陣 + 輸出投影矩陣 + 層歸一化與偏置等小項嘅總和。當中,絕大部分(約 98%)藏喺 96 層 Transformer 塊入面。
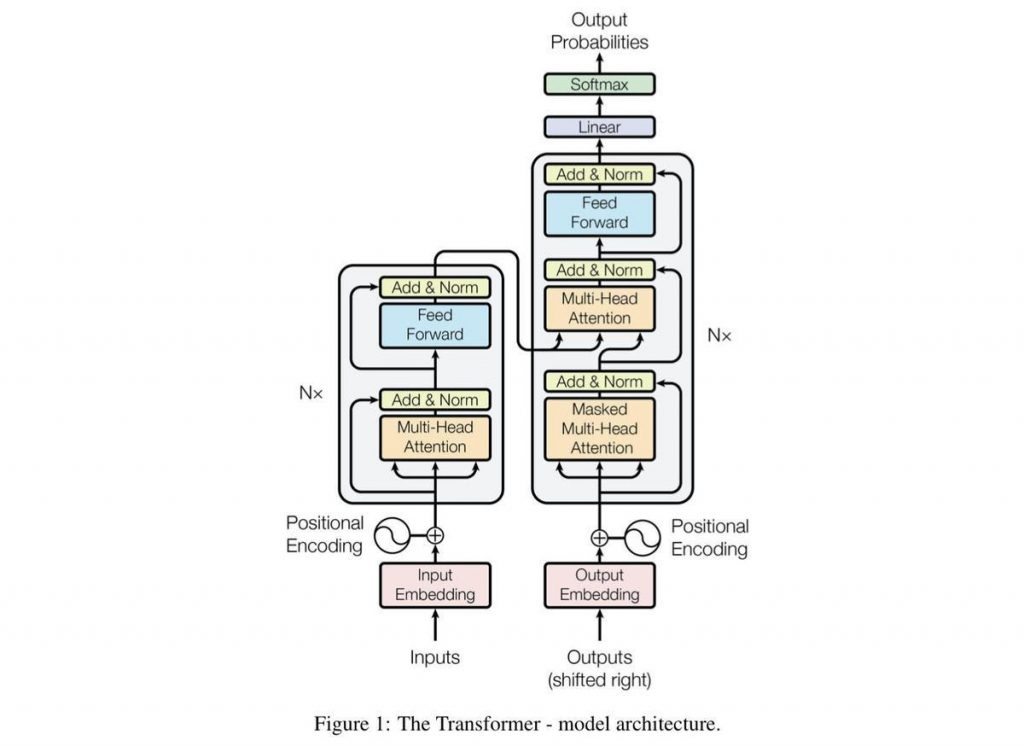
GPT‑3 嘅核心架構:Decoder‑only Transformer
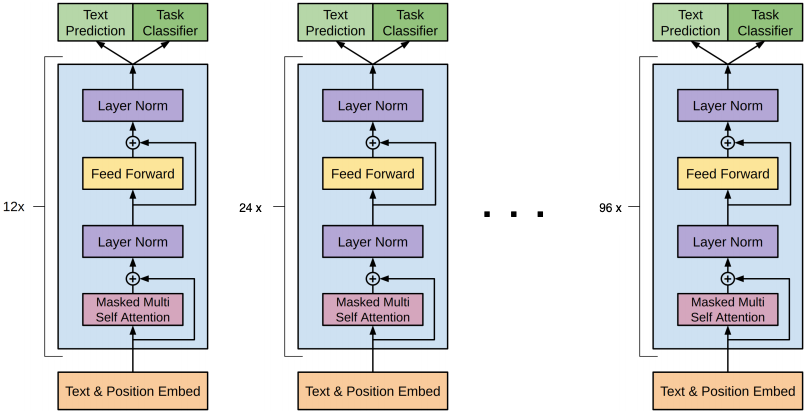
GPT‑3 係基於 Transformer 架構嘅「單解碼器」(decoder‑only)模型,承襲自 GPT‑2,但規模放大咗幾百倍。其最大版本(175B)關鍵超參數如下:
- 層數(Transformer 塊):96 層
- 隱藏維度(d_model):12288(每個 token 嘅向量表示維度)
- 注意力頭數:96 個(每頭維度 128,96 × 128 = 12288)
- 前饋網絡中間維度(d_ff):49152(約 4 × 12288)
- 上下文長度:2048 token
- 詞彙表大小:約 50257(使用 Byte‑Pair Encoding 分詞)
模型結構簡化為:輸入詞嵌入 → 96 層 Transformer 塊 → 輸出投影(生成下一個 token 嘅概率)。
參數來源詳解:一步步計算 1750 億
參數主要分佈喺三個部分,我哋用精確數字計算(基於官方論文同社區驗證):
- 詞嵌入層(Token Embedding)
- 將詞彙表入面嘅每個 token 映射為 12288 維向量。
- 計算:詞彙量 × 隱藏維度 = 50257 × 12288 ≈ 617,558,016(約 6.18 億)
- 此外,仲有位置嵌入(positional embedding):上下文長度 × 隱藏維度 = 2048 × 12288 ≈ 25,165,824(約 0.25 億,通常忽略不計)。
- 占比:約 0.35%(極細部分)。
- Transformer 主體層(96 層核心)
- 呢個係參數嘅「大頭」,每層包括兩個子模組:
- 多頭自注意力(Multi‑Head Self‑Attention) 包含 Query、Key、Value 同 Output 四個投影矩陣。 標準計算:4 × d_model²(因為頭數 × 頭維度 = d_model,等同於 4 個全尺寸矩陣)。 每層:4 × 12288 × 12288 ≈ 603,979,776(約 6.04 億) 加上偏置等小項,約 0.6 億/層。
- 前饋網絡(Feed‑Forward Network, FFN) 兩層線性變換:d_model → d_ff → d_model。 計算:(12288 × 49152) + (49152 × 12288) ≈ 1,207,959,552(約 12.08 億) 加上偏置,約 12 億/層。
- 每層小項:層歸一化(LayerNorm)同偏置,約佔 0.1%,可忽略。
- 單層總參數:注意力 ≈ 6 億 + FFN ≈ 12 億 = 約 18 億。
- 96 層總計:18 億 × 96 ≈ 172.8 億(精確計算約 173.95 億)。
- 占比:約 98‑99%,其中 FFN 占 2/3,注意力占 1/3。
- 輸出層(Language Model Head)
- 將隱藏狀態投影回詞彙表大小,生成下一個 token 嘅概率。
- 喺 GPT‑2 中與嵌入共享權重(tied),參數為 0;但 GPT‑3 並未共享。
- 計算:12288 × 50257 ≈ 617,558,016(約 6.18 億)。
- 占比:約 0.35%。
總和:嵌入 ≈ 6.18 億 + Transformer 層 ≈ 173.95 億 + 輸出 ≈ 6.18 億 + 小項 ≈ 174.56 億 ≈ 1750 億參數(官方四捨五入)。
參數比例大致:Transformer 層占 98%,嵌入 + 輸出占 0.7%,其餘偏置/LayerNorm 微乎其微。

點解參數咁多?背後嘅「縮放定律」
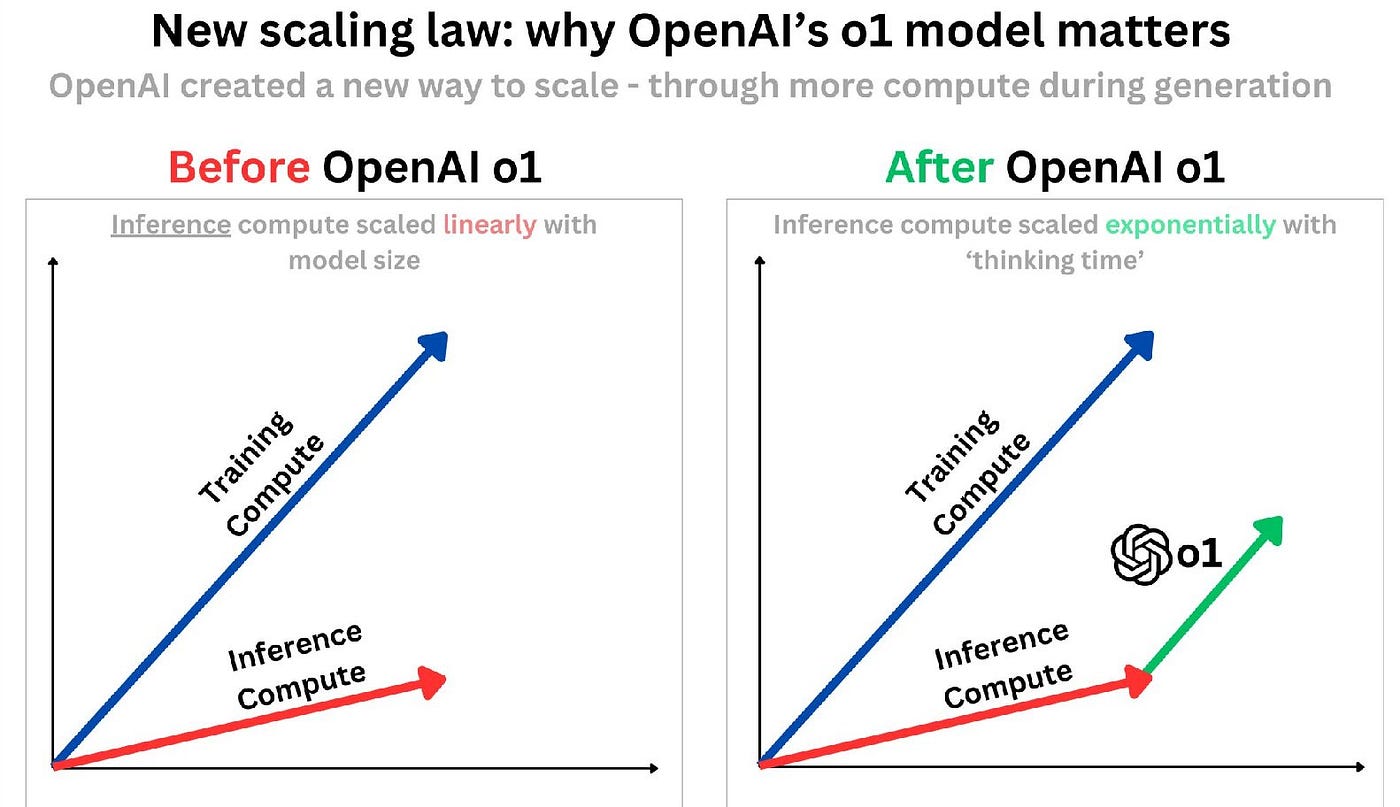
OpenAI 並非隨意揀呢啲數字,而係遵循「縮放定律」(Scaling Laws):模型參數量、數據量同計算量增加時,性能呈幂律提升(power‑law)。由 GPT‑2 嘅 15 億參數跳升到 1750 億,正正係為咗捕捉語言嘅複雜規律,實現「湧現能力」(emergent abilities)——例如毋須微調就可以做少樣本學習。
選擇 12288 維、96 層、96 頭,係計算資源同工程平衡嘅結果:當時用咗數千塊 NVIDIA V100 GPU,訓練耗時數周、成本數百萬美元。再大,就要面臨指數級成本上升。
參數嘅意義:似大腦嘅「突觸」
類比人類大腦(約 100 萬億突觸),呢啲參數係模型嘅「連接強度」。更多參數代表更大「容量」:可以儲存更複雜嘅語言模式、語法、知識同推理路徑。呢就係點解 GPT‑3 喺規模躍升之後,突然具備翻譯、寫詩、簡單算術等能力——規模帶嚟質變。
由於參數係 LLM 嘅核心,現時業界領先嘅閉源 LLM 都冇再公布具體參數值及點樣構成,而開源大模型嘅參數值大多喺幾千億到兩萬億之間,係綜合平衡效率同性能嘅結果。
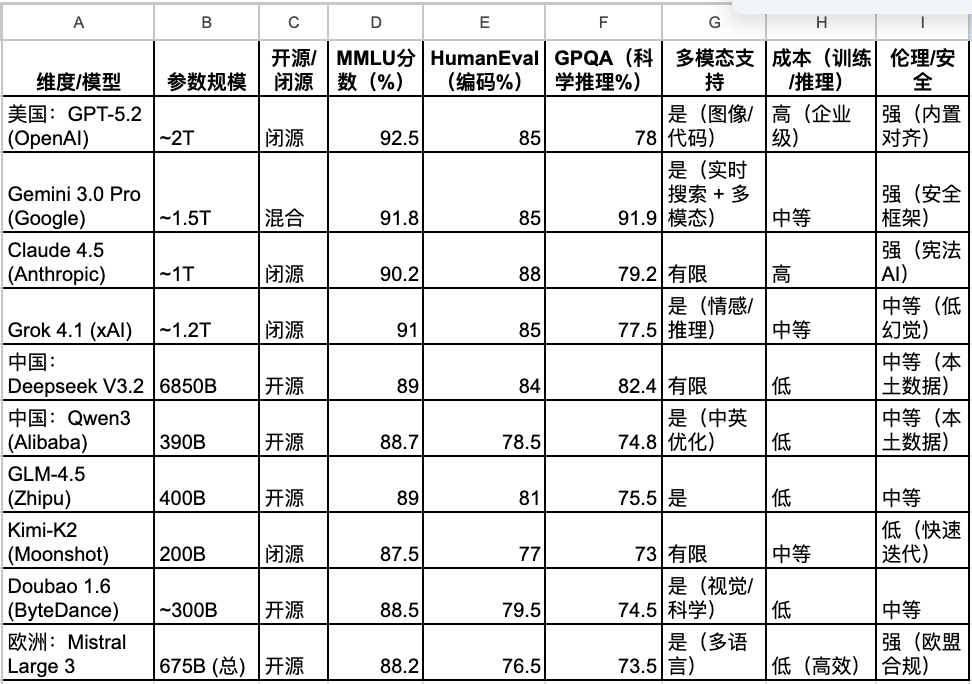
2025年全球十大LLM盤點:美國、中國與歐洲Mistral的全面對比、分析及展望
結語:規模係王道,但唔係唯一
GPT‑3 嘅 1750 億參數證明:單純放大模型,就可以解鎖驚人智能。呢點啟發咗後續模型如 GPT‑4。但而家,我哋亦見到效率優化(例如稀疏模型、量化)嘅重要性。參數雖多,卻大多來自重複嘅 Transformer 層——呢亦係大型語言模型嘅核心秘密。理解呢啲數字,唔單止揭開 GPT‑3 嘅面紗,亦令我哋窺見 AI 未來嘅縮放之路。
▶️ 喜歡呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com