
2026年3月24日,谷歌研究院(Google Research)正式發表TurboQuant算法,呢項先進嘅向量量化壓縮技術係專為大型語言模型(LLM)同向量搜尋引擎設計。核心成果震撼:唔使任何訓練或微調,就可將LLM推理階段嘅關鍵值緩存(KV Cache)內存佔用壓縮至至少6倍(可量化到3比特/值),同時喺NVIDIA H100 GPU上實現最高8倍注意力logits計算加速,且模型下游任務精度零損失。
呢項突破由谷歌研究院科學家Amir Zandieh同副總裁兼 Google Fellow Vahab Mirrokni 領導,相關論文《TurboQuant: Online Vector Quantization with Near‑optimal Distortion Rate》(arXiv:2504.19874)會喺2026年ICLR會議正式發表。佢仲融合咗PolarQuant(AISTATS 2026)同Quantized Johnson‑Lindenstrauss(QJL,AAAI 2025)兩項配套技術,被視為AI效率領域嘅「軟件級革命」。
KV緩存瓶頸:AI推理嘅「隱形殺手」
喺Transformer架構嘅LLM推理中,KV緩存負責儲存之前token嘅鍵(Key)同值(Value)向量,以避免重複計算注意力。隨住上下文長度由數千擴展到數十萬token,KV緩存內存呈線性爆炸式增長,成為制約長上下文、批量推理同邊緣部署最大嘅瓶頸。傳統量化方法雖然可以壓縮,但通常會引入精度損失、額外內存開銷(需儲存歸一化常數),或者依賴特定數據訓練,無法線上即時應用。TurboQuant正係喺呢個背景下,以數據無關(data‑oblivious)、線上(online)方式實現理論上近最優嘅極致壓縮。
原理詳解:PolarQuant高質壓縮 + QJL 1比特殘差校正
TurboQuant嘅核心係兩階段管道,聰明融合隨機旋轉、極坐標變換同Johnson‑Lindenstrauss(JL)變換,實現MSE(均方誤差)同內積失真率嘅雙重近最優,同時消除傳統量化帶嚟嘅內存 overhead。
第一階段:PolarQuant——高質量標量量化(核心壓縮)
算法首先對輸入向量x∈Rd \mathbf{x} \in \mathbb{R}^d x∈Rd施加隨機旋轉(透過高斯矩陣QR分解實現),將座標投影到單位球面。呢一步令每個座標服從已知且集中的Beta分布(高維極限下近似高斯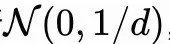 ,座標間近似獨立)。
之後,將座標映射到極坐標系(半徑捕捉幅度,角度捕捉方向),跳過傳統Cartesian量化所需嘅逐數據歸一化步驟(呢步通常需額外1‑2比特儲存常數)。利用Beta分布嘅可預測性,對每個座標獨立應用最優標量量化器(Lloyd‑Max算法,預計算碼本),將向量壓縮到低比特(例如3比特)。
去量化時,只需查表並反旋轉就可以恢復向量。數學上,該階段MSE失真上界為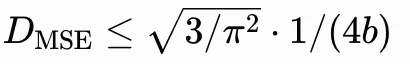 (b為比特數),接近資訊論下界(因子約2.7)。PolarQuant單獨使用已接近無損,特別喺「needle‑in‑a‑haystack」任務中表現優異。
第二階段:QJL——1比特殘差校正(消除內積偏差)
單純MSE量化會引入注意力分數偏差(例如1比特時偏差達2/π 2/\pi 2/π)。TurboQuant因此喺殘差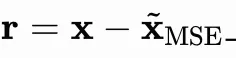 上額外施加量化Johnson‑Lindenstrauss變換(QJL):用1比特(符號位+1/‑1)量化殘差,然後通過特殊無偏估計器恢復內積。
呢一步只耗用1比特,卻完全消除偏差,保證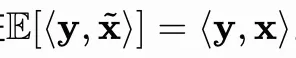 。內積失真同樣接近理論下界。整個過程時間複雜度為O(d),空間開銷極低(碼本預存,常數級),完全適合GPU加速器同線上推理。Arxiv
兩階段協同令TurboQuant喺3比特下實現「零精度損失」,遠超傳統Product Quantization(PQ)或KIVI等方法,且無需數據集調優或預處理。
實驗驗證:真實世界零妥協
喺Gemma、Mistral、Llama‑3.1‑8B等開源模型上,TurboQuant經受LongBench、Needle‑in‑Haystack(4k‑104k token)、RULER、ZeroSCROLLS等嚴苛長上下文基準考驗:
- 內存壓縮:KV緩存降至至少6倍(3比特/值),Llama‑3.1‑8B喺0.25內存預算下仍達完美recall。
- 速度提升:4比特模式下,H100 GPU注意力計算較32比特基線提速最高8倍,整體推理快過原始模型,運行時開銷可以忽略。
- 精度:問答、代碼生成、摘要任務零損失;向量搜尋(GloVe數據集)recall@1@k優於PQ/RabbiQ,且索引時間接近零(0.0007‑0.0021秒 vs 數十秒)。
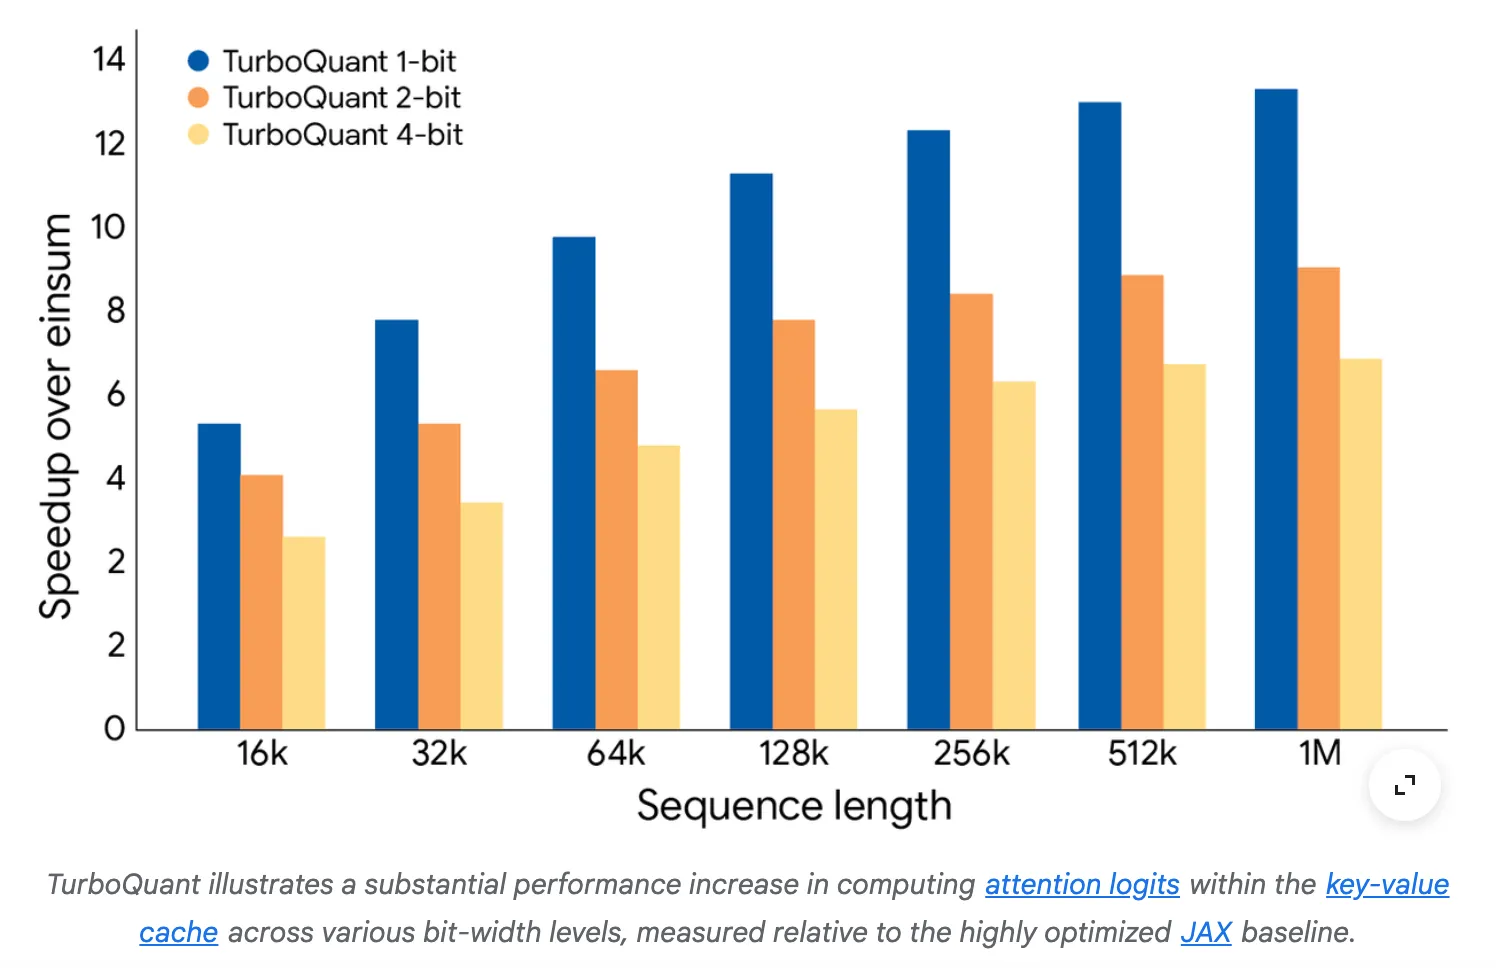
深遠影響:AI部署範式重塑與產業連鎖反應
1. 推理效率與成本革命
企業可顯著降低雲算力開支——相同硬件可以支持更長上下文或更大批量,VentureBeat分析認為部署成本有望下降50%以上。RAG(檢索增強生成)、長文檔處理等場景將迎嚟爆發式應用。
2. 硬件需求與邊緣化部署
軟件優化直接紓緩HBM(高帶寬內存)壓力,內存供應商(如Micron、Western Digital)股價喺公告後短期受壓。將來,消費級設備(例如Mac Mini)或手機都可能高效運行十萬token級模型,推動AI由雲端走向本地私隱部署。
3. 向量搜尋與搜索體驗升級
索引構建速度大幅提升,谷歌可以更高效實現語義搜尋,從關鍵詞向意圖理解躍遷,對整個搜索引擎產業構成示範。
4. 行業格局與倫理考量
TurboQuant開源可用(研究框架下免費),加速開源社區同企業落地,但亦凸顯「算法效率」正成為AI競爭新賽道。長期嚟講,佢有助AI可持續發展,降低能耗同碳足跡;短期則可能重塑GPU/內存供應鏈。谷歌計劃將其擴展到Gemini等自家模型,進一步放大影響。
結語:AI效率嘅「軟件核聚變」
TurboQuant唔係簡單嘅量化,而係用嚴謹數學(Beta分布、無偏估計、近最優失真界)重構向量壓縮範式,徹底破解「內存‑精度‑速度」三難。佢證明:即使喺後訓練時代,純算法創新仍然可以帶嚟指數級效率飛躍。將來,隨住更多模型整合呢項技術,AI會真正邁向「人人可用、處處可及」嘅普惠階段——更低門檻、更高性能、更可持續。
谷歌此舉再次確立其喺AI基礎研究領域嘅領先地位,亦為全球開發者提供咗免費利器。TurboQuant嘅落地,可能會成為2026年AI基礎設施演進中最重要嘅里程碑之一。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com