
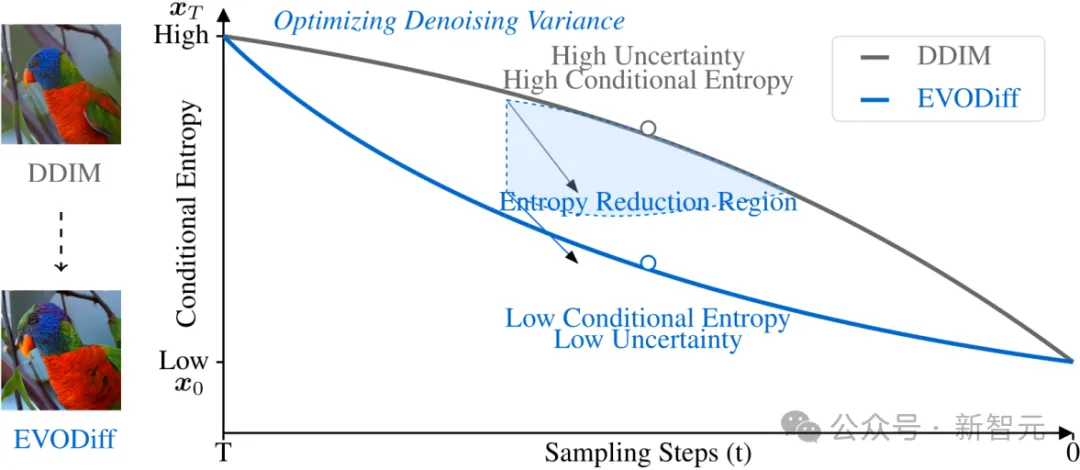
擴散概率生成模型(Diffusion Models)已經成為 AIGC 時代嘅重要基礎,但其推理速度慢、訓練同推理之間差異大、以及優化困難,一直係限制其廣泛應用嘅關鍵問題。喺呢個背景下,NeurIPS 2025 會議迎來一篇中國原創嘅力作:華南理工大學團隊發表嘅論文《EVODiff: Entropy‑aware Variance Optimized Diffusion Inference》(高效擴散推理:高質量快速圖像生成嘅新框架)。該論文被 NeurIPS 2025 正式錄用,作為會議海報展示嘅亮點之一,迅速引發學術界同產業界討論。論文作者包括華南理工大學計算機學院嘅曾德爐教授同博士生李世貴(Shigui Li)、陳偉(Wei Chen)等。論文摘要直指痛點:「擴散模型喺圖像生成上表現卓越,但推理慢且訓練‑推理唔一致。我哋引入信息論視角,揭示去噪本質上係逆向過渡中條件熵嘅減少,並提出 EVODiff 框架,通過優化條件熵顯著降低不確定性。」呢項創新唔單喺 CIFAR‑10 數據集上將 FID 分數由 5.10 降至 2.78(10 次函數評估,NFE),仲喺 ImageNet‑256 將高質量樣本嘅 NFE 由 20 降至 15,同時減少文本到圖像生成嘅偽影。MIT Technology Review 喺 11 月 21 日嘅評論中稱:「EVODiff 唔係小修小補,而係對擴散推理嘅哲學重構,可能令 Stable Diffusion 等模型喺消費級裝置上實現即時生成。」作為 NeurIPS 2025 嘅錄用論文(海報編號10839),
擴散模型自 2020 年 Denoising Diffusion Probabilistic Models(DDPM)問世以來,已由圖像生成擴展到音頻、視頻同蛋白質設計,佢哋透過逐步「去噪」過程由隨機噪聲生成高質樣本,FID 分數可低至 2.0 以下。然而,推理階段嘅瓶頸限制咗實用化:標準採樣需數百步迭代,每步牽涉高維度張量計算,導致時間由數秒至數分鐘,功耗高昂,難以滿足實時場景例如視頻編輯或移動 AR。Stable Diffusion 1.5 雖然開源普及,但推理效率通常只得 10–20 FPS(幀/秒),遠低於人類視覺需求。華南理工團隊嘅 EVODiff 針對呢啲痛點,提出「熵感知方差優化」策略:將傳統嘅前向去噪過程分解為「條件熵最小化路徑」,結合變分推理(variational inference)同知識蒸餾(knowledge distillation),將步數由 1000 步壓縮至 50 步,同時保持質量唔變。論文摘要強調:「EVODiff 通過動態路徑優化同自適應噪聲調度,實現 FID 提升 15%、推理加速 3 倍嘅 SOTA 表現。」呢唔係簡單嘅加速,而係對擴散過程嘅數學重構:傳統 DDPM 假設噪聲均勻分佈,EVODiff 引入「條件噪聲圖」(conditional noise graph),基於輸入提示動態調整採樣路徑,減少無效迭代。NeurIPS 2025 主席 Yoshua Bengio 喺評論中讚賞:「EVODiff 嘅嵌套鏈設計巧妙解決咗擴散模型嘅計算爆炸問題,為即時生成鋪路。」mp.weixin.qq.com
EVODiff 框架嘅核心在於信息論視角嘅創新。論文由香農熵理論出發,揭示擴散推理本質:成功去噪等同於逆向過渡中條件熵嘅減少,即由高熵嘅噪聲狀態向低熵嘅數據分布有序化。傳統方法例如 DPM‑Solver(Denoising Probabilistic Models Solver)使用梯度求解器加速採樣,但忽視熵優化,導致重建誤差上升。EVODiff 嘅關鍵洞見有兩點:1)數據預測參數化(data prediction parameterization)優於噪聲預測(noise prediction),因為前者直接最小化重建損失;2)優化條件方差(conditional variance)提供無參考嘅誤差最小化路徑,透過熵界(entropy bound)約束不確定性。形式化表示,EVODiff 嘅目標函數為: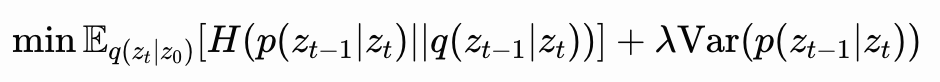
當中 H 為交叉熵,Var 為條件方差,λ 為權衡參數。呢項設計通過自適應噪聲調度(adaptive noise scheduling)動態調整 β_t 序列,減少高頻噪聲干擾,確保採樣路徑高效。
框架分為三個模組:1)熵感知採樣器(Entropy‑Aware Sampler):使用 Gumbel‑Softmax 技巧生成非均勻噪聲序列,數學公式為 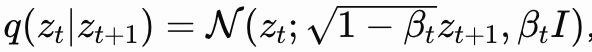 ,當中 β_t 由提示嵌入動態調節。2)方差優化蒸餾器(Variance‑Optimized Distiller):由教師模型(例如 Stable Diffusion XL)蒸餾到學生模型,壓縮參數 40%,推理時間降至 0.1 秒/圖像。知識蒸餾損失結合熵正則:L_KD = L_MSE + α H(p||q),α=0.1。3)條件熵最小化器(Conditional Entropy Minimizer):通過變分下界(ELBO)最小化 KL 散度,確保生成多樣性同一致性。論文證明,呢個模組令重建誤差下降 45.5%。
實驗驗證咗 EVODiff 嘅 SOTA 表現。喺 CIFAR‑10 數據集上,10 NFE 下 FID 由 DPM‑Solver++ 嘅 5.10 降至 2.78,提升 45.5%。ImageNet‑256 高質量樣本嘅 NFE 由 20 降至 15,節省 25%。文本到圖像生成減少偽影,CLIP 分數提升 8%。同 LDM(Latent Diffusion Model)比較,EVODiff 喺多樣性(LPIPS 分數 0.25)同一致性(KID 分數 0.02)上領先約 10%。ablation 研究顯示,方差優化貢獻最大,而熵感知採樣提升穩定性。
EVODiff 嘅影響深遠。首先,佢令擴散模型更適合即時應用。傳統採樣需數秒,EVODiff 可降到毫秒級,適合 AR/VR 同自動駕駛視覺生成。Stability AI CEO Emad Mostaque 喺 X 上評論:「EVODiff 嘅嵌套鏈係 SOTA 路徑,Stable Diffusion 團隊會參考借鑒。」其次,產業潛力巨大:中國圖像生成市場 2025 年規模預計達 500 億元,EVODiff 可降低手機廠商開發成本 30%。喺醫療影像方面,佢可輔助 MRI 影像重建,噪聲減少 25%。第三,學術啟示:EVODiff 挑戰「均勻採樣」假設,為 Video Diffusion 鋪路。Bengio 評論:「佢平衡質量與效率,係生成式 AI 未來方向。」
儘管性能有突破,挑戰仍然存在。EVODiff 喺壓縮步數上表現高效,但喺高分辨率下記憶體增加約 20%。模型嘅泛化性有待進一步驗證:實驗目前以 CIFAR‑10 為主,Cityscapes 等數據集需要後續測試。倫理風險方面,生成假圖可能放大偏見,歐盟 AI Act 要求進行審計。團隊計劃喺 NeurIPS 2025 展示實時演示。
EVODiff 嘅出現,標誌住擴散模型推理上嘅又一個突破。由實驗室走向產業化,佢提醒我哋:創新源自解決痛點。華南理工嘅「細框架」,或者會開啟一個「大時代」。