
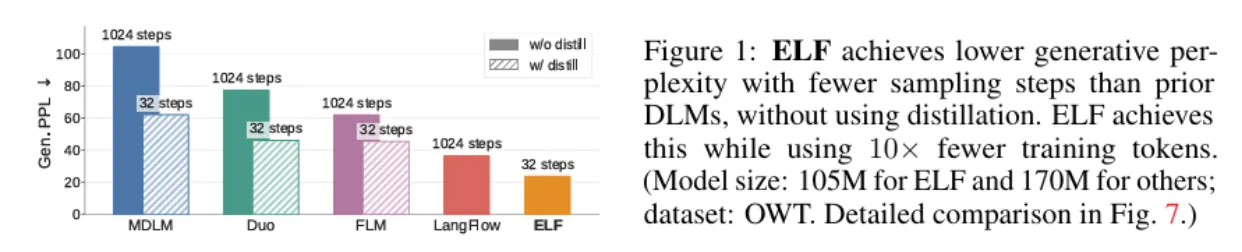
2026年5月11日,MIT何愷明(Kaiming He)團隊喺arXiv發表論文《ELF: Embedded Language Flows》,提出一種全新嘅連續擴散語言模型(Continuous Diffusion Language Model)。核心模型ELF‑B只用105M參數、喺45B訓練token上訓練、用32步採樣,喺OpenWebText基準將生成困惑度(Generative Perplexity)壓低到24,明顯超越多款主流離散同連續擴散語言模型(DLM),包括MDLM、Duo、FLM同LangFlow等。呢項成果即刻引起業界關注,被視為擴散模型喺語言領域嘅一個重要突破,亦為挑戰GPT式自回歸主導地位提供新路徑。
何愷明作為ResNet、MAE(Masked Autoencoders)等電腦視覺經典工作嘅提出者,今次成功將視覺領域成熟嘅擴散與流匹配技術遷移到語言生成,充份顯示跨領域研究嘅強大創新力。
ELF核心創新:由「離散」到「連續嵌入空間」
傳統擴散語言模型(DLM)多喺離散token空間操作,面臨梯度不連續、採樣步數多等問題。ELF嘅核心創新係將擴散過程主要放喺連續嵌入空間,直到最後一步先用共享權重嘅網絡映射返離散token。
具體設計包括:
- 基於連續時間流匹配(Continuous‑time Flow Matching):喺嵌入空間做平滑嘅流轉換,避免離散噪聲預測嘅複雜性。
- 共享權重去噪‑解碼器:大幅減少參數量(ELF‑B由潛在嘅148M降到105M)。
- 上下文條件注入(In‑context Conditioning):高效整合時間步、CFG尺度等條件,唔需要額外嘅 adaLN‑Zero 模組。
- 分類器自由引導(CFG):直接承襲圖像擴散成熟技術,提升生成質量同可控性。
實驗顯示,ELF‑B喺相同計算預算下,生成質量同多樣性均優於參數量更大嘅基線模型。團隊亦測試咗ELF‑M(342M)同ELF‑L(652M),證明模型有良好可擴展性——規模放大時生成困惑度進一步下降,同時文本多樣性提升。
訓練數據解析:45B tokens嘅構成與高效利用
ELF模型嘅訓練數據規模係45.2B tokens,遠低於主流大語言模型動輒數千億到數萬億token嘅規模。其數據主要來源係經典嘅OpenWebText(OWT)數據集。
具體構成如下:
- OpenWebText原始規模約9.04B tokens,主要包含Reddit上高讚連結對應嘅網頁文本,包括新聞、論壇討論、博客文章、百科式內容等,屬於質量相對較高嘅通用互聯網文本。
- 團隊喺該數據集上做咗5個epochs(完整遍歷5輪)訓練,因而達到45.2B tokens嘅有效訓練量。
點解ELF只用45B tokens就可以取得領先,而主流LLM要幾千億甚至幾十萬億tokens?
呢個係ELF論文最值得關注嘅亮點之一,主要原因包括:
- 任務目標差異:ELF專注於無條件文本生成任務(由噪聲生成連貫自然文本),唔係追求通用智能、指令跟從同複雜推理,因此對數據量嘅需求遠低於需要掌握海量世界知識嘅自回歸LLM。
- 架構效率革命:連續嵌入空間 + Flow Matching 呢種設計大幅提升數據利用效率。傳統離散擴散模型通常需要500B+ tokens先到較好效果,而ELF只用大約1/10嘅數據就能超越。
- 小模型特性:ELF‑B僅105M參數,小規模模型本身對數據量需求較低,加上共享權重等優化,進一步放大數據效率。
- 實驗設定聚焦:論文目標係證明「連續擴散喺語言領域可行且高效」,所以揀咗標準DLM基準,而唔係全面通用能力測試。
值得注意嘅係,團隊喺實驗中觀察到,喺OWT上訓練5個epochs之後,繼續增加數據帶來嘅邊際收益已明顯遞減。呢點說明ELF喺目前設定下已接近數據效率嘅上限。
未來可唔可以增加訓練語料?
答案係完全可行而且潛力巨大。論文已通過ELF‑M同ELF‑L版本展示咗良好嘅規模擴展性。若未來轉去更大、更多元嘅高質量數據集(例如The Pile、RefinedWeb、書籍、程式碼、科學文獻混合語料),ELF喺知識覆蓋度、長文本一致性、指令跟從等能力上仍有明顯提升空間。開源代碼已喺GitHub發布,社區完全可以基於更大語料繼續預訓練,為後續發展留低充足想像空間。
性能表現與自回歸模型嘅範式對比
喺OpenWebText基準測試中,ELF‑B以顯著優勢超越咗此前主流擴散語言模型。喺多樣性指標上亦表現出色,避免咗擴散模型常見嘅模式崩潰問題。
相比GPT式自回歸模型,ELF採用並行擴散生成而唔係「左到右」自回歸預測。呢種做法帶來理論上嘅全局一致性優勢同並行計算潛力,有望減少累積誤差同暴露偏差(Exposure Bias)。不過,目前ELF仍處於基礎研究階段,主要驗證無條件生成能力,喺指令跟從、多輪對話等實用場景上仍需進一步發展。
對AI研究與產業嘅深遠影響
1. 推動生成模型範式多元化
長期以來,語言生成幾乎被自回歸Transformer主導。ELF嘅成功證明擴散模型喺語言領域可行且具競爭力,有望激發更多非自回歸(Non‑autoregressive)同混合架構嘅研究,豐富AI模型嘅「物種多樣性」,為唔同應用場景提供更合適選擇。
2. 顯著降低AI門檻,實現技術民主化
僅105M參數、45B tokens嘅訓練成本遠低於主流大模型。呢點為學術機構、中小企業同開源社區提供咗高性能基礎模型,有力推動AI技術嘅普惠發展。開發者可以喺普通硬件上複現同微調類似模型,加速創新迭代。
3. 促進跨領域技術融合
ELF成功將電腦視覺嘅擴散技術遷移到語言,強化咗「統一生成模型」嘅趨勢。未來,多模態大模型可能更自然咁融合文本、圖像、影片生成能力,何愷明團隊嘅跨界經驗具有重要示範意義。
4. 計算資源與綠色AI嘅正面意義
喺AI訓練能耗備受關注嘅今天,ELF展示咗「小模型+高效架構」嘅可行路徑。呢可能引導行業由單純追求參數規模轉向架構效率同數據效率嘅競賽,推動更可持續嘅AI發展。
5. 商業與應用前景
對開源社區嚟講,ELF提供咗一個高效嘅生成基礎;對產業界嚟講,佢為創意寫作、並行內容生成、個性化教育等場景提供新工具。長遠來講,若擴散語言模型喺長文本、創意多樣性同可控性上超越自回歸模型,將可能重塑內容生成市場嘅競爭格局。
挑戰與未來展望
雖然成果吸引,ELF仍有局限:目前主要驗證無條件生成,指令跟從、長上下文理解、多輪交互等能力仍需加強;採樣步數雖優化到32步,但距即時互動仍有距離;同GPT‑4、Claude等超大規模模型嘅全面對比亦未充分。
未來,隨住訓練數據擴展、指令微調同多模態融合,ELF系列模型有望由學術原型走向實用工具。何愷明團隊嘅呢項工作再次證明:創新唔一定來自更大規模,而往往來自更巧妙嘅設計。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com