
2026年2月4日,MIT同Harvard聯合團隊喺arXiv上發佈咗題為《Generative Modeling via Drifting》(透過漂移實現生成建模)嘅最新論文(arXiv:2602.04770)。論文由Mingyang Deng、He Li、Tianhong Li、Yilun Du同Kaiming He(何恺明)共同完成,提出咗一種全新嘅生成建模範式——Drifting Models(漂移模型)。呢種方法將傳統擴散模型同流模型喺推理階段需要反覆迭代嘅「分布匹配」過程,徹底前移到訓練階段,從而實現真正意義上嘅高質量單步(one‑step)生成。
論文喺ImageNet 256×256數據集上取得咗令人震驚嘅成績:喺潛在空間(latent space)FID達到1.54,像素空間(pixel space)FID達到1.61,單步生成質量超越此前所有單步生成器,並喺部分指標上接近甚至超越多步擴散模型。呢個成果被社群迅速稱為「生成模型領域嘅範式轉變」,標誌住AI生成技術由「多步迭代」向「單步高效」嘅關鍵跨越。
傳統生成模型嘅痛點:推理階段嘅迭代瓶頸
而家主流嘅生成模型(例如擴散模型Diffusion、流模型Flow‑based、GAN等)本質上都係學一個由噪聲分布到數據分布嘅「推前映射」(pushforward map)。但係,呢啲模型普遍存在一個根本問題:訓練時學到係固定映射,但推理時卻要靠多步迭代去逐步逼近目標分布。
擴散模型需要數百甚至上千步去噪,流模型雖然可以單步但訓練極其困難,GAN雖然單步快但模式崩潰問題突出。呢種「訓練——推理唔對稱」導致生成效率低、計算成本高、實時性差等問題。特別係喺需要高分辨率、複雜語義或者實時互動嘅場景(例如視頻生成、機器人控制、互動式設計),多步迭代成為難以忍受嘅瓶頸。
論文作者喺摘要中直指呢個痛點:「生成建模可以表述為學習一個映射f,使其推前分布匹配數據分布。但現有方法要麼喺推理時需要迭代,要麼訓練極不穩定。我哋提出Drifting Models,喺訓練過程中動態演化推前分布,從而自然地支持單步推理。」
Drifting Models核心思想:訓練時「漂移」,推理時「一步到位」
Drifting Models嘅核心創新係將分布演化過程由推理時間前移到訓練時間。
喺傳統方法中,模型學一個固定映射f:噪聲 → 數據,需要喺推理時反覆應用f(或其逆)去逐步漂移樣本。Drifting Models就係喺訓練過程令映射本身產生「漂移」(drift):模型唔再學一個靜態嘅f,而係學一系列逐步演化嘅映射f_t,呢啲映射喺訓練唔同階段推動分布由簡單噪聲逐漸「漂移」到複雜數據分布。
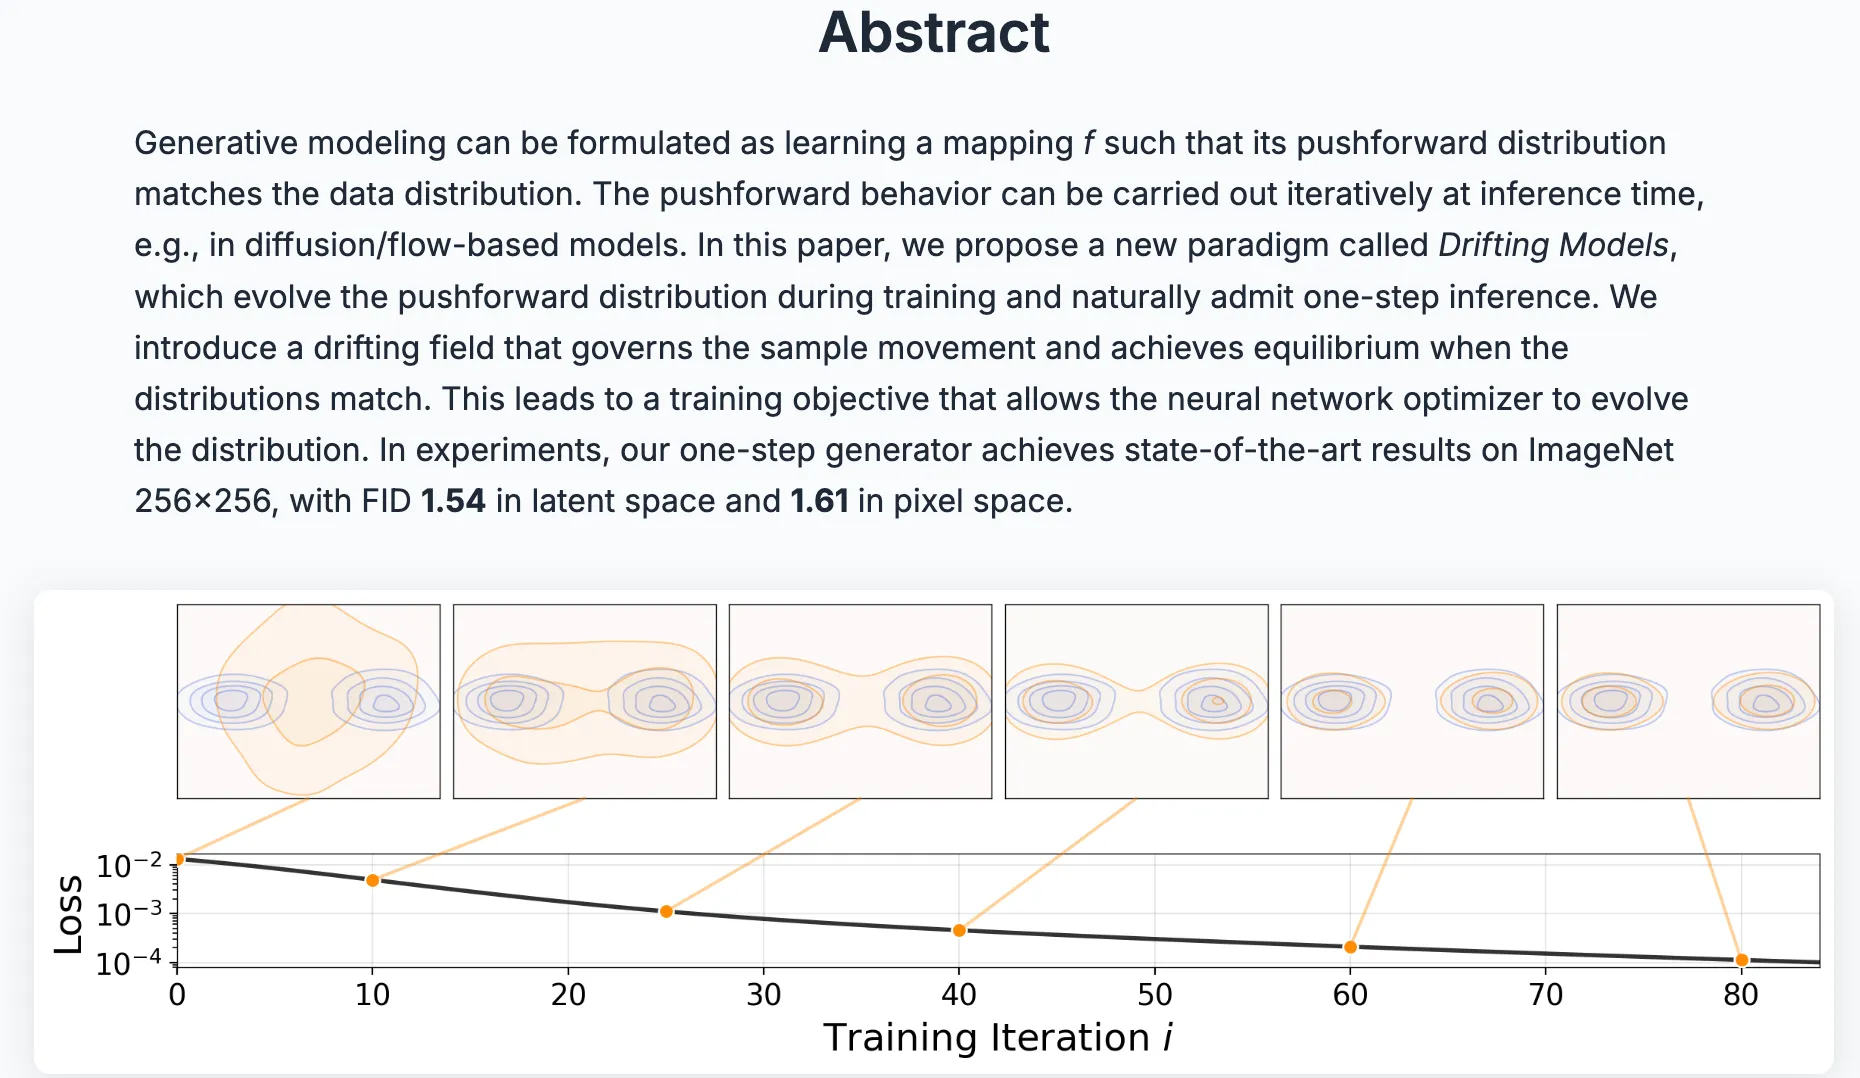
具體嚟講,作者引入咗一種漂移損失(Drifting Loss),通過特徵編碼器(feature encoder)喺多個尺度上計算當前生成分布同真實數據分布之間嘅「漂移方向」,再用呢個方向指導模型參數更新。訓練過程中,模型嘅推前分布不斷向數據分布「漂移」,最終收斂時,模型已經學會一個可以直接由噪聲映射到高質量數據嘅單步函數。
如論文圖1所示,Drifting Models嘅訓練過程可視化為一條動態演化嘅「漂移軌跡」:早期階段分布簡單、噪聲主導,晚期階段分布複雜、細節豐富,整個過程喺推理時無需重複迭代。
論文仲設計咗多尺度特徵漂移損失(Multi‑scale Drifting Loss),如圖3所示,喺ResNet嘅唔同階段提取特徵圖,對每個特徵獨立計算核函數(kernel)、漂移向量同損失,最後加權求和。呢種設計大幅提升咗模型對細粒度紋理同高層語義嘅捕捉能力。
實驗結果:ImageNet單步生成SOTA,機器人任務亦表現出色
喺標準基準ImageNet 256×256上,Drifting Models取得咗目前單步生成器最佳成績:
- 潛在空間FID:1.54(此前最佳單步模型約2.1–3.5)
- 像素空間FID:1.61
- 單步生成:只需一次前向傳播(one neural function evaluation)
如論文圖4同圖5所示,Drifting Models生成嘅圖像喺細節、連貫性同多樣性上均顯著優於此前單步方法,與多步擴散模型(例如DiT、SiT)相比,質量差距已大幅縮窄,同時速度提升數十倍。
更令人驚喜嘅係,Drifting Models喺非圖像任務上亦展現出強大泛化能力。論文喺機器人控制任務中測試咗模型嘅漂移機制,結果顯示喺連續控制同軌跡規劃上嘅表現優於傳統強化學習基線,證明「漂移範式」對連續動態系統嘅適用性(見論文圖7機器人實驗結果)。
作者仲比較咗唔同預訓練特徵編碼器(MAE、DINOv2等),結果顯示定制MAE編碼器喺漂移損失計算中表現最好,進一步驗證咗方法嘅魯棒性。
與現有範式嘅對比:由「迭代」到「漂移」嘅範式轉變
Drifting Models同現有生成模型形成鮮明對比:
- 擴散模型:推理多步、訓練穩定,但速度慢。
- 流模型:可單步,但訓練難度極大,對架構要求高。
- GAN:單步快,但模式崩潰同訓練不穩定問題突出。
- Drifting Models:訓練時動態漂移,推理單步,兼顧穩定性同效率。
論文作者Kaiming He(何恺明)團隊長期深耕視覺同生成領域,今次提出嘅Drifting範式,被視為對「生成即映射」經典觀點嘅重新定義。社群迅速跟進討論,認為呢項工作為解決生成模型嘅「效率—質量權衡」提供咗全新思路。
潛在影響與未來方向
Drifting Models嘅出現,對AI生成領域有多重深遠意義:
- 實時生成落地:單步高質生成將大幅推動實時視頻、互動式設計、遊戲內容生成等應用落地。
- 計算效率革命:推理成本大幅下降,有望令高性能生成模型喺消費級設備上運行。
- 機器人與具身智能:漂移機制天然適合連續動態系統,可能加速具身AI發展。
- 理論啟發:將分布演化顯式建模到訓練過程,為生成模型提供新嘅數學框架。
論文亦坦承目前局限:漂移損失對特徵編碼器敏感,喺極高分辨率(例如1024²)上嘅表現仍有提升空間,未來可以結合更先進嘅編碼器或混合漂移策略進一步優化。
作者已喺項目頁面宣布,會好快開源ImageNet訓練代碼同預訓練模型,供社群復現同擴展。
結語:生成模型嘅「漂移」時代
《Generative Modeling via Drifting》提出嘅Drifting Models範式,用簡潔而深刻嘅方式重構咗生成建模嘅核心邏輯:唔再令模型喺推理時「一步步行」,而係令佢喺訓練時「一步步漂移」。呢個轉變唔單帶嚟單步生成質量嘅飛躍,仲為AI理解同創造複雜分布開闢新路徑。
喺2026年AI技術快速演進嘅時候,Drifting Models嘅出現提醒我哋:真正強大嘅生成能力,可能唔係靠更深嘅網絡或者更多參數,而係來自對分布演化過程嘅深刻洞察。當生成模型由「迭代模擬」走向「漂移塑造」,AI創作嘅效率同創意邊界將再度被打破。
呢項工作由Kaiming He團隊同MIT‑Harvard合作完成,再次彰顯咗中國學者喺國際頂級AI研究中嘅影響力。未來,隨住代碼開源同社群跟進,我哋有望見到Drifting範式喺視頻生成、3D內容、機器人控制等更多領域嘅精彩應用。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎訂閱我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請瀏覽:https://www.airosetta.com