
2026年4月17日,經過多篇論文鋪墊及用戶千呼萬喚之後,中國 AI 初創公司 DeepSeek 正式發佈備受期待嘅 DeepSeek V4,呢款係該公司繼 V3 系列之後嘅又一款重量級開源大模型。該模型採用約 1.6 萬億參數嘅 MoE(Mixture of Experts)架構,喺 SWE‑Bench Verified 等編碼基準上取得領先成績,被業內視為國產開源模型喺編程能力方面嘅一次重要突破。DeepSeek V4 已可透過官方 API 同 Hugging Face 平台訪問,並計劃全面開源權重與代碼,標誌著中國 AI 企業喺高效大模型領域嘅持續領先。
DeepSeek V4 嘅發佈正值全球 AI 競爭白熱化之際。此前智譜 AI GLM‑5.1 同 Minimax2.7 嘅開源已經掀起一輪國產模型熱潮,DeepSeek V4 嘅亮相進一步鞏固咗中國 AI 喺開源高性能賽道上嘅位置。DeepSeek CEO 表示,V4 目標係「以極致性價比提供接近甚至超越國際頂尖閉源模型嘅編碼與推理能力」,為開發者、企業同研究者提供更實用嘅 AI 工具。
核心創新點:Engram 記憶架構與高效 MoE 設計
DeepSeek V4 最大嘅創新係佢嘅 Engram 條件記憶架構(Engram Conditional Memory)。呢個機制容許模型喺處理超過 100 萬 token 嘅超長上下文時,仍然能夠高效檢索同利用關鍵資訊,顯著提升長文檔分析、多文件代碼理解同複雜推理能力。與傳統向量檢索唔同,Engram 採用條件記憶方式,根據當前任務動態啟動相關知識,減少無關資訊嘅干擾,實現咗「記憶即計算」嘅高效融合。
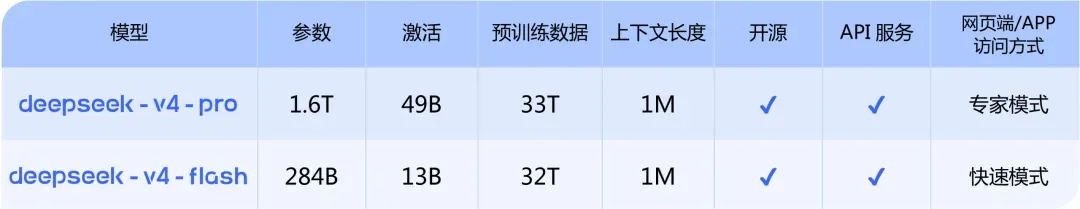
喺架構層面,DeepSeek V4 今次發佈兩個版本,當中 V4‑pro 版本採用約 1.6 萬億總參數、激活參數約 49B 嘅 MoE 架構,V4‑flash 版本採用約 284B億 總參數、激活參數約 13B 嘅 MoE 架構,結合 DeepSeek Sparse Attention 機制,喺保持高性能嘅同時大幅降低推理成本。模型支援1M token 上下文窗口,喺 Needle‑in‑a‑Haystack 測試中準確率達到 97%,遠高於標準注意力機制嘅 84.2%。呢個設計令 V4 喺處理大型代碼倉庫、長篇研究報告等場景表現出色,同時推理成本僅為同級別閉源模型嘅約 1/10。
編碼能力係 DeepSeek V4 嘅突出亮點。喺 SWE‑Bench Verified 基準上,V4 得分達到 80% 以上,領先 Claude Opus 4.6(約 80.8%)同 GPT‑5.4(約 77.3%)。喺 HumanEval 上得分約 90%,喺複雜多文件項目中嘅自主規劃同調試能力顯著增強。DeepSeek 團隊表示,呢啲成績得益於大規模代碼數據清洗同針對 agentic 任務嘅專項強化學習,令模型喺真實軟件工程場景中更具實用性。
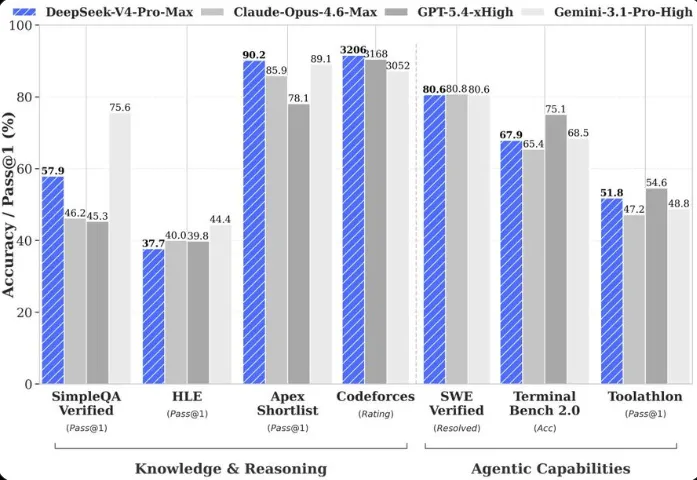
此外,V4 仲支援原生多模態輸入(文本、圖像、視頻),並喺數學推理(AIME 2026 得分 92%)同通用知識(MMLU 得分 89%)上表現出色。整體而言,V4 以中小激活參數實現咗「以小勝大」嘅效果,體現 DeepSeek 喺訓練效率同模型壓縮上嘅技術積累。
基準指標與性價比優勢
根據官方同第三方評測,DeepSeek V4 喺多項關鍵基準上取得領先:
- SWE‑Bench Verified:80%+(領先多數開源模型,接近或超越部分閉源頂級模型)
- HumanEval:約 90%
- MMLU:約 89%
- Needle‑in‑a‑Haystack(1M token):97%
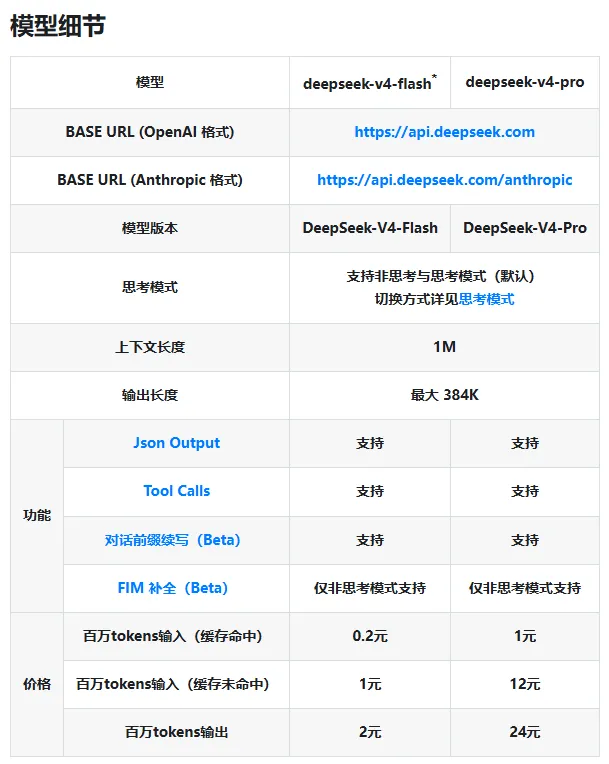
- 推理成本:輸入約 $0.14/百萬 token,輸出約 $1.75/百萬 token,遠低於 Claude 同 GPT 系列
呢項性價比優勢令 V4 特別適合開發者、本地部署同企業級應用。開源之後,社區已經開始將其整合到 OpenClaw、Cline 等 Agent 框架當中,預計會進一步降低 AI 編碼工具嘅使用門檻。
行業影響:國產開源 AI 進入高性能時代
DeepSeek V4 嘅發佈對全球 AI 生態造成多重影響:
- 開源社區活力:全面開源將吸引大量開發者參與微調同垂直優化,推動 AI Agent、代碼助手等工具嘅爆發式增長。
- 國際競爭格局:V4 喺編碼能力上嘅領先,進一步縮窄中國 AI 與國際頂尖閉源模型之間嘅差距,亦為全球開發者提供一個高性價比嘅替代方案。
- 商業化示範:DeepSeek 透過開源吸引流量、保留企業級 API 服務,形成咗「開源普惠 + 商業閉環」嘅健康模式,為行業提供新嘅範例。
- 對閉源巨頭嘅壓力:OpenAI、Anthropic 等公司面臨開源高性能模型嘅競爭,預計會加速自身模型迭代同定價調整。
對中國 AI 產業而言,V4 嘅成功再次驗證咗「高效 MoE 架構 + 自主算力」嘅可行性。DeepSeek 喺華為芯片上嘅訓練實踐,亦為國內企業自主可控嘅 AI 發展路徑提供咗重要參考。
挑戰與未來展望
儘管成績亮眼,DeepSeek V4 作為新模型,喺極長上下文、多語言複雜任務同長期穩定性方面仍有優化空間。開源之後,點樣平衡社區貢獻同商業化路徑,及如何應對潛在安全風險,都會係 DeepSeek 面臨嘅新課題。
DeepSeek 團隊表示,未來會繼續迭代 V 系列模型,並加強與開源社區嘅合作。GLM‑5.1、Minimax2.7 同 DeepSeek V4 嘅接連開源,共同標誌住 2026 年國產大模型進入「高性能開源時代」。隨著更多企業跟進,呢個趨勢有望推動中國 AI 喺全球舞台上佔據更重要嘅位置。
DeepSeek V4 嘅發佈,不單止係一次技術突破,更係國產開源 AI 自信與實力嘅集中體現。佢證明咗:喺算力自主、數據積累同工程優化嘅共同作用下,開源模型完全有能力喺關鍵基準上追平甚至超越閉源前沿。呢件事或將加速全球 AI 從「閉源壟斷」向「開源普惠 + 高端競爭」並存嘅新格局轉變。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com