
2026年10月17日,DeepSeek正式發布DeepSeek‑V4.1‑Flash‑1017,並同步開源模型權重。官方將其定位為對9月發布的DeepSeek‑V4.1‑Flash的一次「小幅更新」,但實際在推理、編碼、智能體任務及視覺基準上實現了顯著提升,同時縮短了任務執行時間與輸出長度,進一步優化了性能與成本的帕累托前沿。模型已在DeepSeek官網、App與API全面上線,調用方式與價格保持不變(仍使用deepseek‑flash標識),權重以MIT協議發布於Hugging Face與ModelScope。
核心升級與性能表現
DeepSeek‑V4.1‑Flash‑1017是基於V4.1‑Flash的迭代版本,總參數規模約763B,採用MoE架構,支援100萬token上下文與最高38.4萬token輸出,具備原生多模態(文本+圖像)能力。官方強調,新版本通過帶自我反饋的強化學習,強化了端到端項目開發能力,能夠從簡單描述直接生成完整可運行項目。
根據DeepSeek公布的對比數據,新模型在多項關鍵基準上均有提升:
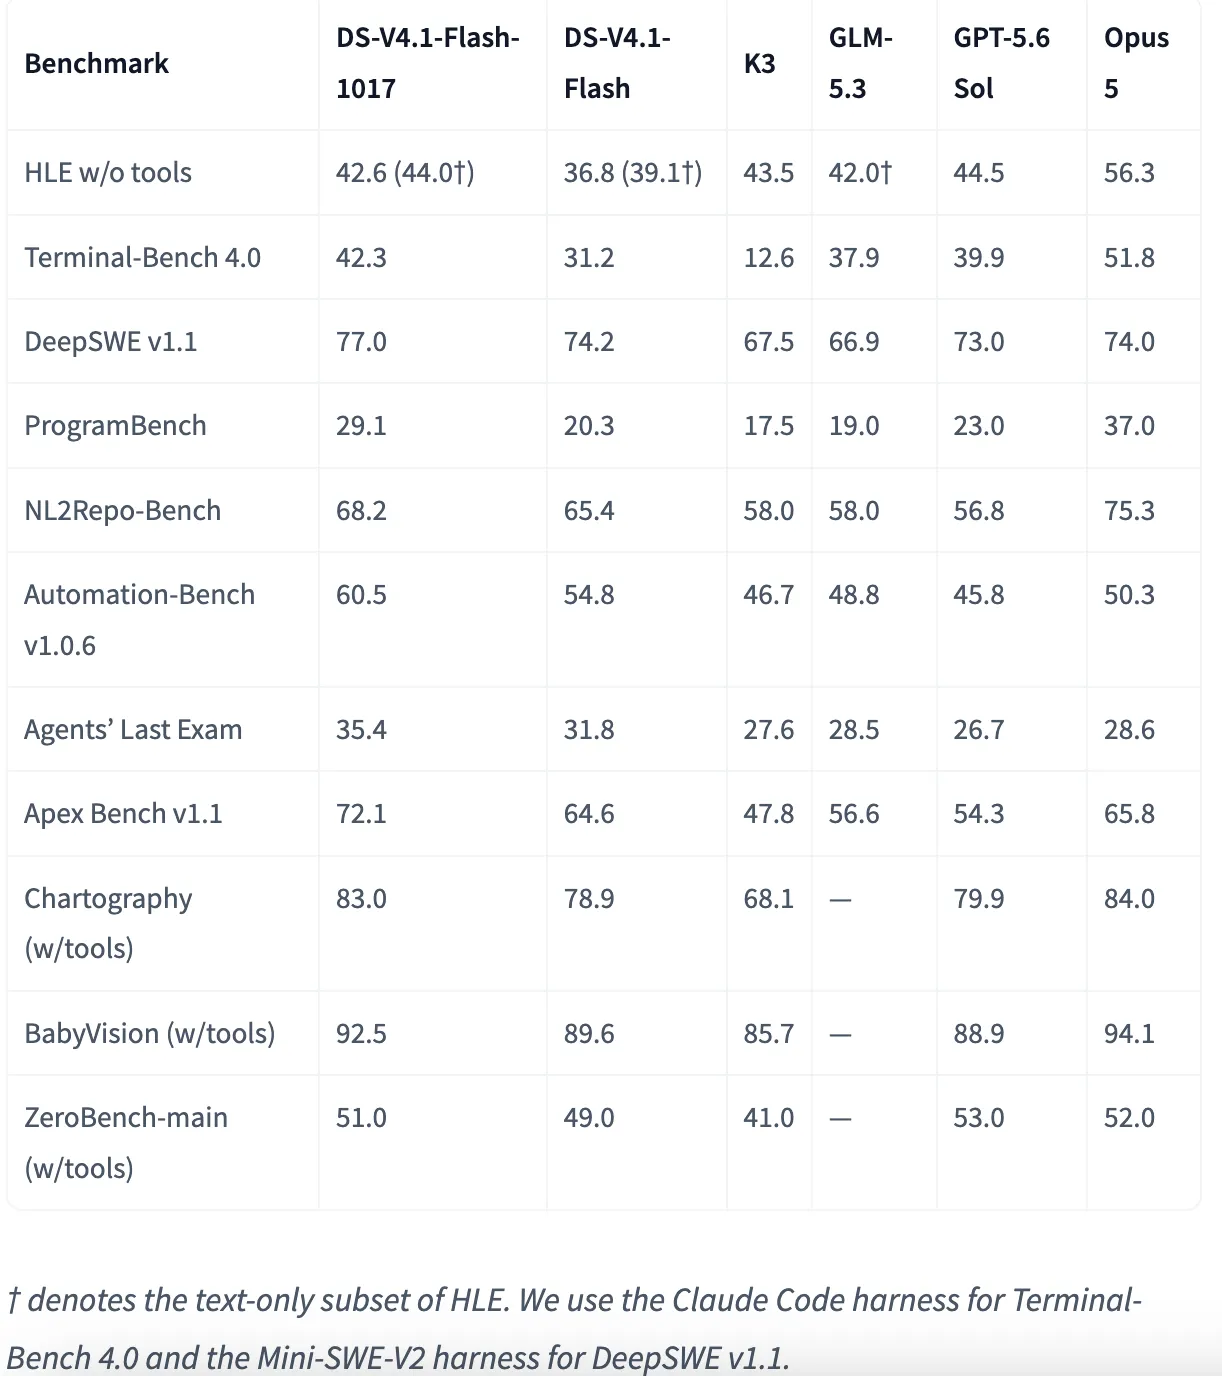
其中,Terminal‑Bench 4.0的大幅躍升尤為引人注目,顯示模型在真實終端環境中的多步驟操作、錯誤恢復與工具調度能力有實質性進步。DeepSWE v1.1達到77.0,在官方對比表中略高於Claude Opus 5(74.0)與GPT‑5.6 Sol(73.0)。需要指出的是,這些均為廠商自測數據,獨立第三方驗證仍需時間。
更值得關注的是效率改進:模型在完成任務時輸出更短、執行更快,從而在多個智能體測試框架下降低了單任務成本。官方稱這實現了「性能—成本」的帕累托改進。API定價保持不變,峰值緩存未命中輸入約0.30美元/百萬token、輸出1.20美元/百萬token(非高峰半價),實際使用中因輸出縮短,整體費用進一步下降。
「願望驅動編程」與實際演示
官方將新模型的核心能力概括為「Wish‑Driven Programming」(願望驅動編程)——用戶只需提出高層願望,模型即可自主完成從規劃、編碼、調試到交付的完整流程。官方展示了多個從零構建的完整項目,包括故宮建築3D建模、網頁版賽車遊戲、使用Godot引擎重製《Portal 2》,以及展示史前到現代演變的3D場景「Valley of Ages」。這些演示突出了模型在長程軟件工程與多模態理解上的進步。
同時,DeepSeek首次向外部開發者開放了自研搜尋引擎驅動的Search與Fetch API,每個端點定價為0.75美元/千次調用。通過DeepSeek Harness、Claude Code或Codex等服務端工具調用時,暫免費至2026年10月31日16:00 UTC。
開源與部署
模型權重以MIT協議在Hugging Face(deepseek‑ai/DeepSeek‑V4.1‑Flash‑1017)和ModelScope同步開源,便於社區進行本地部署與二次開發。由於其參數規模較大,完整運行對硬件要求較高(需多卡並行與優化推理框架,如vLLM),社區已開始跟進量化與適配工作。
可能影響與客觀評估
DeepSeek‑V4.1‑Flash‑1017的發布延續了該公司「高性價比+開源」的路線。作為面向智能體與編碼場景的輕量級(相對旗艦)模型,它在保持極低API成本的同時,顯著拉近了與部分閉源前沿模型在特定任務上的差距,尤其在終端操作與端到端軟件開發上。
對開發者而言,這是一次「免費升級」——現有deepseek‑flash調用無需修改代碼即可享受更高性能與更低實際成本。開源權重進一步降低了私有部署與定制門檻,有助於推動智能體應用的快速落地。
然而,客觀來看,仍需注意幾點:首先,基準數據主要為廠商報告,真實複雜場景下的穩定性與泛化能力有待更多獨立評測驗證;其次,在純推理能力(如HLE)上仍明顯落後於Claude Opus 5等頂級閉源模型;再次,超大參數量帶來的部署門檻,對普通個人開發者仍不友好。此外,「願望驅動編程」雖具吸引力,但實際生產環境中的可靠性、安全性與可維護性仍需長期觀察。
總體而言,DeepSeek此次更新再次證明了後訓練與強化學習在提升實用智能體能力上的有效性,也鞏固了其在高性價比開源模型陣營中的領先位置。對於追求成本敏感、長程編碼與智能體工作流的用戶,V4.1‑Flash‑1017提供了一個極具競爭力的新選擇。未來,社區的實際部署反饋與第三方評測,將進一步檢驗其真實價值。
▶️ 喜歡這篇內容?創作真的很辛苦!
歡迎關注我們的 YouTube 頻道:
AI Rosetta
你的讚、訂閱和分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問:https://www.airosetta.com