
喺各大 AI 公司(包括 OpenAI、Google、xAI、Anthropic)公布新版模型之後,內地 AI 新創 DeepSeek 再出重拳,喺 12 月 1 日正式開源推出 DeepSeek‑V3.2 同高效變體 V3.2‑Speciale。兩款模型以「推理優先」做設計核心,專為智能代理(agent)時代而造,被稱為「開源 AI 新王者」。V3.2 作為 V3.2‑Exp 嘅正式繼任,提供接近 GPT‑5 級別嘅平衡表現;V3.2‑Speciale 喺深度推理方面更進一步,聲稱超越 GPT‑5 並能匹敵 Google 嘅 Gemini 3.0 Pro,喺國際數學奧林匹克(IMO)同信息學奧林匹克(IOI)等頂級賽事取得金牌級成績。呢次發佈唔止標誌住開源模型喺複雜推理領域嘅突破,亦以 MIT 授權免費開源同超低成本 API(輸入 100 萬 token 只需 0.28 美元)重塑 AI 商業格局,喚起業界對中美 AI 競爭嘅討論。
DeepSeek 呢步棋做得啱時。到 2025 年,全球 AI 市場正由「規模競賽」轉向「推理效率」較量。OpenAI 嘅 GPT‑5 同 Google 嘅 Gemini 3.0 Pro 喺封閉式高性能上主導高端應用,但訓練同推理成本高昂(GPT‑5 每一百萬 token 超過 10 美元),令開發者卻步。DeepSeek V3.2 系列以 6850 億參數、128K 上下文窗口同開源權重直接填補呢個空白。現時 V3.2 已全面上線 DeepSeek 嘅 App、Web 平台同 API;V3.2‑Speciale 暫時限 API 訪問(專用端點:https://api.deepseek.com/v3.2_speciale_expires_on_20251215),會喺 12 月 15 日前限時提供,之後其能力會融入標準版。兩款模型都可以喺 Hugging Face 免費下載,支持 LoRA 微調同全參數訓練,並提供 Python 腳本兼容 OpenAI 格式,方便開發者快速整合。
喺技術層面,DeepSeek V3.2 系列最大亮點係「DeepSeek Sparse Attention」(DSA)機制。呢項創新將傳統 Transformer 架構嘅二次方注意力複雜度降到近線性。DSA 透過「閃電索引器」(lightning indexer)為每個查詢 token 只揀 top‑k(固定 2048)個關鍵歷史 token 做核心計算,索引器本身採用 FP8 精度同少頭數設計,額外開銷微乎其微。喺 128K 長上下文下,解碼成本較 V3.1‑Terminus 下降 70%,由 2.40 美元/百萬 token 減到 0.70 美元。訓練分兩個階段:先由 V3.1‑Terminus 冻結權重做「稠密預熱」(dense warm‑up),令索引器模仿稠密注意力分佈(2.1B token);之後切換到稀疏模式,做全參數訓練 943.7B token,配合低學習率確保性能平穩過渡。此外,V3.2 首創「Thinking in Tool‑Use」功能,將推理流程無縫嵌入工具調用,支援思考模式同非思考模式嘅雙重工具交互,適用於代碼調試、多步規劃等代理任務。
喺強化學習(RL)階段,DeepSeek 投入超過預訓練計算量嘅 10%,採用 GRPO‑style 框架:無偏 KL 估計提供純淨嘅獎勵信號、離策略序列掩碼確保舊 rollout 可安全訓練、MoE 路由一致性避免採樣偏差。數據合成係另一個殺手鐧:覆蓋 1800+ 環境同 85,000+ 複雜指令,包括搜索代理軌跡、代碼解釋器同多工具交互,模擬真實場景如行程規劃同 Web 研究。呢啲創新令 V3.2 系列喺代理性能上突出,例如喺多輪交互中保持上下文連貫,而唔係單純生成回應。
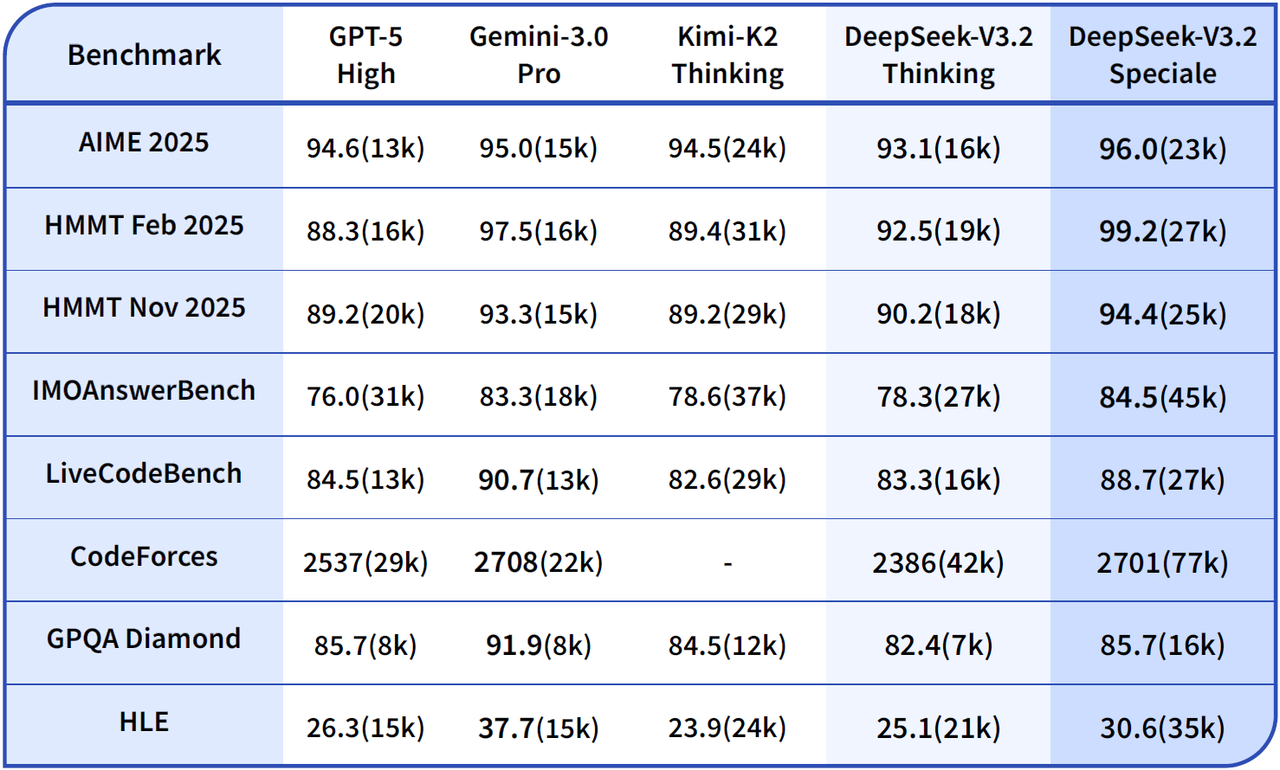
(注:V3.2‑Speciale 版本喺處理複雜任務方面表現出色,但需要更多 token。現時僅提供 API 訪問(不支持工具),用以支援社區評估同研究。)
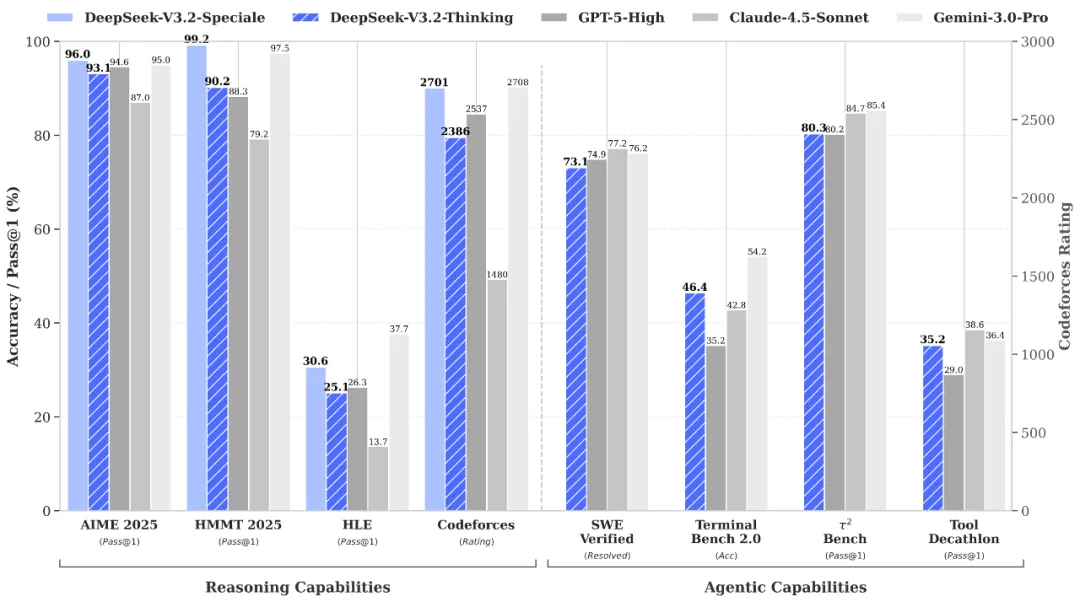
性能基準數據進一步印證佢嘅「推理極強」稱號。V3.2 喺 AIME 2025 上 pass@1 得分 93.1%,HMMT 2025 達 92.5%;V3.2‑Speciale 則升至 AIME 96.0%(超過 GPT‑5‑High 嘅 94.6% 同 Gemini 3.0 Pro 嘅 95.0%),HMMT 99.2%(超過 Gemini 嘅 97.5%)。喺賽事級任務上,Speciale 變體喺 2025 IMO 取得 35/42 分(屬金牌級)、IOI 492/600 分(第 10 名)、ICPC 世界決賽 10/12 題(第 2 名)、中國數學奧林匹克(CMO)金牌。編碼基準方面,V3.2 喺 SWE‑Verified 修復 73.1% bug(僅略低於 GPT‑5‑High 嘅 74.9%),Terminal Bench 2.0 達 46.4%(超越 GPT‑5 嘅 35.2%)。同 Claude 4.5 比較,V3.2 喺複雜工具使用基準上只係稍為落後,但整體推理表現可匹配或超越 GPT‑5 基線。呢啲成績得益於合成數據蒸餾;Speciale 喺高計算模式下會做「深度思考」,但需 2–3 倍 token 消耗。
當然,V3.2 系列並非完美。世界知識(尤其係近期事件)仍落後於封閉模型,token 效率喺極難驗證嘅任務中稍遜,且 Speciale 唔支持工具調用,定位為純粹推理嘅「腦內思考」。開發者反饋顯示,喺長上下文下雖然高效,但喺極高負載嘅任務可能需要額外嘅錯誤處理。儘管如此,佢嘅優勢好明顯:對比 GPT‑5/Gemini 有 25–30 倍嘅成本優勢,加上開源授權,大幅降低入門門檻。
呢次發佈對行業嘅衝擊好深遠。作為中國 AI 嘅代表,DeepSeek 繞過美國出口管制,以相當於 Gemini 約 1/30 嘅開發資源(約等於 Google 嘅 1/30)實現前沿表現,證明開源路徑嘅潛力。VentureBeat 分析指,呢件事可能顛覆美國科技霸權,推動 AI 從「工業火箭科學」轉向「大眾基礎設施」。歐盟嘅數據私隱憂慮(德國、意大利已禁相關 App)同美國政府設備禁令雖然存在,但開源擴散趨勢不可逆。喺 X 平台上,DeepSeek 官方帖文獲超過 1 萬個讚,使用者話佢「為 AGI 冬天帶來暖色」。喺 Reddit r/LocalLLaMA 子版塊,討論帖獲數百個贊,開發者稱讚「開源終於追平閉源」。
展望未來,DeepSeek 計劃擴展預訓練規模以填補知識空白,並探索 10M–100M 超長上下文。V3.2 系列問世,唔止係為代理時代鋪路,亦預示開源 AI 可能主導下一輪創新浪潮。開發者同研究者正蜂擁測試,呢個「推理魔盒」可唔可以真係「拜拜」GPT‑5 同 Gemini?答案有可能喺社區評測度揭曉。