
經過相對漫長嘅等待後,中國杭州初創公司 DeepSeek 喺本周一(2025年9月29日)向開發者同公眾發布咗佢最新嘅實驗性模型 DeepSeek‑V3.2‑Exp,並將佢定位為通往下一代架構嘅「中間步驟」(intermediate step)。公司喺官方公告同開發者平台話,V3.2‑Exp 喺 V3.1‑Terminus 基礎上引入咗名為 DeepSeek Sparse Attention(DSA) 嘅稀疏注意力機制,旨在提升長上下文場景下嘅訓練同推理效率,同時顯著降低計算成本。官方表示該模型已喺其應用、網頁版同 API 上線,並同步將 API 價格下調 50% 以上,以擴大普及同測試規模。
總結嚟講,今次 DeepSeek‑V3.2‑Exp 發布有以下幾個亮點:
1、引入稀疏注意力機制(DeepSeek Sparse Attention,DSA)
- 透過喺注意力計算中只揀選部分關鍵 token,大幅降低計算複雜度。
- DSA 屬於對榮獲 2025 年 ACL(Association for Computational Linguistics)最佳論文獎——Native Sparse Attention‑NSA 嘅改良版本,該論文原由 DeepSeek 同北京大學、華盛頓大學合作發表。
- 提升長上下文處理嘅效率同穩定性,適合長文檔問答、程式碼理解、多輪對話等任務。
2、顯著降低推理與訓練成本
- 喺保持輸出質量嘅同時,大幅降低算力消耗。
- API 定價同步下降 50% 以上,對企業同開發者更友好。
3、定位為「中間版」或過渡版本
- V3.2‑Exp 被定位為實驗性中間版本,用嚟測試新機制同收集市場反饋。
- 為後續大版本迭代(V3.5 或 V4)積累經驗。
4、開源與開發者支援
- 部分代碼同推理腳本已喺 Hugging Face 同 ModelScope 上開放。
- 方便研究者同工程師快速上手同復現。
5、商業策略:降價 + 擴大用戶規模
- 借助價格下調同開放 API 吸引更多開發者使用。
- 喺大規模應用同成本敏感場景(例如客服機器人、知識庫檢索)更具優勢。
6、適配國產 AI 晶片 🧩
- V3.2‑Exp 針對國產 AI 晶片做咗深入優化,確保喺非英偉達 GPU 環境下都能高效運行。
- 有助提升國產算力生態嘅利用率,降低對海外硬件嘅依賴。
從技術角度嚟睇,DeepSeek 所講嘅 DSA 屬於稀疏注意力(sparse attention)家族:透過喺注意力計算中只聚焦於部分關鍵 token,或者採用可學習嘅索引選擇機制,將注意力計算由典型嘅二次複雜度(O(n²))拉向近線性複雜度。呢類方法近年嚟成為處理超長上下文嘅主流思路之一,但實現細節同選取策略會直接影響模型嘅效能同穩定性。DeepSeek 喺 Hugging Face 嘅倉庫中同時開源咗部分實現同推理腳本,方便社區復現同測試其喺唔同長度同任務下嘅表現。
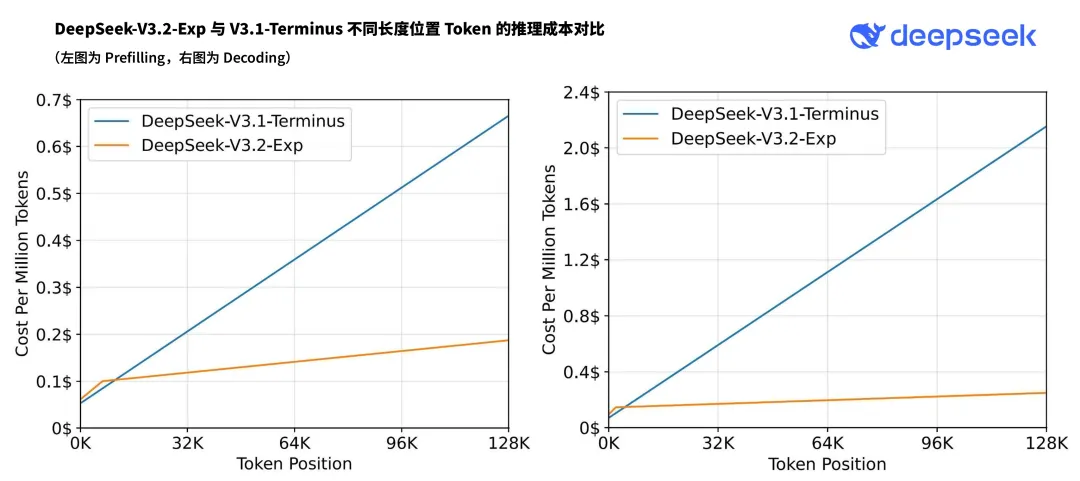
產業影響方面,V3.2‑Exp 並唔被 DeepSeek 自稱為一次「革命性」升級,而係一次工程同架構驗證:喺保持相當生成質量嘅前提下,探索透過架構層面嘅稀疏化去壓縮成本嘅可行路徑。業內觀察者認為,如果 DeepSeek 能夠喺真實產品場景中以更低嘅計算成本交付近似體驗,佢喺成本敏感嘅應用場景(例如大規模線上 API、聊天機器人、企業私有化部署)上會獲得明顯優勢,呢亦可能拉低市場平均 API 定價並對國內外同行形成壓力。該公司此番策略同時帶有明顯嘅商業訊號:透過降價吸引流量並擴大模型使用樣本,從而快速收集真實世界嘅反饋以繼續迭代。
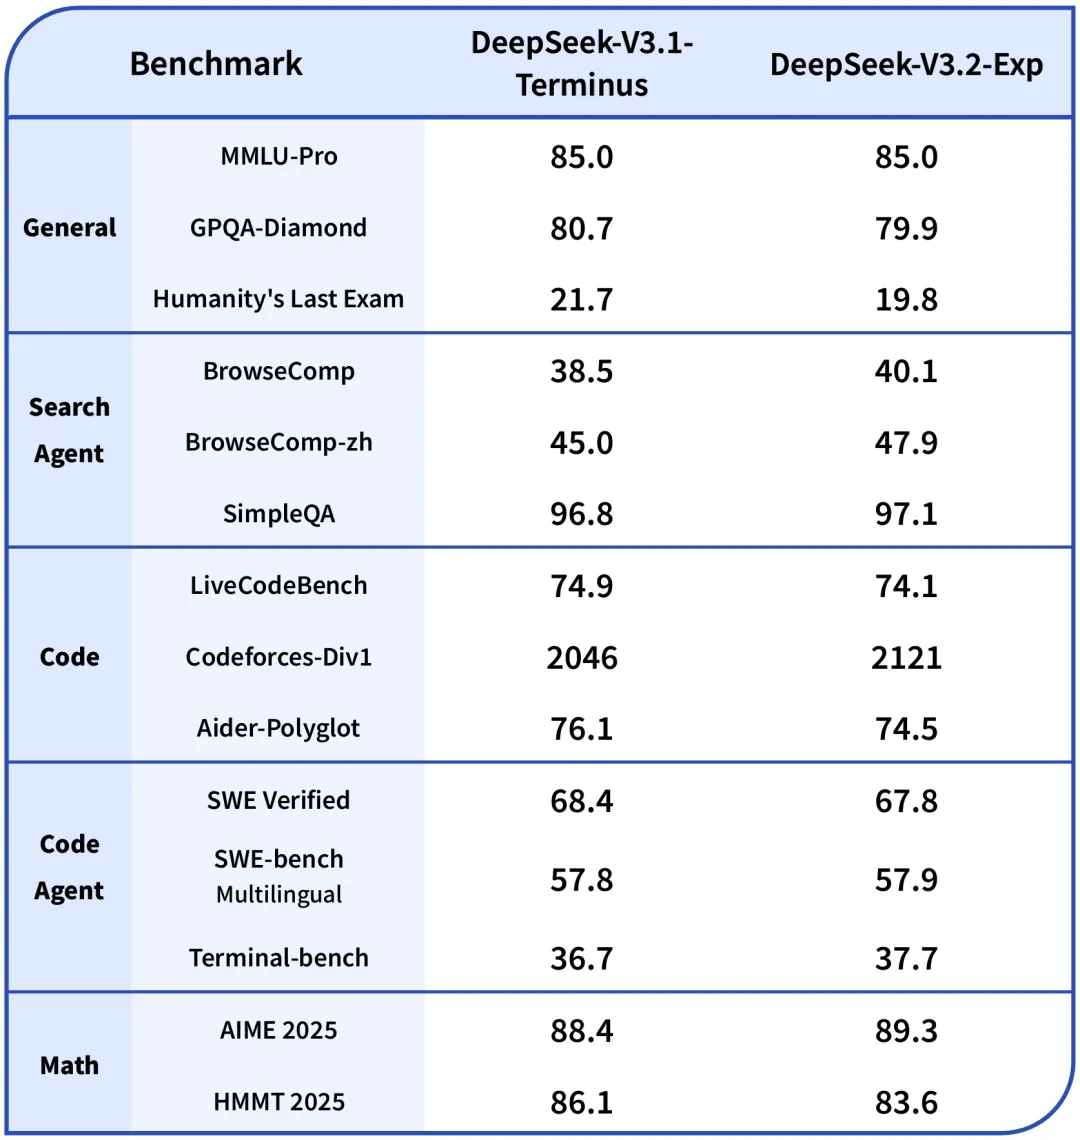
媒體同分析機構喺第一時間對 DeepSeek 嘅發布做出唔同側重嘅解讀。路透社喺報導中指出,V3.2‑Exp 係 DeepSeek 向其「下一代架構」過渡嘅試驗性版本,可能唔會似此前嘅 V3 同 R1 咁掀起完全同等規模嘅行業震盪,但如果能喺成本同長上下文處理上取得實效,仍會強化其市場競爭力。彭博與南華早報等亦關注到公司今次發布中對國產 AI 晶片同去中心化部署嘅適配策略,認為 DeepSeek 正試圖用工程創新去彌補喺算力同生態上嘅差距。
值得注意嘅係,DeepSeek 近年嘅開放源代碼同「低價」策略並非孤立事件。公司之前已公開若干代碼庫、算法細節,並喺早期版本中引入咗例如 Native Sparse Attention(NSA)等優化思路以提升長序列訓練效率;今次 V3.2‑Exp 可視為喺呢條路線上又一次嘅實裝檢驗。同時,外界對 DeepSeek 嘅關注亦唔係全部正面:此前有關是否存在對某啲外部模型方法嘅不當借鑒嘅輿論同調查仍有散見報導,呢啲亦對其透明度同合規性提出咗更高要求。
對開發者與企業用戶嚟講,短期可關注嘅關鍵點包括:V3.2‑Exp 喺唔同任務(例如長文檔問答、程式碼理解、多輪對話)上嘅質量—成本權衡表現、DSA 喺極長上下文下嘅泛化穩定性、以及官方開源代碼或推理優化工具嘅成熟度。DeepSeek 將模型喺 Hugging Face 同 ModelScope 等平台同步發布,意味住研究社區同工程師可以較快跑通復現實驗、對比其他稀疏/高效注意力變體,從而更快判定該架構嘅實際價值。
DeepSeek‑V3.2‑Exp 嘅發布更似一支「探針」——一方面為下一代更大規模、更多創新嘅架構搜集工程數據,另一方面亦透過價格策略吸引更廣嘅使用者群體。佢反映出中國 AI 初創公司喺模型工程同成本控制方面嘅持續嘗試,同時提醒行業喺追求更低成本嘅同時,必須兼顧模型可靠性、數據同方法嘅透明度等長期挑戰。未來數周至數月,隨住更多基準測試、社區復現結果同產品級別嘅使用反饋出現,外界會更清楚評估 DSA 及 V3.2‑Exp 喺真實世界中嘅實際價值。