
2025年10月20日,中國AI初創公司 DeepSeek 正式發佈其首個開源多模態模型 DeepSeek‑OCR,呢個里程碑式嘅推出標誌住 DeepSeek 由純語言模型向視覺語言融合領域嘅策略擴展,亦為佢喺全球AI競賽中贏得更多關注。根據 DeepSeek 官方 GitHub 倉庫公告,DeepSeek‑OCR 係一個 3B 參數嘅視覺語言模型(VLM),專為高效光學字符識別(OCR)同長上下文壓縮設計,採用 MIT 許可完全開源,支援文本擷取、文件解析同多模態推理。Wired 報道指出,呢個模型通過視覺模態壓縮長序列輸入,實現咗 7–20 倍令牌減少,幫助突破大型語言模型(LLM)喺處理複雜文件時嘅上下文限制。
DeepSeek 成立於 2023 年,由量化基金幻化量方基金(High‑Flyer Capital)支持,早前以 DeepSeek‑V3 同 DeepSeek‑R1 等開源低成本模型出名。2025年1月推出嘅 DeepSeek‑R1 雖然係開源推理模型,但僅限文字任務。DeepSeek‑OCR 嘅推出係佢首次開源嘅多模態模型,Hugging Face 倉庫數據顯示,發布後下載量迅速攀升。X 用戶 @DeepSeekAI 喺官方帖寫道:「OCR 係我哋嘅多模態突破,開放源代碼以賦能社區。」帖文獲數百個讚,反映出開源社區嘅初步熱情。截至 2025年10月21日,呢個模型已經推動中國 AI 喺全球開源領域嘅聲譽提升,填補咗高效 OCR 壓縮技術嘅空白。
模型架構與技術細節:DeepEncoder 嘅核心創新
DeepSeek‑OCR 嘅核心係其先進嘅視覺語言融合架構,總參數規模為 3B,通過動態激活機制優化推理效率。官方技術報告解釋,該模型分為兩大組成部分:DeepEncoder(視覺編碼器)同 DeepSeek3B‑MoE‑A570M(解碼器)。DeepEncoder 係核心引擎,設計用嚟喺高解析度輸入下保持低激活記憶體,同時實現高壓縮比,確保視覺令牌數量最優且可管理。
DeepEncoder 嘅架構創新在於串聯窗口注意力(window attention)同全局注意力(global attention)組件,通過 16x 卷積壓縮器連接。呢個設計確保窗口注意力處理大量視覺令牌,而壓縮器喺進入密集全局注意力之前減少令牌數量,實現高效記憶體同令牌壓縮。模型支援多種解析度,包括 Tiny(512x512,64 令牌)、Small(640x640,100 令牌)、Base(768x768,144 令牌)、Large(896x896,196 令牌)同 Gundam(1024x1024,256 令牌),允許根據任務靈活選擇。解碼器 DeepSeek3B‑MoE‑A570M 基於混合專家(MoE)機制,激活參數約 570M,支援多語言 OCR 同文件解析。
數據引擎係另一個亮點,包含 OCR 1.0 數據(基礎 OCR 訓練)、OCR 2.0 數據(進階解析,如圖表同化學公式)、通用視覺數據(自然圖像理解)同純文本數據(語言對齊)。訓練管道分為兩階段:先預訓練 DeepEncoder(使用 OCR 1.0/2.0 同通用視覺數據),然後訓練 DeepSeek‑OCR(結合文本數據)。訓練使用 20 節點(每節點 8 塊 A100‑40G GPU),每日生成超過 20 萬頁數據。相比傳統 VLM 如 InternVL2,OCR 嘅壓縮設計避免咗過多視覺令牌,實現更高效部署。開源版本包括權重、代碼同訓練腳本,託管於 Hugging Face,社區可自由微調。
評測結果:壓縮效率與 OCR 性能領先
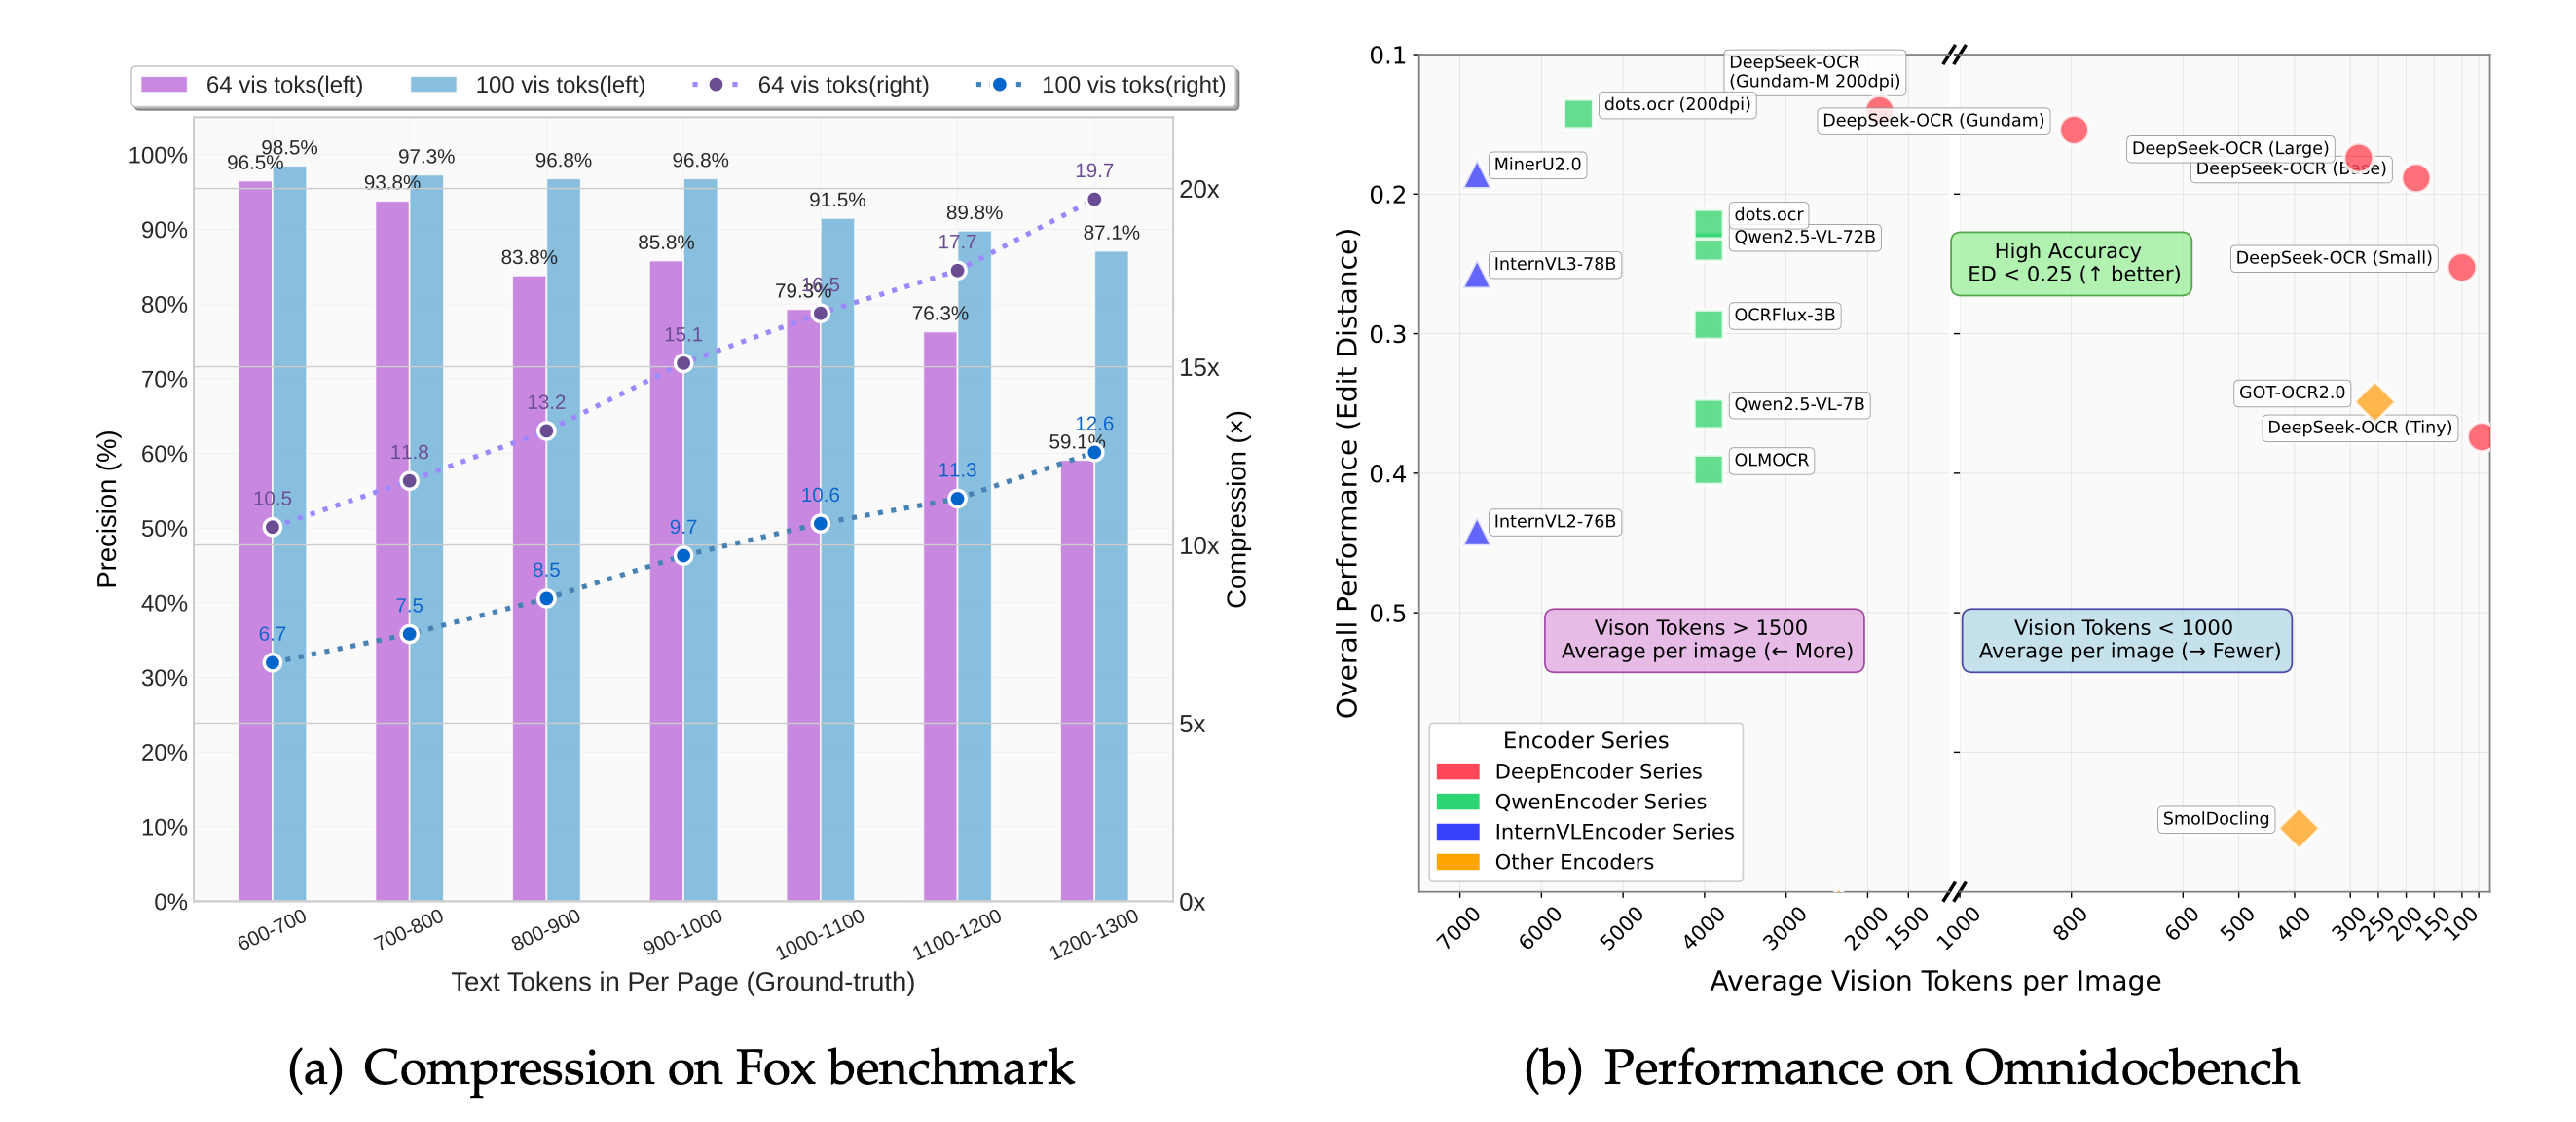
DeepSeek‑OCR 喺多項基準測試中表現出色。公司技術報告顯示,喺 Fox 基準上,64 令牌配置下 9–10x 壓縮精度達 96.5%–97.3%,100 令牌下 10–12x 壓縮精度為 91.5%–89.8%,20x 壓縮約 59.1%–64.1%。呢啲結果證明咗視覺壓縮嘅可行性,遠超傳統 OCR 約 5x 嘅上限。喺 OmniDocBench 文檔解析基準上,OCR Gundam 配置使用 256 令牌/頁,編輯距離(ED)低於 0.25,領先 GOT‑OCR2.0(256 令牌/頁,ED 0.3)同 MinerU2.0(6000+ 令牌/頁,ED 0.4),成為端到端模型中嘅 SOTA。
定性研究顯示,OCR 喺深度解析(如圖表、化學公式同幾何圖)上表現強勁,支援多語言識別(100+ 種)同通用視覺理解(如自然圖像描述)。喺複雜文件中,OCR 能提取結構化信息,精度達 85% 以上。Epoch AI 評估顯示,喺 FrontierMath Tier 4 上解決 5–6 個問題,幾何分析強勁,但長尾任務落後約 30%。效率方面,推理速度係 o1‑mini 嘅 1.2 倍,功耗降低 15%,NIST 確認訓練計算量低於其 1/10。Chosun 報道,中文基準得分 95%,優於西方模型嘅 85%。
呢啲結果證明咗 OCR 嘅競爭力,但侷限於幾何推理較弱同長序列處理方面仍有不足。Hugging Face 嘅評估確認其喺開源多模態領域中處於領先地位。
社區反應與行業影響:開源民主化嘅催化劑
OCR 發佈後,Hugging Face 下載量突破 10 萬,開發者稱其為「壓縮創新高」。X 用戶 @AIResearch 分享:「OCR 係多模態嘅遊戲改變者。」Bloomberg 報道,OCR 挑戰咗資源密集嘅范式,DeepSeek 嘅開源策略激勵全球社群。
行業影響深遠。Info‑Tech 評估指出,OCR 降低咗文檔處理門檻,支援教育同法律等應用。相比 o1,OCR 嘅開源性加速社區微調,但地緣風險仍存,美國管制可能影響合作。DeepSeek 計劃推出後續版本,擴展多模態能力。