
引言
2026年1月27日,中國開源AI領軍企業深度求索(DeepSeek)正式發佈 DeepSeek‑OCR 2 模型。呢個視覺語言模型(Vision‑Language Model,VLM)喺文檔理解同光學字符識別(OCR)範疇實現重大突破。模型引入「視覺因果流」(Visual Causal Flow)概念,透過動態重排視覺 token,顯著提升對複雜文檔版面嘅理解能力,喺多個國際基準測試刷新 SOTA(State‑of‑the‑Art)紀錄。DeepSeek 官方 GitHub 倉庫同 Hugging Face 模型卡同步上線,模型參數規模僅 3B,卻喺視覺文檔理解、OCR 準確度同多模態推理上表現出色,被視為「3B 級別最強文檔 AI」。
呢次發布延續 DeepSeek 自 2025 年 DeepSeek‑OCR 系列以來對「視覺壓縮與長上下文優化」嘅探索路線。原版 DeepSeek‑OCR 透過光學壓縮實現 7–20 倍上下文壓縮,而 DeepSeek‑OCR 2 則聚焦喺邏輯理解瓶頸,解決傳統 OCR 喺表格、公式、交叉版面等複雜場景準確率下降嘅問題。Odaily News 同 AIBase 報道指,呢個模型標誌住中國團隊喺開源 VLM 領域嘅又一里程碑,推動文檔 AI 從「字符識別」向「語義理解」轉型。
模型規格與整體架構
DeepSeek‑OCR 2 參數規模為 3B(30 億),採用端到端視覺語言架構,包括視覺編碼器(DeepEncoder V2)同語言解碼器(DeepSeek‑3B‑MoE‑A570M)。視覺編碼器負責將高分辨率文檔圖像壓縮為少量視覺 token,語言解碼器則基於呢啲 token 進行語義理解同文本生成。
核心組件:
- DeepEncoder V2:視覺編碼器升級版,將原版 CLIP 骨幹替換為 Qwen2‑0.5B 輕量 LLM 架構,利用語言理解能力實現語義感知嘅視覺編碼。結合窗口注意力(基於 SAM)同密集全局注意力,做到局部細節同全局版面嘅融合。圖像透過兩層卷積壓縮器 16× 下採樣,生成高效視覺 token。
- DeepSeek‑3B‑MoE‑A570M 解碼器:混合專家(MoE)架構,每個 token 激活約 570M 參數(6/64 路由專家 + 2 共享專家),提升推理效率。
- 視覺因果流(Visual Causal Flow):核心創新模組,根據文檔內容同語義關係動態重排視覺 token,而唔係沿用固定格子掃描順序,實現「似人類咁閱讀」文檔。
模型支援多語言 OCR、複雜版面解析(表格、公式、圖表)、結構化抽取(HTML/LaTeX/Markdown 輸出),並兼容 vLLM 等高效推理框架。
視覺因果流:突破 OCR 效能瓶頸嘅核心原理
傳統 OCR(例如 Tesseract、PaddleOCR)依賴固定掃描路徑(如由左至右、由上而下),喺多欄版面、交叉引用、圖表說明等複雜文檔中容易遺失邏輯關係,導致準確率大幅下降。DeepSeek‑OCR 2 嘅「視覺因果流」直接針對呢個瓶頸,原理如下:
- 視覺 token 生成與初始排序:輸入高分辨率文檔圖像,經 DeepEncoder V2 壓縮為少量視覺 token(通常 100–800 個),初始順序基於格子掃描。
- 因果關係建模:模型利用 Qwen2‑0.5B 嘅語言理解能力,分析視覺 token 之間嘅語義關係(例如表格標題決定單元格含義、圖表標題解釋上方圖示)。構建因果圖(causal graph),識別「邊個影響邊個」嘅邏輯流。
- 動態重新排序:根據因果圖,模型喺推理階段動態調整 token 順序。例如先處理標題再處理正文,先讀圖表說明再解析圖表內容。呢種「似人類閱讀」嘅順序明顯提升理解準確率,避免傳統固定路徑出現嘅前後矛盾問題。
- 多輪自反思與擴展:結合測試時擴展機制,模型喺必要時會進行多輪反思,進一步優化 token 排序同語義抽取,對難題做深度處理。
呢個機制本質上係「視覺序列嘅重構」,透過因果推理打破固定掃描嘅瓶頸。論文《DeepSeek‑OCR 2: Visual Causal Flow》指出,喺 OmniDocBench 等基準上,使用相同數量嘅視覺 token 時,準確率提升超過 30%。
性能表現與 SOTA 突破
DeepSeek‑OCR 2 喺多個基準測試中刷新紀錄:
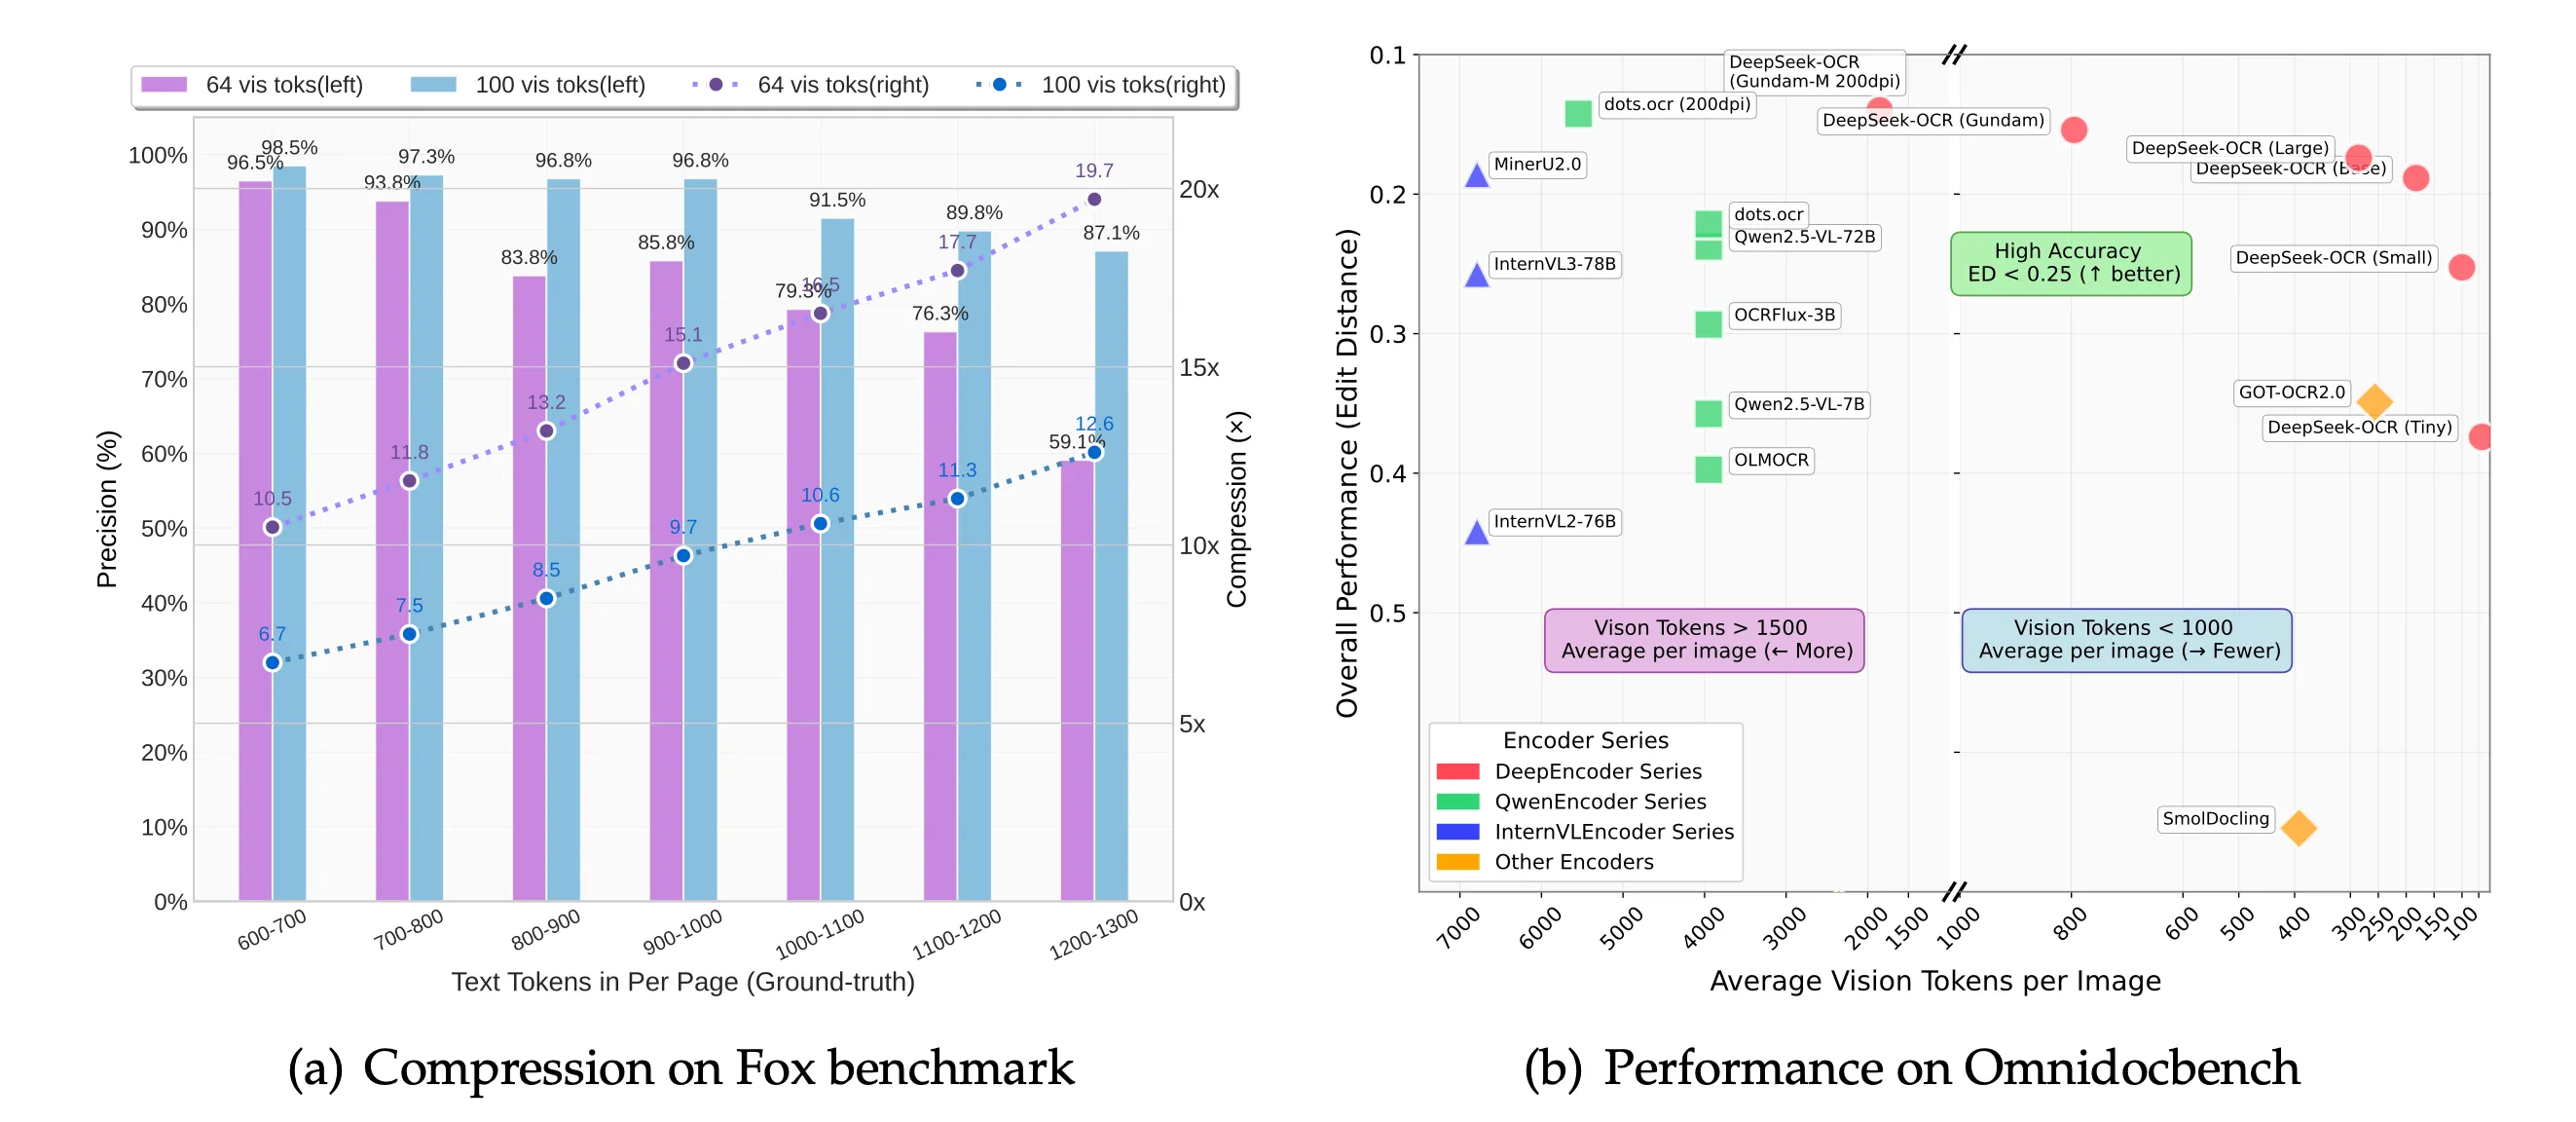
- OmniDocBench:使用 100 個視覺 token 已超越 GOT‑OCR2.0(需 256 個),800 個 token 時領先幅度顯著。
- OCR 準確率:壓縮比 10× 時 OCR 準確率達 97%,20× 時仍有 60%,遠超傳統方法。
- 文檔理解:對複雜版面(多欄、交叉、公式、圖表)識別率領先,喺化學公式(SMILES)同幾何圖形解析方面表現突出。
- 多語言支援:覆蓋 100+ 語言,中文表現尤其出色。
AIBase 同 Odaily News 報道指,該模型喺視覺文檔理解、OCR 準確率同多模態推理上實現 SOTA,參數只有 3B 卻超越唔少 10B+ 模型。相比前代 DeepSeek‑OCR,OCR 2 喺邏輯理解同動態處理上有顯著提升,標誌住視覺壓縮由「量」向「質」嘅躍進。
應用案例
DeepSeek‑OCR 2 適用於文檔數字化、知識抽取、自動化辦公等場景。
- 法律與金融文檔處理:企業用戶用模型解析密集 PDF 合約,抽取條款、表格同簽名,準確率超過 95%,節省人工審核時間。
- 學術論文分析:研究者上傳論文圖像,模型自動抽取公式、圖表說明同參考文獻,生成 Markdown 結構化輸出,便於後續分析。
- 多語言檔案數字化:博物館使用模型處理古籍、手寫文檔,支援 100+ 語言,實現高效數字化同語義檢索。
- 企業 RPA 集成:結合 Agent 工具鏈,模型自動讀取發票、合約,抽取關鍵字段並錄入 ERP 系統。
呢啲案例喺 GitHub 同 ModelScope 社區廣泛分享,證明模型喺實際場景中嘅實用性。
影響與挑戰
DeepSeek‑OCR 2 嘅發布進一步鞏固咗中國喺開源 VLM 領域嘅領先地位,推動文檔 AI 從字符識別向語義理解轉型。Hugging Face 報告顯示,中國開源模型下載佔比 17.1%,DeepSeek 系列貢獻顯著。
挑戰包括:
- 計算資源:雖然參數高效,但處理高分辨率文檔仍需要強大 GPU 支持。
- 泛化能力:極端手寫或低質量掃描文檔嘅準確率仍有提升空間。
- 倫理與安全:文檔隱私保護需要加強,避免敏感資訊洩露。
結論
DeepSeek‑OCR 2 透過視覺因果流嘅創新,突破咗傳統 OCR 喺邏輯理解上嘅瓶頸,喺 3B 規模下達到 SOTA 性能。呢次發布唔單止係技術突破,亦係開源生態嘅典範。未來隨住更多社區貢獻同生態整合,佢有望加速文檔 AI 嘅產業落地,推動全球 AI 朝住更智能、更高效方向演進。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com