
喺2026年元旦嗰陣,DeepSeek 團隊發表嘅論文《mHC: Manifold‑Constrained Hyper‑Connections》(流形約束超連接)喺 AI 社群引起咗廣泛關注。呢篇由解振達、韋毅軒、曹桓奇同 DeepSeek 創辦人梁文峰聯名發表嘅預印本(arXiv:2512.24880),提出咗一種新架構 mHC,旨喺解決傳統超連接(Hyper‑Connections,簡稱 HC)喺大規模語言模型(LLM)訓練中嘅不穩定問題,同時保留其性能優勢。作為 DeepSeek‑V3 模型嘅後續創新,mHC 通過數學上嘅「流形約束」恢復咗殘差連接嘅核心屬性——恆等映射(Identity Mapping),並結合工程優化,實現更高效嘅訓練。呢個架構嘅原理唔係深奧難明,而係對神經網絡信息流動機制嘅巧妙優化。本文會用通俗易明嘅語言,配合比喻同關鍵數學細節,逐步拆解 mHC 嘅原理,幫助讀者理解佢由發現問題到提出方案嘅完整邏輯。
先講舊問題:點解神經網絡需要「殘差連接」?
要理解 mHC,先由神經網絡嘅基本問題講起。深度學習模型例如 Transformer 就好似一座高聳入雲嘅大樓,每一層(layer)處理資訊後傳畀下一層。如果資訊一層一層純粹傳下去,好容易喺途中「流失」或「扭曲」——即係梯度消失(Gradient Vanishing)或者梯度爆炸(Explosion)嘅問題。2015 年,何愷明團隊發明咗殘差連接(Residual Connections),等於喺樓宇旁邊開咗條「直達升降機」或者「高速公路」:每一層嘅輸出唔係單純計算結果,而係輸入信號 x 加埋本層計算 F(x),即 y = x + F(x)。呢度嘅 x 就係「原始信號」,直接「跳過」本層,確保資訊平穩流動。
點解咁做有效?因為佢實現咗「恆等映射」:如果本層計算 F(x)≈0,輸出就≈x,信號唔會變形、唔會放大或者收細。數學上,呢個設計保持咗信號嘅均值守恆(Signal Mean Conservation)同範數有界(Bounded Norms),令梯度喺反向傳播時穩定。Transformer 嘅每一塊(Attention + FFN)都用殘差包住,正係呢個設計令模型可以堆叠好多層。
HC 嘅創新同痛點:多車道高速公路嘅「失控風險」
殘差連接固然穩定,但資訊流有啲「單一」——好似單線車道,高峰期流量有限。2024 年,字節跳動提出咗超連接(HC):將單條殘差流擴展成多條(擴展率 n,通常 4–8),令資訊喺呢啲「平行通道」之間交叉混合。比喻成多車道高速公路:主道仍然係 x,但額外車道可以從主道分流、計算後再合併,仲可以喺車道之間「換道」(透過全連接或隨機矩陣)。
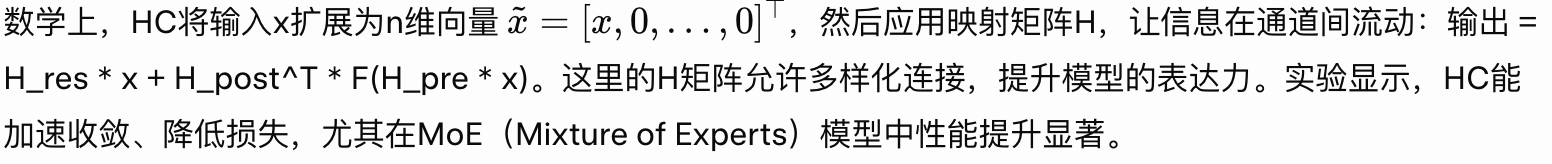
但問題嚟喇:多車道任意換道,會導致「交通事故」頻發!信號被無限放大(論文指出放大超過 3000 倍),訓練變得不穩定——損失曲線突然飆升、梯度範數爆炸、記憶體訪問開銷增加。喺巨型模型(萬億參數級)入面,呢啲直接導致崩潰。根本原因係 HC 破壞咗殘差嘅恆等映射:H 矩陣如果冇約束,可能令信號縮放失控,就好似高速公路冇限速同冇護欄,車速任性,結果亂晒陣腳。
mHC 嘅核心原理:俾多車道加「護欄」
DeepSeek 嘅 mHC 就係俾 HC 加護欄:將 H 矩陣約束喺一個特殊嘅數學空間——雙隨機矩陣(Doubly Stochastic Matrices)嘅 Birkhoff 多面體(Birkhoff Polytope)。通俗啲講,雙隨機矩陣係咁嘅權重表:每個元素非負(只做正向流動),每行同每列嘅和都等於 1(總量守恆)。
點解呢個做法有效?因為佢令資訊混合變成「凸組合」(Convex Combination):輸出係輸入特徵嘅加權平均,總量唔會變,唔會放大或者收細。比喻:將資訊想像成水流,多車道混合嘅水,倒出後每桶水嘅總量等於 1,唔會溢出或者蒸發。數學上,呢個約束確保:
- 信號均值守恆:E[y] = E[x],平均值唔變。
- 譜範數≤1:矩陣最大奇異值≤1,防止信號指數級放大。
- 組合閉包:多層 H 嘅乘積仍然係雙隨機矩陣,端到端保持穩定。
點樣實現呢個約束?用 Sinkhorn‑Knopp 演算法:由一個初值矩陣 \tilde{H} 開始,反覆做行歸一化同列歸一化(除以總和),迭代大約 20 步,就可以「投影」到雙隨機空間。公式:
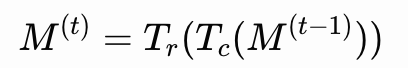
當中 T_r 係行歸一化,T_c 係列歸一化。呢個演算法早喺 1967 年就有,簡單高效,淨係加咗少量計算開銷。
mHC 嘅層內傳播:先將輸入擴展為 n 維 \tilde{x},做標準化(RMSNorm),然後計算三個 H 矩陣(pre、post、res):pre/post 用 sigmoid 激活(確保非負),res 用 Sinkhorn 投影。最終輸出:
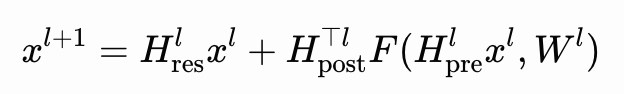
多層累積之後,信號可以穩定流動,唔會再崩潰。
點解 mHC 唔慢?工程優化上嘅「錦上添花」
淨係有原理仲唔夠,訓練大模型仲要快。DeepSeek 做咗三樣工程優化:
- 內核融合(Kernel Fusion):用 TileLang 自定義 GPU 內核,將矩陣運算同歸一化「融合」成一步,減少記憶體讀寫。激活用 bfloat16(低精度快),參數用 float32(高精度準)。
- 選擇性重算(Selective Recomputing):記憶體昂貴,唔需要存晒所有中間結果。只每隔 L_r 層存一次主殘差,其他層重算。塊大小公式
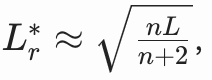
- ,平衡記憶體同計算(L 係總層數,n 係擴展率)。
- DualPipe 擴展:喺分布式訓練入面,用高優先級流去重疊通訊同計算,減少「pipeline 氣泡」(閒置時間)。
結果:喺 n=4 時,時間只多 6.7%,記憶體 1.05 倍。實驗顯示,mHC 喺 3B–27B 模型上,損失下降 0.021,基準分提升 1–2%。
mHC 嘅深層意義:AI 架構嘅「新範式」
mHC 唔單止係修 bug,佢證明咗「約束即自由」:透過將權重限制喺數學空間,解鎖更寬嘅架構潛力。比喻成畀小朋友嘅遊戲區加咗護欄,空間大但安全。未來,大模型好可能會採用類似嘅流形約束,避免規模盲目膨脹。DeepSeek 呢篇論文再次展示咗開源創新嘅力量,對資源有限嘅團隊尤其友好。
總括嚟講,mHC 用流形護欄解決咗 HC 嘅失控問題,令神經網絡嘅資訊流動更穩、更強。呢唔止係技術細節,而係 AI 從「野蠻生長」向「精耕細作」嘅轉變。如果你做 AI 訓練,絕對值得一試!
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請瀏覽:
https://www.airosetta.com