
喺2026年元旦之際,中國AI初創公司DeepSeek發佈咗重量級新論文《mHC: Manifold‑Constrained Hyper‑Connections》(流形約束超連接),提出一種叫做mHC嘅全新架構。該論文由解振達(Zhenda Xie)、韋毅軒(Yixuan Wei)同曹桓奇(Huanqi Cao)共同擔任第一作者,DeepSeek創辦人兼CEO梁文鋒(Wenfeng Liang)亦係作者之一。呢項研究發佈喺arXiv(預印本編號2512.24880),目的係解決傳統超連接(Hyper‑Connections,簡稱HC)喺大規模模型訓練中嘅不穩定問題,同時保留其性能優勢。作為DeepSeek喺2025年開源模型DeepSeek‑V3基礎上嘅一次重大創新,mHC架構透過流形約束恢復殘差連接嘅恆等映射屬性,並結合基礎設施優化,實現更穩定嘅訓練同更好嘅可擴展性。論文發佈標誌住梁文鋒團隊喺AI基礎架構領域嘅又一突破,亦為大語言模型(LLM)嘅未來發展指明新方向。本文基於arXiv原論文、IT之家報道以及Hugging Face論文頁面等權威來源,詳細解讀mHC架構嘅技術細節、實驗結果及其意義。
論文背景與動機:殘差連接嘅演進與挑戰
殘差連接(Residual Connections)係深度學習模型例如ResNet同Transformer嘅核心組件,由何恺明(Kaiming He)等人喺2015年提出。其關鍵係「恆等映射」(Identity Mapping)屬性,確保訊號喺深層網絡中穩定傳播,避免梯度消失或爆炸問題。近年嚟,研究者透過擴展殘差連接去提升模型性能,當中超連接(HC)就係一個典型方法。HC透過加闊殘差流(Residual Stream)嘅寬度(擴展率n,通常係4‑8)同多樣化連接模式(例如全連接或隨機連接),實現顯著性能增益,而唔會增加計算複雜度(FLOPs)。例如喺Transformer中,HC可以允許殘差分支之間嘅信息交換,提升表示能力。
然而,HC嘅多樣化連接破壞咗原始殘差嘅恆等映射屬性,導致訊號放大/衰減、訓練不穩定(損失曲線突增、梯度範數爆炸)同記憶體存取開銷增加。喺大規模模型訓練中,呢啲問題尤其突出:損失差距(Loss Gap)擴大,梯度範數(Gradient Norm)異常波動,限制咗HC喺萬億參數模型中嘅應用。DeepSeek團隊觀察到,傳統HC嘅無約束映射空間係問題根源,因此提出mHC框架,透過將殘差連接空間投影到特定流形(Manifold)上,恢復恆等映射,同時保持HC嘅多樣性優勢。呢個動機源於對模型拓撲架構設計嘅深入思考,目的係為基礎模型嘅演進提供新路徑。
mHC架構嘅技術細節:流形約束與投影機制
mHC嘅核心係一個通用框架,將HC嘅殘差連接空間約束喺雙隨機矩陣(Doubly Stochastic Matrices)嘅Birkhoff多面體(Birkhoff Polytope)上。雙隨機矩陣滿足行同列之和都為1嘅非負矩陣,確保殘差映射係特徵嘅凸組合(Convex Combination),從而實現訊號均值守恆(Signal Mean Conservation)同範數有界(Bounded Norms)。
Sinkhorn‑Knopp算法係關鍵,佢透過迭代行/列歸一化將矩陣投影到雙隨機流形:
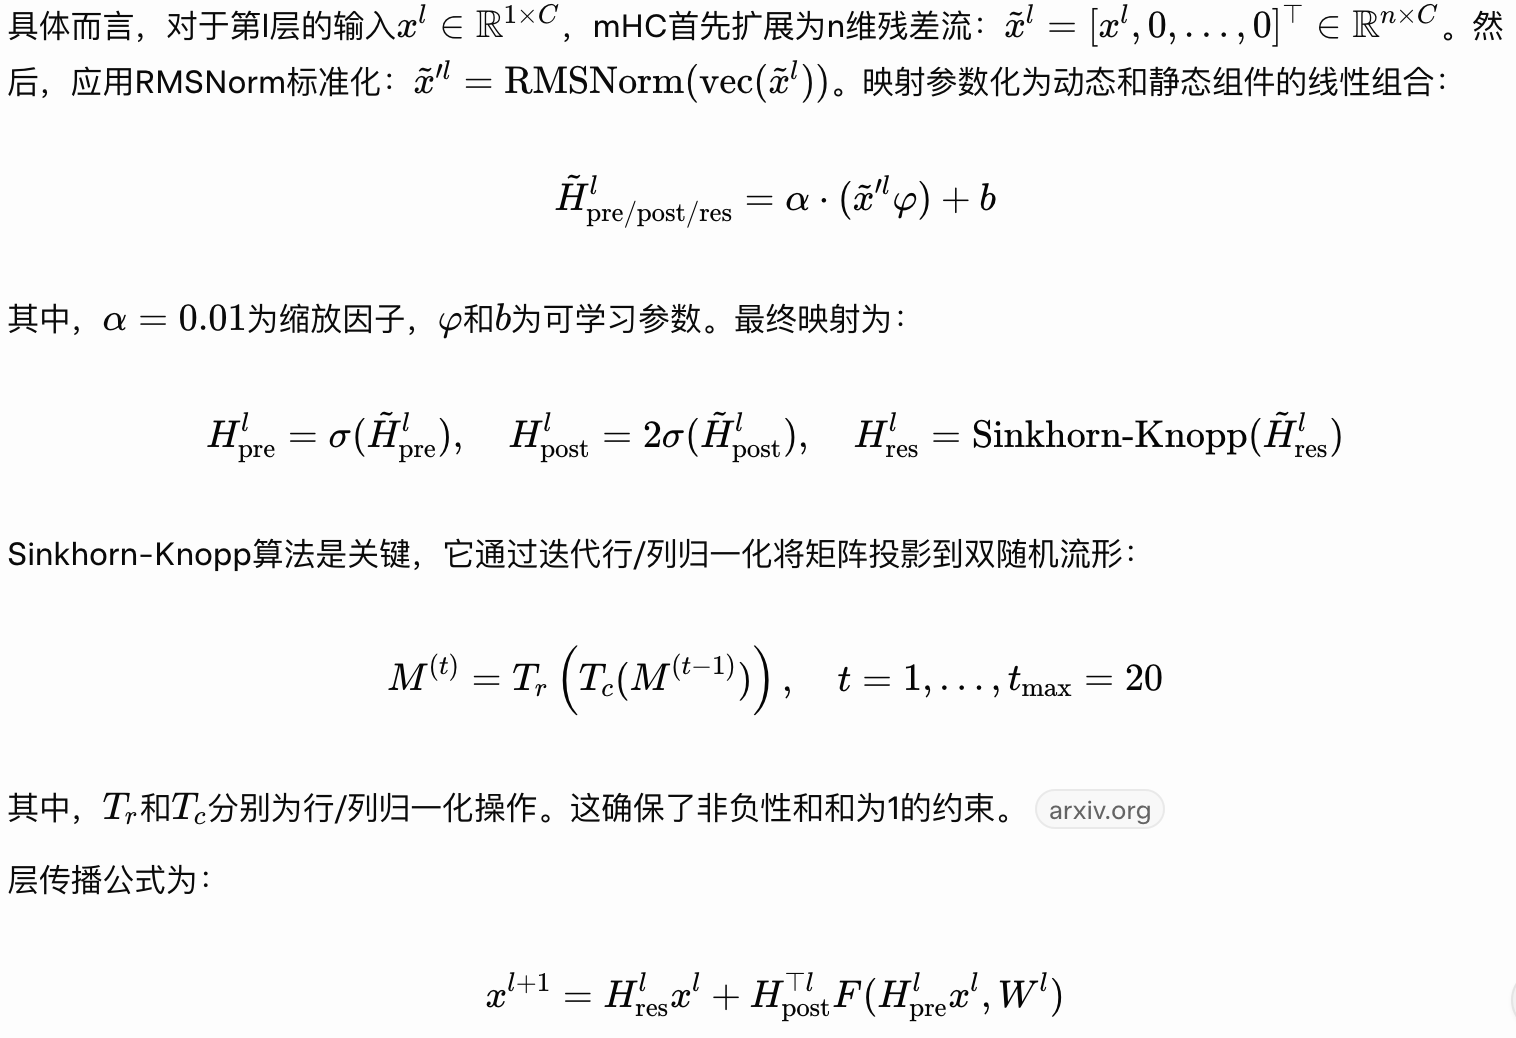
多層組合下:
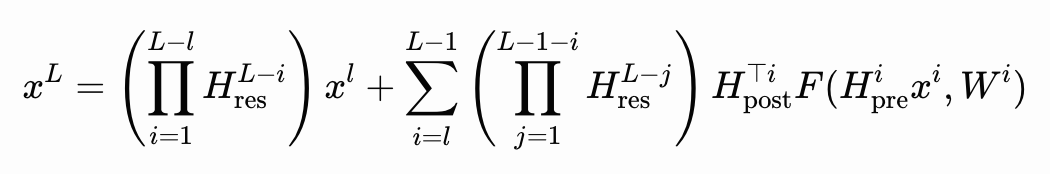
由於雙隨機矩陣嘅組合封閉性(Compositional Closure),乘積矩陣仍然係雙隨機,確保端到端穩定性。mHC嘅凸組合解釋允許特徵融合,同時界定譜範數(Spectral Norm)≤1,避免訊號爆炸。
此外,mHC結合基礎設施優化:內核融合(Kernel Fusion)使用TileLang自定義混合精度內核(bfloat16激活、float32參數);選擇性重計算(Selective Recomputing)每層只儲存一次主殘差,塊大小( L_r^* \approx \sqrt{nL / (n+2)} \);DualPipe擴展透過高優先級計算流重疊通信同計算。呢啲優化令mHC喺n=4時只增加6.7%時間開銷。
實驗設置與結果:大規模驗證嘅性能躍升
論文喺MoE(Mixture of Experts)模型上驗證mHC,模型規模為3B、9B同27B參數,擴展率n=4。數據集按模型大小比例配置(例如27B使用262B tokens),使用AdamW優化器、RMSNorm同RoPE位置編碼。基準包括BBH、DROP、GSM8K、HellaSwag、MATH、MMLU、PIQA同TriviaQA。
結果顯示,mHC顯著提升穩定性:消除HC嘅損失突增同梯度範數波動(論文圖5)。喺性能方面,mHC喺8個基準中均優於基線同HC,例如喺27B模型上,最終損失降低0.021,喺BBH上提升2.1%,DROP上提升2.3%(論文表4)。計算縮放實驗(圖6a)證明mHC喺3B‑27B規模下優勢持續;令牌縮放(圖6b)顯示更多訓練數據會進一步放大收益。傳播穩定性分析(論文圖7)顯示,mHC嘅最大增益幅度(Amax Gain Magnitude)由HC嘅約3000降到約1.6。映射可視化(論文圖8)證實mHC避免咗HC嘅極端值。
與基線相比,mHC喺下游任務中平均提升1‑2%;與HC相比,避免咗不穩定,實現更好嘅收斂。記憶體分析(論文表2)顯示,透過重計算,mHC峰值記憶體只係基線嘅1.05倍。
局限性與未來方向
儘管創新,mHC仍然有局限:Sinkhorn‑Knopp有限次迭代會導致輕微偏差;擴展率n會增加記憶體存取;重計算塊需與管道階段對齊;只探索咗雙隨機流形,其他流形未被驗證。未來,研究者可以擴展到其他流形,或者應用喺更大嘅模型例如萬億參數級。arxiv.org
影響與意義:AI架構設計嘅啟示
梁文鋒署名嘅呢篇論文,唔單止係DeepSeek喺開源生態中嘅又一貢獻,仲為大模型訓練提供咗實用框架。作為DeepSeek‑V3嘅延續,mHC有望被整合入未來模型中,提升穩定性同效率。IT之家報道話,呢種架構「暴力優化AI架構」,喺27B參數模型上只增加6.7%開銷,卻顯著降低損失。喺全球AI競賽中,中國團隊嘅創新凸顯自主技術嘅崛起。
總體嚟講,mHC透過流形約束深化咗對拓撲設計嘅理解,推動基礎模型由規模競賽向架構優化轉型。呢篇新年論文預示住2026年AI將迎來更穩定、可擴展嘅時代。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請訪問: https://www.airosetta.com