
一項睇落好基本嘅數學計算問題,可能會影響大規模模型訓練嘅穩定性。Google DeepMind 研究人員發現,長期廣泛使用嘅 Softmax 同交叉熵實現,喺特定浮點精度條件下會產生錯誤梯度。更值得注意嘅係,Gemini 唔單止參與發現問題,仲負責實驗驗證同撰寫論文嘅工作。
2026年10月下旬,Google DeepMind 嘅研究人員 Jonathan T. Barron、Dan Gnanapragasam 同 Michael Tschannen 喺 arXiv 發佈咗論文《Fixing Softmax and Cross‑Entropy》。論文指出,深度學習入面兩個幾乎無處不在嘅基礎運算——Softmax 同交叉熵(Cross‑Entropy)——喺常見實現方法中存在兩個隱蔽嘅數值精度問題。
呢啲問題並唔係傳統意義上公式錯誤,而係數學上等價嘅計算表達式,喺計算機有限精度嘅浮點運算中會得出唔同結果。佢哋喺普通訓練過程中可能好難察覺,但當模型預測變得極度自信,或者學生模型已經非常接近教師模型時,細微嘅捨入誤差就可能改變梯度,進而影響優化過程。
一、兩個基礎函數點解會出現數值漏洞?
要理解呢項研究,首先要了解 Softmax 同交叉熵喺神經網絡訓練嘅作用。
Softmax 會將模型輸出嘅 Logits 轉換成機率分佈,交叉熵用嚟衡量模型預測同目標分佈之間嘅差異。兩者結合,構成分類模型同大語言模型訓練中最常見嘅損失計算路徑之一。
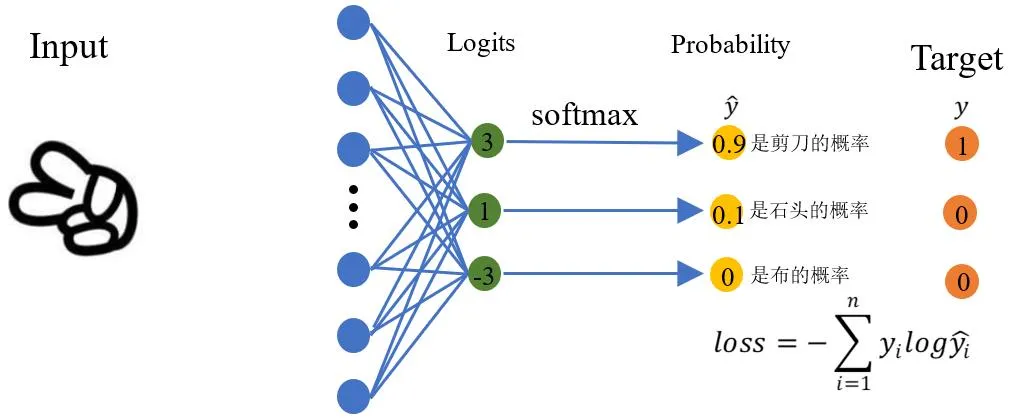
理論上,Softmax 嘅計算形式為:
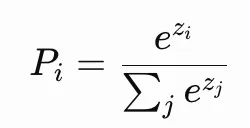
其中,Zi 係模型輸出嘅 Logit,Pi 係對應類別嘅預測機率。為咗避免指數運算溢出,工程實現通常會先減去最大 Logit,再進行指數運算。
呢個喺數學上等價、數值上通常較穩定嘅做法。不過研究人員發現,即使採用呢種常見技巧,喺浮點數精度有限嘅情況下,仍然可能出現兩個問題。
1. Softmax Collapse:正確類別嘅梯度意外歸零
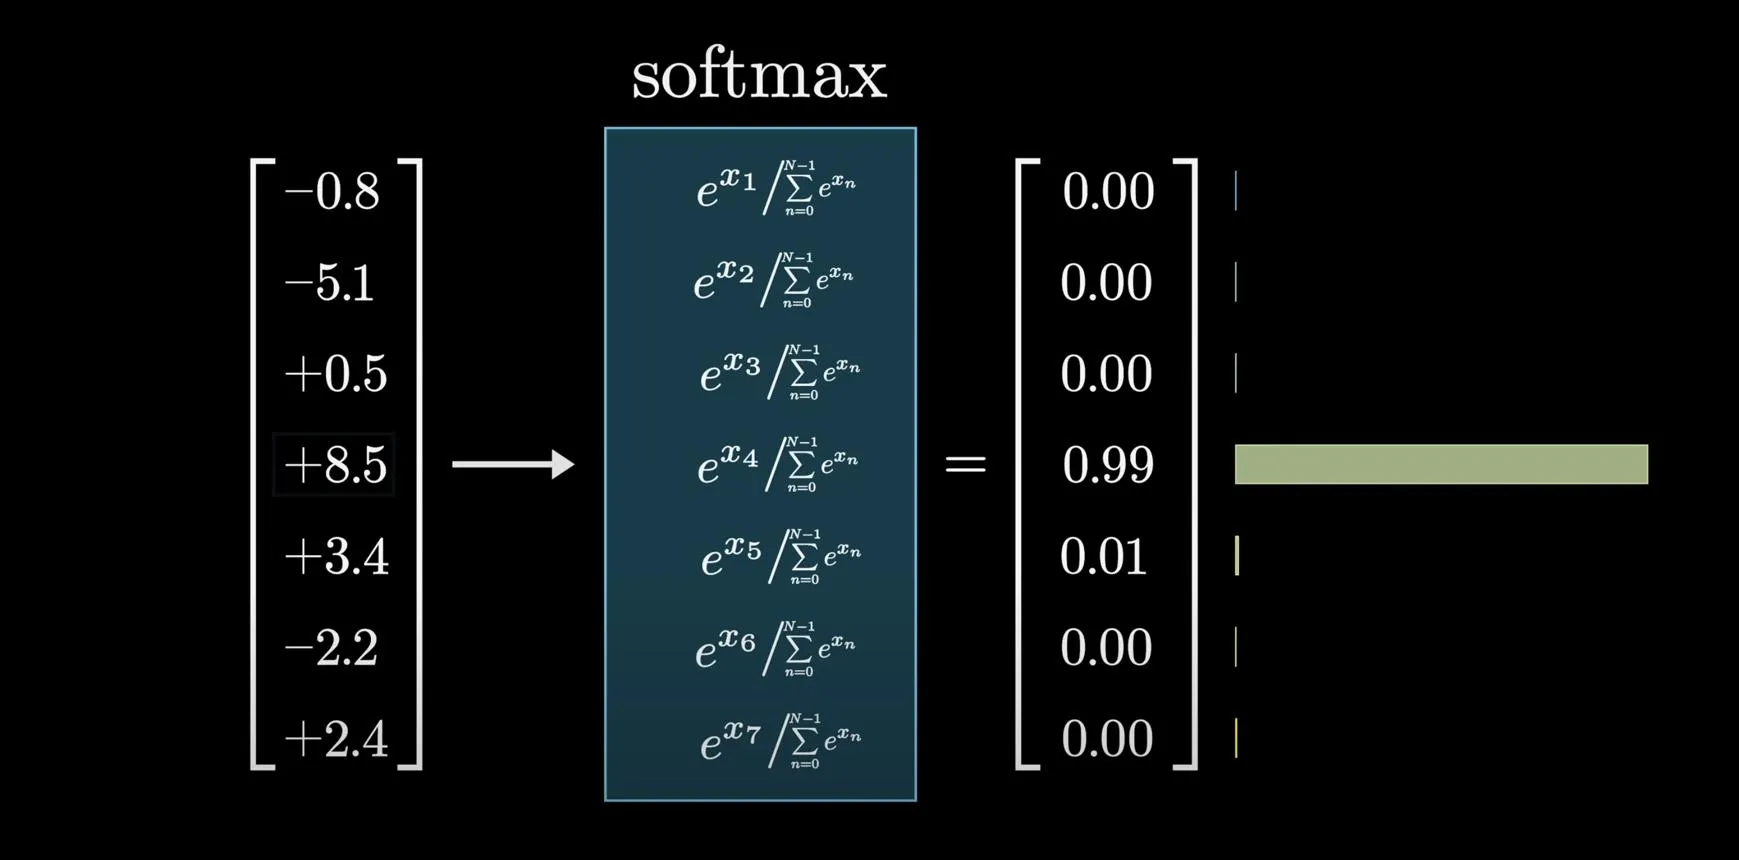
當模型訓練到一定階段,對正確類別嘅預測可能變得極度自信,機率接近 1,而其他類別嘅機率接近 0。
問題係,浮點數唔可以無限精確地表示接近 1 嘅數值。當計算結果同 1 之間嘅差異細到低於當前資料類型能夠表示嘅精度時,呢個差異就可能被直接捨入掉。
例如,喺論文討論嘅特定計算條件下,bfloat16 同 float32 喺 Logit 差值達到某程度後都可能出現呢種現象。
結果就係,正確類別對應嘅梯度可能被計算為 0,而錯誤類別嘅梯度仍然存在。呢樣破壞咗 Softmax 梯度應該滿足嘅數學性質,亦可能令優化器收到唔一致嘅更新訊號。
呢種異常亦可能同訓練過程中觀察到嘅損失突然波動、優化唔穩定等現象有關。研究特別討論咗所謂嘅 Slingshot Effect(彈弓效應)。
需要強調嘅係,呢個唔代表所有使用 bfloat16 或 float32 嘅模型都會發生呢個問題。佢取決於具體嘅 Logit 分佈、計算路徑同數值精度。
2. Softmax Cancellation:模型已經接近正確答案,但仍會產生錯誤梯度
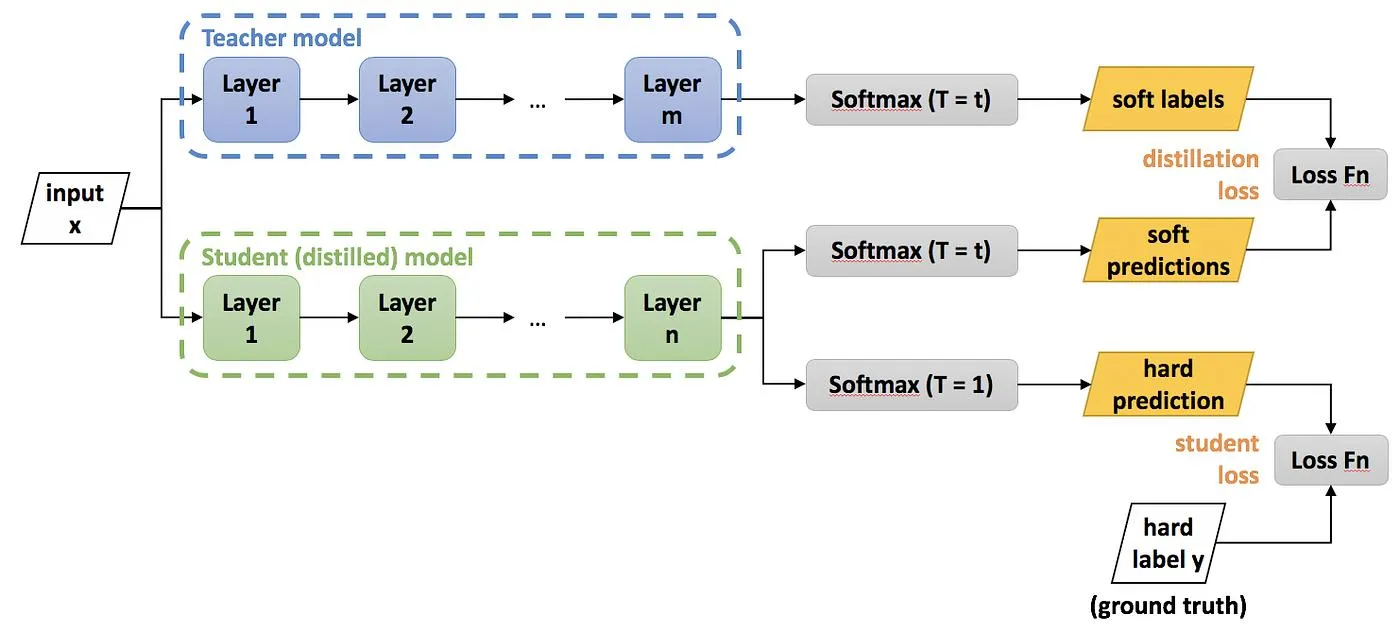
第二個問題主要出現喺知識蒸餾(Knowledge Distillation)當中。
知識蒸餾嘅基本思路係令一個較細嘅學生模型學習教師模型輸出嘅機率分佈,而唔係只學最終正確嘅標籤。
理想情況下,當學生模型嘅輸出已經同教師模型完全一致時,損失應該達到最小值,梯度亦應該係零。
但研究人員發現,標準計算方式喺某啲情況下會因浮點數捨入誤差,產生本來唔應該存在嘅非零梯度。
呢個即係話學生模型明明已經接近教師模型,優化器卻仲收到一個錯誤嘅更新方向,令學生模型反而偏離教師模型。
對於依賴知識蒸餾做模型壓縮、能力遷移同後訓練嘅系統嚟講,呢種誤差尤其值得關注。
二、問題根源:數學等價唔代表喺電腦入面結果等價
呢項研究最有價值嘅地方,在於佢揭示咗一個工程實務經常忽略嘅事實:數學公式正確,並唔代表佢喺有限精度嘅電腦環境中一定能夠得到正確嘅數值結果。
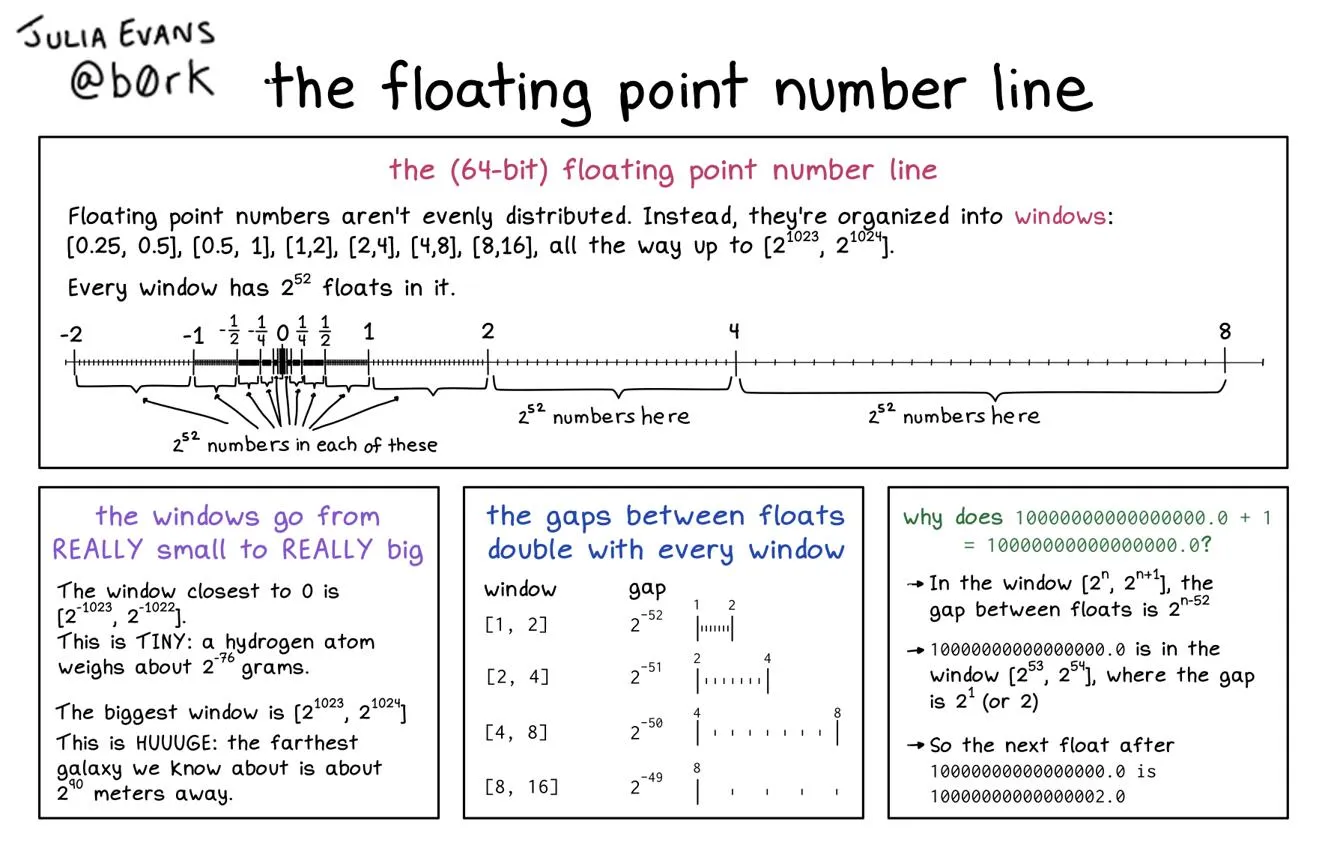
浮點數用有限位數表示實數,所以無法精確表示所有數值。特別係喺接近 1.0 嘅區域,兩個數學上唔同嘅數值喺低精度格式中可能會被捨入為相同嘅結果。
呢個會帶來兩個後果:
第一,原本非常細但真實存在嘅梯度可能被捨入為零。
第二,兩個本應相互抵消嘅數值喺計算過程中可能因捨入順序不同而留下誤差。
呢啲都解釋咗點解相同嘅數學公式,喺唔同資料類型、計算順序同硬件環境下,可能產生唔同嘅訓練結果。
隨住大語言模型越嚟越多使用 bfloat16、FP16,以及某啲場景中嘅 FP8 等低精度計算格式,呢類問題嘅重要性亦都上升。
三、Gemini 唔止係幫手寫代碼,佢仲參與咗問題發現
呢項研究另一個引人關注嘅地方,係 Gemini 喺研究過程中嘅角色。
根據論文作者 Jonathan T. Barron 嘅公開說明:
- 問題發現: Softmax Cancellation 最初由 Gemini Flash 3.7 發現,並提出咗修復方案。
- 實驗驗證: 論文中嘅大部分實驗由 Gemini Flash 3.8 完成。
- 論文撰寫: Gemini 4 Argon 參與撰寫咗論文初稿同製作圖表。
- 研究把關: Barron 則主要負責審查、質疑同驗證研究結論,確保論文內容經得起嚴格檢驗。
如果呢啲分工按作者嘅公開說明記錄得準確,咁呢個就係一個具代表性嘅案例:AI 唔單止喺幫人類使用機器學習技術,佢開始參與檢查同改進機器學習本身嘅底層計算方法。
值得注意嘅係,Gemini 並冇取代研究人員嘅數學判斷同實驗驗證。真正有意義嘅係,人類研究者同 AI 模型形成咗一個新嘅研究協作流程:由模型提出問題、探索解法並執行大量實驗,再由研究人員審查同確認結果。
四、修復方案:唔需要提高精度,關鍵係改變計算方式
研究團隊冇揀簡單提高浮點計算精度,亦冇重新設計 Softmax 或交叉熵嘅數學定義,而係透過調整計算表達式同運算順序,減少數值誤差。
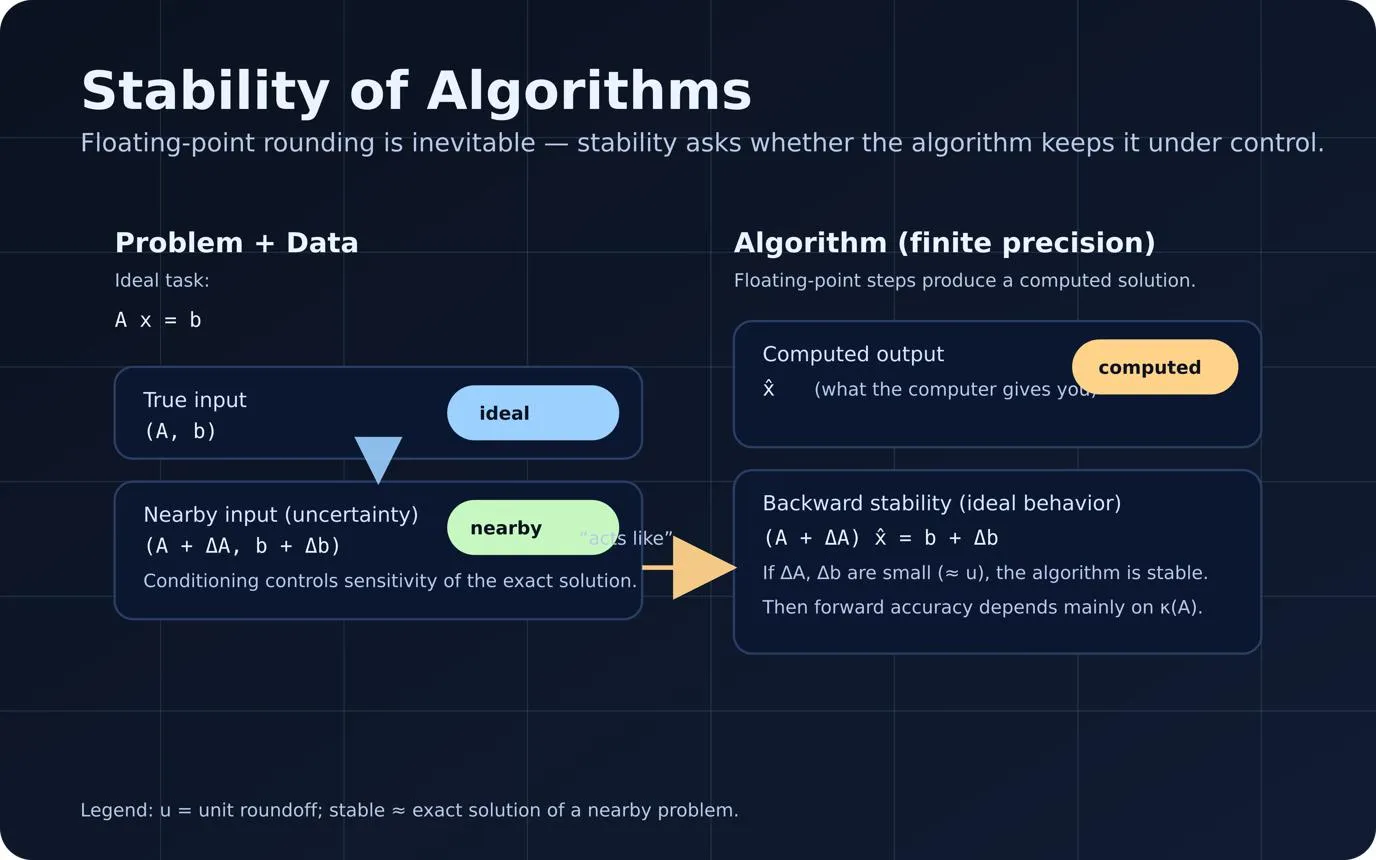
論文採用咗包括 softplus、expm1 同 log1p 喺內嘅數值穩定函數。
呢啲函數嘅共同特點,係針對特定數值範圍優化計算方式,避免直接做啲容易造成精度損失嘅運算。
例如:
expm1(x)計算 ,喺 好細嘅時候比直接計算指數再減 1 更準確。log1p(x)計算 ,喺 好細嘅時候可以減少有效數字損失。softplus(x)就提供咗一個對 Softmax 相關計算更穩定嘅表達方式。
研究團隊喺模加法(Modular Addition)等 Grokking 測試任務中驗證咗修復效果。根據論文畀出嘅實驗結果,喺相關 bfloat16 測試條件下,標準實現嘅準確率約為 93.3%,而修復後嘅實現達到 100%,訓練過程亦更加穩定。
喺知識蒸餾實驗中,修復後嘅計算方式可以避免學生模型同教師模型完全一致時出現本不應有嘅殘餘梯度。
另外,獨立工程師亦喺 PyTorch 環境中復現咗相關問題,並驗證咗修復方案嘅有效性。
五、呢項研究對大語言模型意味住乜嘢?
Softmax 同交叉熵唔係某個特定模型嘅專屬組件,佢哋係現代深度學習系統中嘅基礎計算原語。特別係喺大語言模型訓練中,Softmax 唔單止喺分類任務出現,亦直接參與模型輸出機率分佈嘅計算。
所以,呢項研究嘅意義唔止係修復兩個函數,而係提醒整個 AI 工程界:模型能力嘅提升,唔單止取決於網絡結構、訓練數據同參數規模,亦取決於底層數值計算係咪夠可靠。
不過,要對影響範圍保持客觀判斷。日常模型推理通常唔會因為呢兩個問題直接受到明顯影響;真正值得關注嘅係大規模預訓練、低精度訓練、知識蒸餾同特定後訓練任務。至於主流框架會唔會將論文中嘅修復方式做為預設實現,仲要觀察 PyTorch、JAX、TensorFlow 等項目後續嘅代碼更新。
六、比修復兩個 Bug 更重要嘅變化:AI 開始反過來改進 AI
呢項研究令我覺得,真正值得關注嘅唔只係 Softmax 同交叉熵有數值漏洞,而係 AI 研發模式可能正喺發生變化。
過往,深度學習系統嘅開發主要靠人類研究員提出理論、寫代碼、設計實驗,再用大量計算資源驗證假設。AI 模型多數係研究對象同工具。
而家,前沿模型已經可以參與數學問題探索、代碼分析、實驗設計、結果比較,甚至發現研究員長期冇注意到嘅底層問題。
呢個形成咗一個新嘅閉環:
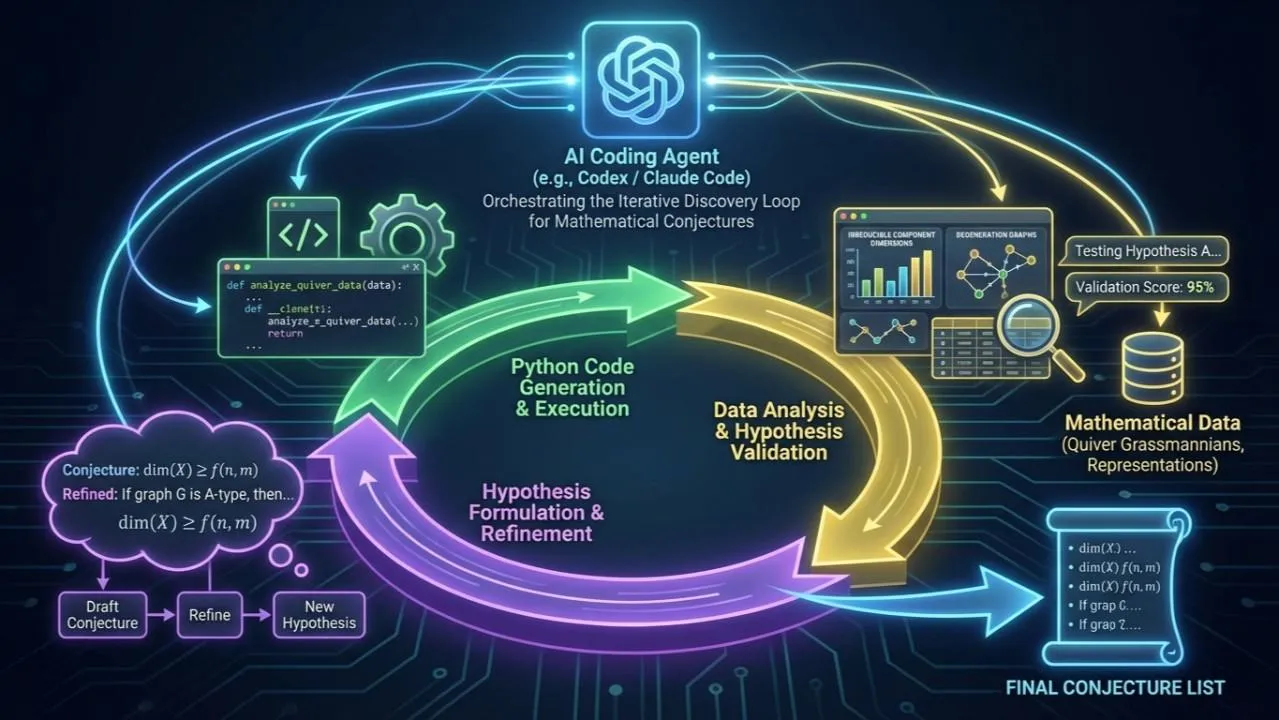
AI 模型參與發現問題 → AI 輔助提出修復方案 → 自動化實驗驗證 → 人類研究人員審查 → 改進 AI 訓練基礎設施 → 進一步提升 AI 能力。
呢個並唔代表 AI 已經可以獨立完成可靠嘅科學研究,但佢顯示出 AI 正喺由單純嘅應用工具,逐步轉為科研同工程系統中嘅主動參與者同重要幫手。
如果將來 AI 唔止能夠優化模型結構同訓練參數,仲可以持續發現底層算法、數值計算同硬件使用方面嘅問題,咁佢對自身發展速度嘅推動,可能遠超單純增加模型參數或訓練數據帶來嘅收益。
由呢個角度睇,Gemini 參與修復 Softmax 同交叉熵,唔只係一次數值計算問題嘅修復,仲係 AI 開始參與改進自身技術基礎設施嘅一個值得關注嘅信號。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com