
2026年10月24日前後,Jack Dorsey(杰克·多西)旗下嘅 Block 公司正式公布咗全新語音模型Dessa。呢個模型由 Block 內部一個細規模嘅 AI 研究實驗室開發,核心主張好鮮明:完全以人類語音對話數據由零開始訓練,唔依賴任何文本語料,亦無使用預訓練嘅大型語言模型作為底座;支援全雙工(full‑duplex)即時對話,可喺消費級裝置本地運行,並展現笑聲、停頓、哭泣、嘆息等豐富情感同自然韻律。
目前,Dessa 以研究預覽(research preview)形式發佈,優先向 AI 安全研究人員開放早期訪問,並設有公開候補名單。官方尚未公布模型權重、API 介面或商業定價。
技術定位:語音對語音,跳過文本中介
與現時主流語音助手唔同,Dessa 採用真正嘅 speech‑to‑speech 架構——音頻輸入,音頻輸出,中間無「語音轉文字→大模型生成→文字轉語音」嘅傳統流水線。Block 強調,呢種設計可以更好保留語音入面嘅情感、諷刺、停頓同副語言信息,而呢啲信息喺經過文本中介時通常會大量流失,令現有語音 AI 聽落生硬、延遲感明顯。
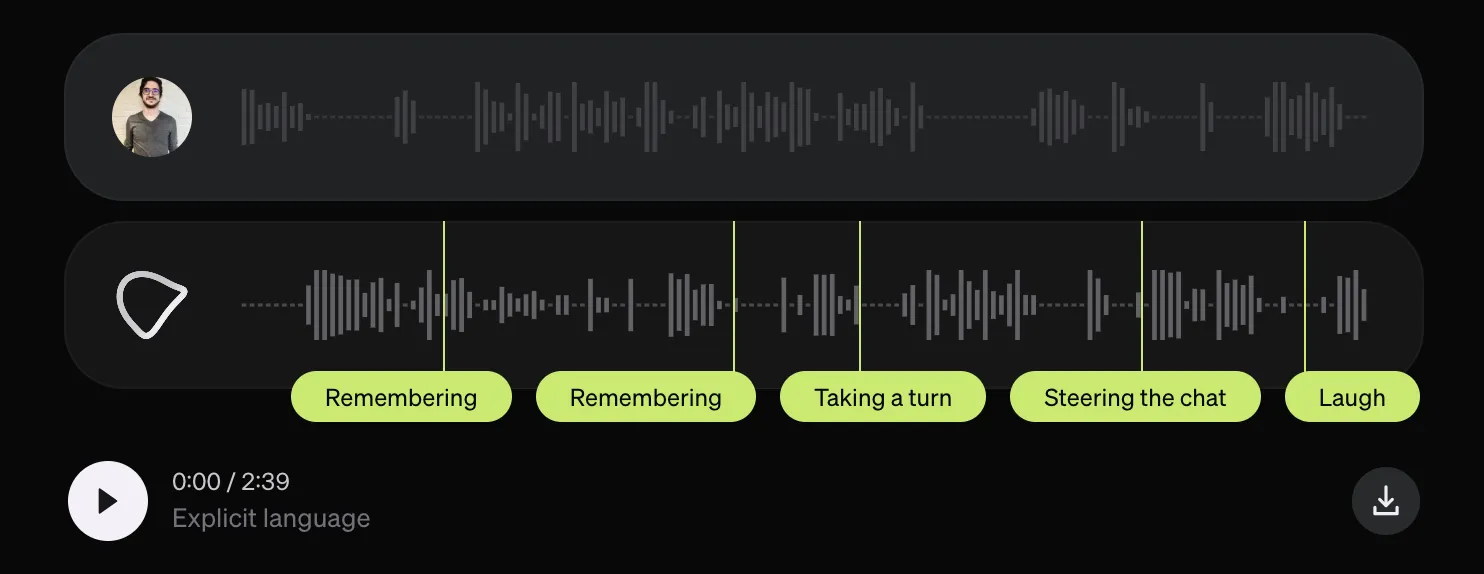
模型支援全雙工通訊,即喺講嘢嘅同時持續傾聽,能自然插話、發出「yeah」「got it」等反饋信號,模擬真人對話中嘅互動節奏。官方示範音頻中,Dessa 展現笑聲、哽咽、語氣變化等表現,部分對話甚至被形容為「略顯尷尬但更似真人」嘅風格。
訓練方面,Block 表示 Dessa 完全喺人類對話錄音上由零訓練,使用「比大語言模型少數百倍嘅詞量」,並喺單台 NVIDIA GB200 NVL72 機架(約 72 粒 Blackwell GPU)上完成。推理可喺 MacBook Pro M4 Max 或更高配置上本地運行,且聲稱速度快過實時。
團隊背景與發佈方式
Dessa 來自 Block 內部一個極細規模嘅研究實驗室,由前 Dessa(多倫多深度學習初創公司,2020 年被 Square/Block 收購)成員組成。實驗室負責人 Ragavan Thurairatnam 表示,團隊自 2012 年起從事深度學習,專注生成式語音模型已逾八年,直接向多西匯報。多西本人亦喺 X 平台轉發並稱其為「有史以嚟最真實嘅全雙工語音模型」,同時強調其體積之細——可喺 MacBook 上運行。
喺發佈形式方面,Block 並未同步放出技術報告、參數規模、訓練數據量或公開基準測試,而係以官方網站示範錄音同候補名單為主。早期訪問優先面向安全研究人員,目的係先發現潛在風險(例如聲音欺騙、情感操控等)。
客觀評估與潛在意義
Dessa 嘅核心賣點係「純語音訓練」同「本地可運行」。如果其聲稱屬實,代表一種同主流「文本大模型+TTS」路徑截然不同嘅技術路線:直接由語音中學習語言同互動模式,可能喺情感表達同自然度方面更有優勢,同時降低對雲端大模型嘅依賴。
對用戶同開發者嚟講,本地部署意味住更低延遲、更高私隱性同離線可用性,喺支付、客服、個人助理等場景具有實際價值。Block 作為 Square 同 Cash App 嘅母公司,未來有機會將呢類能力融入佢嘅金融與社交產品。
不過,客觀嚟睇,目前仍有明顯資訊缺口:
- 缺乏獨立基準測試同第三方驗證,真實對話質素、魯棒性與多語言能力尚待檢驗;
- 未公開參數量、訓練數據規模與具體架構,難以評估其與現有語音模型嘅相對水平;
- 目前僅限研究預覽,距離大規模可用仍有距離;
- 純語音訓練雖可能保留更多情感線索,但喺知識廣度、邏輯推理與事實準確性方面,可能不如依賴大量文本預訓練嘅模型。
此外,高度逼真嘅情感語音亦會帶來新嘅安全與倫理問題——例如聲音克隆、情感操控或詐騙風險。Block 主動邀請安全研究人員介入,本身即承認咗呢個潛在隱憂。
行業背景與展望
目前語音 AI 正由「識聽識講」向「更自然、更情感化、更即時」進化。OpenAI 嘅 GPT‑Live 等全雙工模型已推動即時互動體驗,而 Dessa 選擇由「完全跳過文本」嘅路徑切入,嘗試由根本解決情感流失同延遲問題。佢哋細規模團隊、相對有限嘅算力投入卻聲稱達到可用對話水準,亦引發咗關於語音模型是否需要巨量文本數據嘅討論。
總體嚟講,Dessa 係一次有明確技術主張嘅發佈:用純人類語音數據訓練、追求本地運行同情感真實感。佢能否真正改變語音互動範式,仍取決於後續公開嘅技術細節、獨立評測結果,以及由研究預覽走向實際產品嘅落地進度。喺 AI 語音賽道日益擠迫嘅情況下,Block 選擇以「更細、更本地、更似人」嘅差異化路徑參與競爭,本身就係一個值得持續關注嘅信號。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎追蹤我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請訪問:https://www.airosetta.com