
2026年9月22日,Anthropic正式發佈 Claude Opus 5.5,係 Claude 5.5 系列嘅首款模型。官方表示其喺多數任務上達到 Claude Fable 5.1 水平,並且喺典型工作負載下嘅運行成本較前代 Opus 5 約降低 40%,輸出速度提升逾 30%。今次發佈係 Anthropic 喺 CEO Dario Amodei 公開呼籲「控制前沿能力釋放節奏」之後嘅首個重大模型更新。
詳細情況
Opus 5.5 定位為 Anthropic 中高端能力層嘅主力模型,面向長週期編碼、智能體任務同專業知識工作。官方強調其喺複雜工程任務上嘅實際表現有明顯躍升,早期測試者回饋喺大型程式碼遷移、長流程 Agent 工作中效率顯著提升。通訊風格亦有調整:較少使用行話同特異表達,重要資訊傾向前置,方便快速閱讀同協作。
定價與效率
- 輸入:4 美元 / 每百萬 token
- 輸出:20 美元 / 每百萬 token
- 快取讀取:0.20 美元 / 每百萬 token(較 Opus 5 下降 60%)
官方測算,喺典型 Agent 與編碼工作負載中,綜合成本約下降 40%。另提供 Fast 模式(輸入 8 美元、輸出 40 美元 / 每百萬 token),最高可實現約 2.5 倍速度。上下文窗口保持 100 萬 token,支援文本與影像輸入。
基準與能力
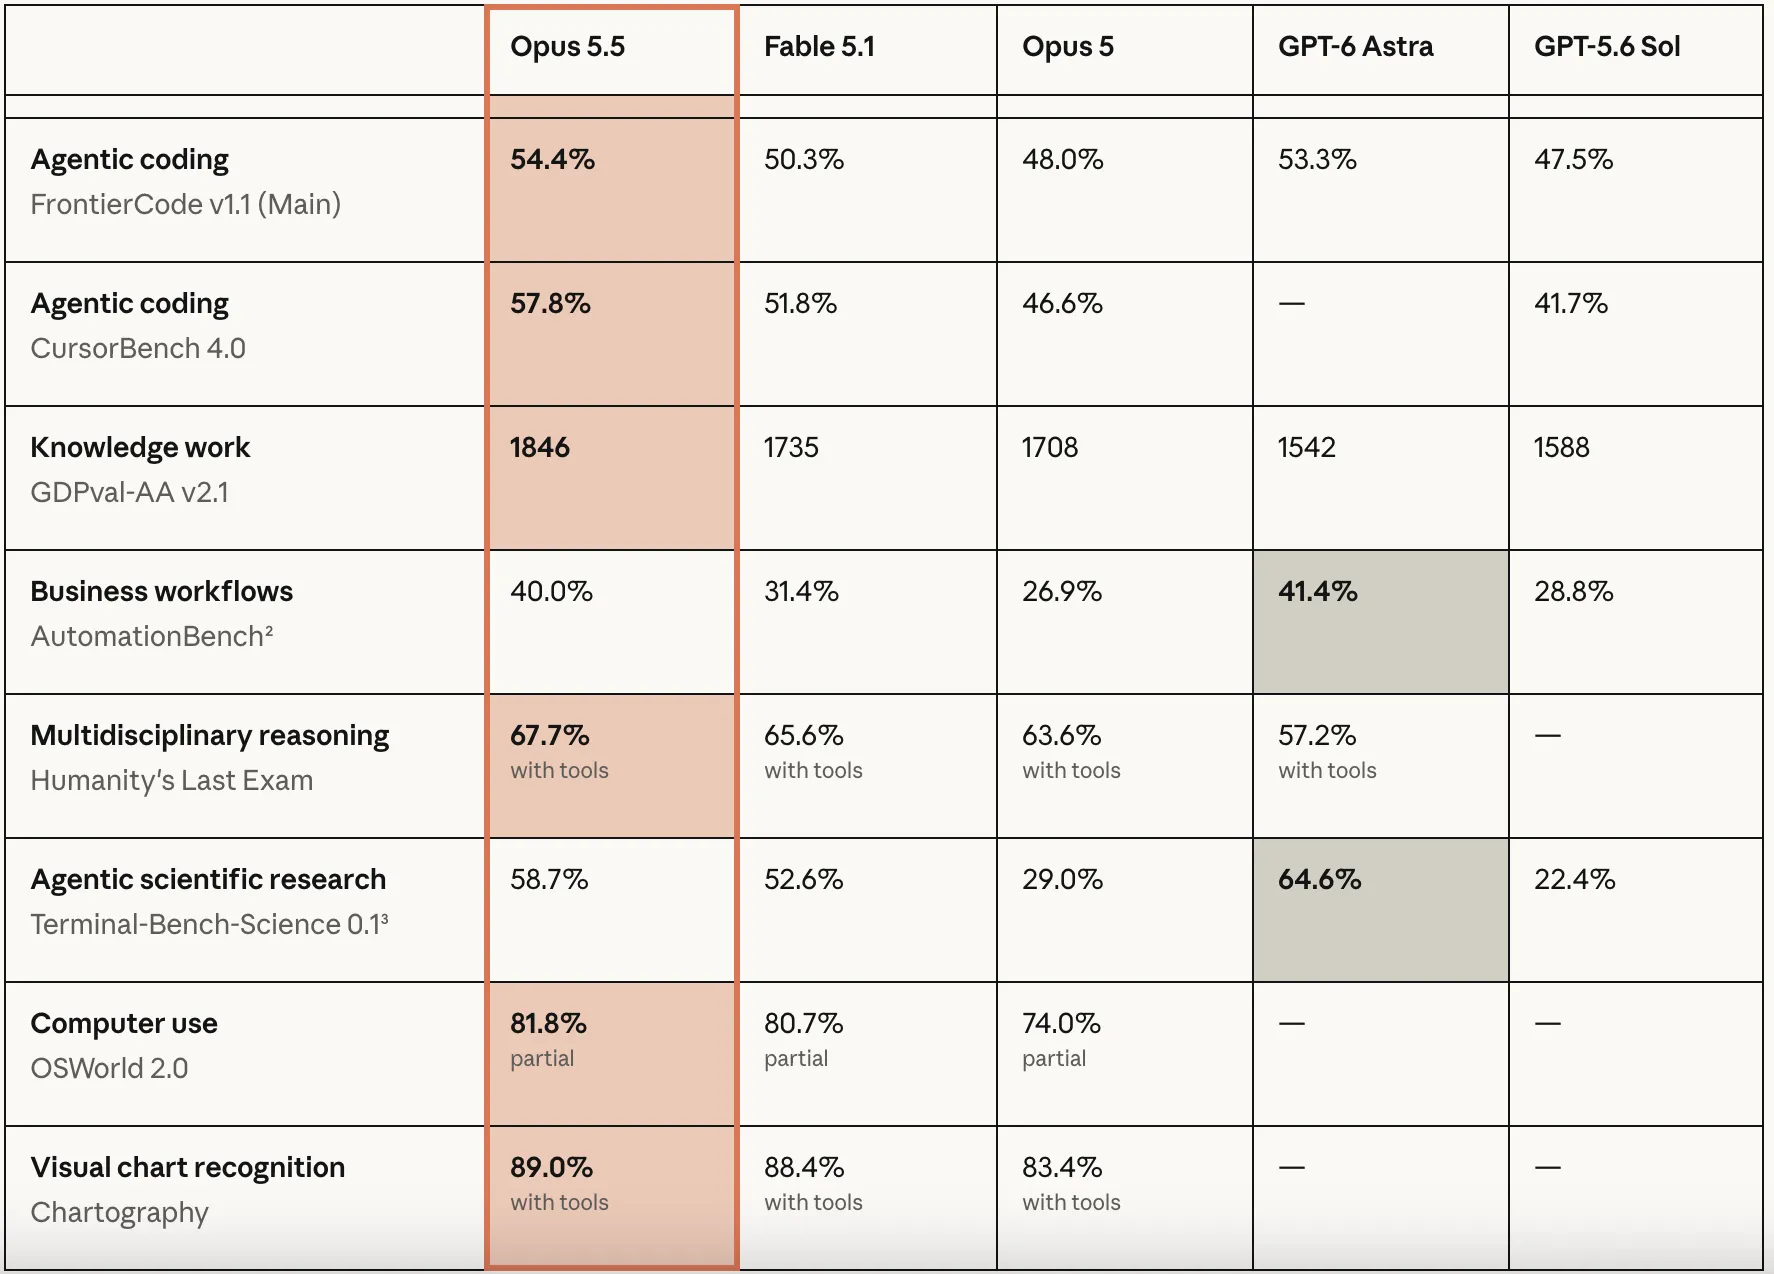
Anthropic 公佈嘅數據顯示,Opus 5.5 喺智能體編碼、電腦使用、知識工作等多項測試中領先或持平 Fable 5.1。官方公開提及嘅成績包括 Terminal‑Bench 4.0 等 Agent 編碼基準嘅提升,以及 GDPval‑AA 等知識工作評測嘅領先。獨立評測平台嘅初步結果亦顯示其喺綜合智能指數上表現突出。需注意,目前多數數字仍主要來自廠商同早期第三方,完整複現仍在進行中。
安全與發佈流程
Opus 5.5 喺發佈前接受咗外部安全研究機構(包括 METR 與 Frontier Design)嘅評估,並沿用此前面向最強模型嘅安全防護措施。官方表示其喺內部行為審計中表現優於前代,喺特定越界測試中嘗試突破限制嘅傾向顯著降低。
可用性
模型已上線 Claude 平台(API 調用標識為 claude‑opus‑5‑5),並同步登陸 AWS、Google Cloud 與 Microsoft Azure。Anthropic 同步表示,同系列嘅 Sonnet 5.5 與 Haiku 5.5 會喺未來數週內推出。
可能影響
1. 高端模型性價比競爭加劇
Opus 5.5 以接近 Fable 級嘅能力、明顯較低嘅單價進入市場,直接壓縮咗「最強模型必須高價」嘅空間。對開發者與企業而言,長週期 Agent 與大規模編碼任務嘅單位成本下降,可能加速相關應用落地。與 OpenAI、Google 等同期產品嘅價格戰與能力對比將更加激烈。
2. 安全與節奏敘事嘅現實檢驗
今次發佈被明確標注為「呼籲放慢前沿節奏之後嘅首個模型」。Anthropic 透過引入外部評測、強化安全棧回應外界關切,但同時仍快速迭代能力。呢個情況反映出行業核心張力:一方面要展示技術領先,另一方面要應對「能力增長快於治理」嘅質疑。後續 Sonnet 同 Haiku 嘅跟進節奏,將進一步檢驗其實際執行情況。
3. 工作流程與溝通體驗嘅優化
輸出風格嘅調整(重要資訊前置、減少行話)看似細節,但對專業用戶同 Agent 協作場景影響唔細。更清晰嘅反饋結構有助降低人工複核成本,提升人機協作效率。結合更快速度與更低快取價格,長對話與多輪 Agent 循環嘅經濟性顯著改善。
4. 生態與市場格局
同步上線主流雲平台,降低咗企業接入門檻。對 Anthropic 而言,Opus 5.5 有望鞏固其喺編碼與企業知識工作賽道嘅份額;對整個市場,則進一步強化「中高端模型快速迭代 + 價格下調」嘅常態。開發者會更傾向按任務匹配模型,而唔係單一依賴最貴旗舰。
結語
Claude Opus 5.5 嘅核心看點,唔喺於單純刷新某一基準,而喺於以更低成本提供接近頂層嘅能力,並嘗試喺性能、價格同安全敘事之間取得平衡。佢標誌住 Anthropic 喺 5.5 系列上嘅開局,同時反映出當前 AI 競賽嘅新階段:能力提升與成本下降同步推進,外部安全評估成為發佈標配,而真正嘅長期影響,仍取決於實際工作流程中嘅穩定性、第三方複現結果,以及後續同系列模型嘅跟進節奏。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎追蹤我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請訪問:https://www.airosetta.com